AI-NATIVE 시리즈 · 아키텍처
하나의 루프, 마흔한 개의 서브커맨드: 도구가 잡동사니 상자가 되지 않고 성장하는 법
내가 관리하는 도구에는 마흔한 개의 서브커맨드와 하나의 제어 루프가 있다. 엔진은 109줄에 불과하다. 기능을 추가하려면 함수 세 개만 더하면 된다. 여기 그 구조, 실제 적용 사례, 그리고 애드온 시스템이 썩지 않게 막는 세 가지 규칙을 소개한다. 이 중 어느 것도 도구 자체를 요구하지 않는다.
1분 요약
이 글에서 다루는 것: 41개의 서브커맨드로 성장했지만, 서로 무관한 기능 덩어리로 흩어지지 않은 개인용 AI 도구의 구조 — 하나의 공유 제어 루프와, 그 위에 얹히는 기능들.
이게 중요한 이유: 잡동사니 상자가 되는 실패는 코딩의 문제가 아니다. 성장하는 모든 시스템 — 팀, 커리큘럼, 회사의 프로세스 — 에서 새로운 요구마다 별도의 기계를 만들면, 기존 구조를 활용하지 못하고 각자 따로 놀게 된다.
당신이 할 수 있는 것: 이번 주에 고민 중인 결정을 네 가지 항목으로 써보고, 손으로 간단한 수식을 계산해보라. 20분이면 충분하다. 아마도 당신의 계획이 생각보다 더 허약한 근거 위에 서 있음을 발견하게 될 것이다.
맥락: 핵심은 하나의 루프이며, 이 글은 내 도구 자체에 관한 이야기가 아니다
아래의 모든 내용은 하나의 코드베이스에서 가져왔지만, 정작 그 코드베이스 자체에 대한 이야기는 거의 없다. 이 도구는 비공개라 설치할 수 없고, 바로 그 점이 내가 이 글을 쓸 때 세운 정직한 제약이다. 만약 글의 가치가 독자가 그 도구를 직접 써보는 데 달려 있다면, 그건 광고지일 뿐이다. 그래서 내가 스스로에게 부여한 기준은, 여기서 제시하는 모든 원칙이 다음 문장을 견뎌야 한다는 것이었다."…and I will never see that repository."(번역: "…그리고 나는 그 저장소를 영원히 볼 일이 없다.")
이 글에서 다루는 문제는 이미 당신이 겪고 있는 일이다. 당신은 점점 커지는 무언가를 관리한다 — 코드베이스, 팀의 운영 절차, 강의 커리큘럼, 혹은 가정의 시스템. 새로운 요구는 언제나 특별해 보인다. 그리고 매번 가장 손쉬운 해결책은 그 요구마다 별도의 기계를 하나씩 만드는 것이다.
실패 방식: 필요할 때마다 새 기계를 만든다
이 실패에는 분명한 패턴이 있다. 새로운 요구가 들어올 때마다 각자 고유한 기계를 만든다: 자기만의 루프, 자기만의 재시도 규칙, '완료'의 기준도 제각각, 옆에 있는 로깅과 미묘하게 다른 로깅까지. 하나로 충분할 자리에 여섯 개의 엔진이 생긴다. (주방에 비유하면, 각자 모터가 달린 단일 용도 가전제품들이 조리대를 점령한 모습이다. 사실 스탠드 믹서 하나에 단순한 부속만 바꿔도 충분하다. 물론 이 비유는 논지의 입구일 뿐이니, 여기까지만 언급하겠다.)
누구도 일부러 잡동사니 서랍을 만들겠다고 결심하지 않는다. 잡동사니 서랍은, 아무도만들지 않겠다고딱히 결정하지 않았을 때 자연스럽게 생긴다. 문제는 어수선함이 아니라, 무엇 하나를 개선해도 그 하나만 나아진다는 데 있다. 엔진을 공유하면, 모든 기능이 한 번에 좋아진다.
압축: 네 가지 기능이 사실 네 벌 옷을 입은 하나였다
이 이야기의 전환점은 기발한 발상이 아니다. 내 코드를 읽다가 발견한 지극히 평범한 사실이다.
서로 다른 네 개의 루프가 있었다 — 생성된 앱을 개선하는 것, 코드베이스를 리팩터하는 것, 산출물을 리버스 엔지니어링하는 것, 제품에 대한 모호한 불만을 캐내는 것. 네 개의 서로 다른 영역, 몇 달 간격으로 작성되어 완전히 무관해 보였다.
사실은 같은 함수였다. 비슷한 정도가 아니라 —정말 똑같았다. 네 군데 모두에 글자 하나 틀리지 않고 등장하는 방어 조건까지 동일했다. 반복 횟수가 0이면 거부하는 그 조건을 나는 네 번이나 별 생각 없이 다시 썼다. 이렇게 똑같은 예방책을 계속 따로따로 발명하고 있다면, 그건 추출할 시점이라는 가장 확실한 신호다. 코드가 비슷해 보여서가 아니라, 같은 작은 조각을 계속 새로 만들고 있다는 점에서 그렇다.
이 모든 것의 바닥에는 이런 구조가 있었다:
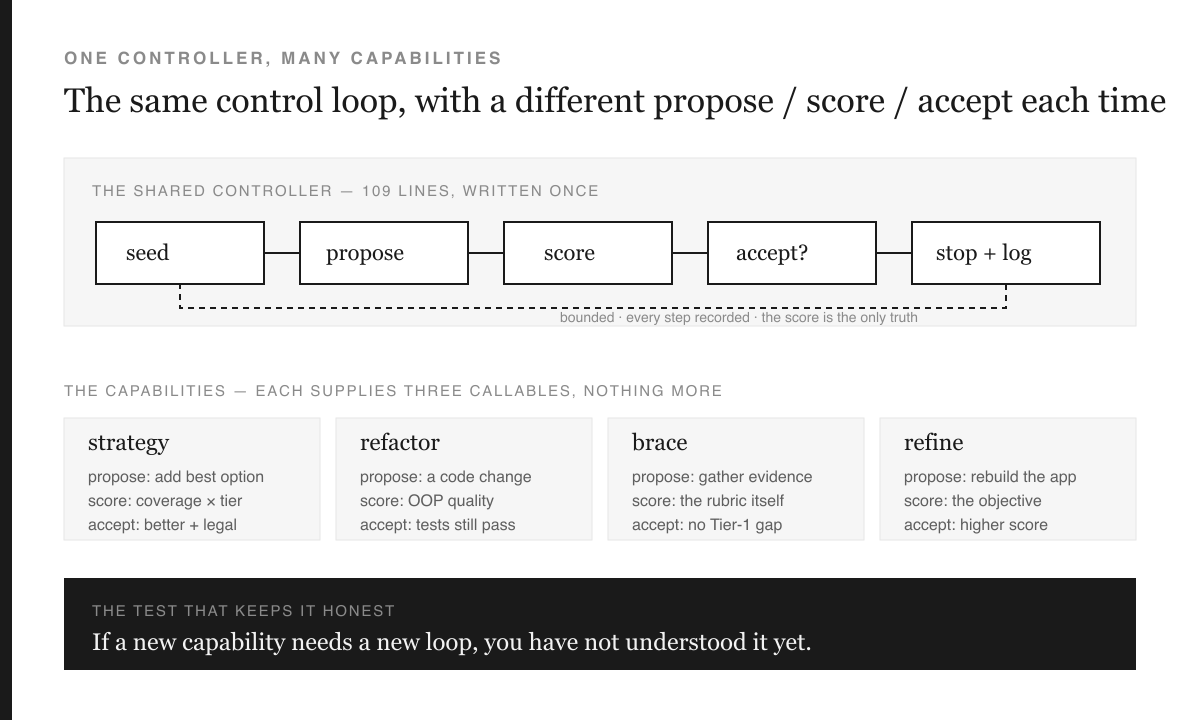
어디서든 시작한다. 후보를 제안한다. 자신이 아닌 외부 기준에 따라 점수를 매긴다. 더 나아졌을 때만 남긴다. 엄격한 한계 내에서, 모든 단계를 기록하며 반복한다. 목표에 도달하거나 더 이상 개선되지 않을 때 멈춘다.
이게 전부다. 이것이 바로 모터다. 앱을 개선하든, 코드베이스를 정리하든, 경쟁사의 제품을 분해하든, 전략을 고르든, 시스템을 보안 감시하든 — 모두 같은 구조이고, 차이는 오직 세 가지 질문에 있다:무엇이 후보로 인정되는가, 무엇이 더 나은 것으로 간주되는가, 무엇이 허용되는가.
109줄짜리, 읽기 쉬운 엔진
공유 컨트롤러는 문서까지 포함해 109줄이다. 그 핵심은 대략 이렇다:
best = seed
best_score = score(best)

while best_score < target and iterations_left:
    candidate = propose(best, i)
    candidate_score = score(candidate)
    if accept(candidate, candidate_score, best, best_score):
        best, best_score = candidate, candidate_score
    record(i, candidate_score, accepted)
세 가지가 구조를 지탱한다. 그리고 각각은 어떤 영역에도 적용할 수 있는 규칙이다.
한계는 반드시 있어야 한다.루프는 반복 한계가 1 미만이면 생성 자체가 불가능하다. '하지 말아야 한다'가 아니라, 아예 못 만든다 — 거부한다. 후보를 제안할 수 있는 프로세스는 언제든 폭주할 수 있고, 이를 막는 자리는 코드 리뷰가 아니라 생성자다.
점수를 매기는 사람(함수)은 절대 제안자(함수)와 같을 수 없다. 후보를 만드는 함수와 평가하는 함수는 반드시 달라야 한다. 전략 기능에서는 이 원칙을 생성 단계에서 강제한다. 두 함수에 같은 것을 넘기면 즉시 예외가 발생하며, 다음과 같은 메시지가 출력된다: "never self-certify"(번역: "스스로 인증하지 말 것"). 이 규칙은 소프트웨어 바깥에서 특히 자주 어겨진다. 계획을 세운 팀이 그 계획의 성과까지 직접 평가하는 경우가 대표적이다.
모든 단계가 빠짐없이 기록된다. 탈락한 후보도 예외 없이 남는다. 궤적이 곧 산출물이다. 단순한 디버그 로그가 아니다. 정답 자체보다, 그 정답이 무엇을 이겼는지를 아는 쪽이 훨씬 더 값지다.
1단계 — 이 글을 더 읽기 전에 직접 해볼 것 (2분)
당신이 반복적으로 관리하는 프로세스 하나를 골라보라. 예를 들면 채용, 주간 리뷰, 초안 편집, 공급업체 선정 등이 있다. 그 프로세스의 세 가지 역할을 소리 내어 말해보라. 제안: 후보는 어디서 오는가? 평가: 무엇이, 정확히, 어떤 후보가 더 낫다고 결정하는가 — 그리고 그 기준이 당신 바깥에 있는가? 수락: 점수가 더 낮은 후보를 굳이 채택하게 만드는 조건은 무엇인가?
대부분은 두 번째 항목이 비어 있다는 사실을 발견한다. 이것이 바로 핵심이다. 이 연습이 실패해서가 아니라, 중요한 사실을 드러내기 때문이다.
구체적 사례: 무엇을 할지 결정하기
가장 최근에 추가된 전략 기능 전체를 예시로 보여준다. 전략이라는 영역은 가짜 엄밀성이 가장 흔하고, 숨기기도 쉽기 때문이다.
이 기능에는 네 가지 항목으로 구성된 간단한 요약을 입력한다: 목표, 성공 기준 (목표 달성의 증거가 될 조건), 실제로 보유한 증거, 그리고 고려 중인 옵션 당신이 비교하는 여러 옵션이다. 각 증거에는 그 근거가 무엇인지 태그가 붙는다: 측정, 문서화, 사전 (타인의 데이터, 본인 데이터 아님), 또는 판단 (본인의 추정).
이제 루프를 돌린다. 제안: 아직 충족되지 않은 기준을 가장 많이 커버하는 옵션을 추가한다. 평가: 한 줄짜리 산술식으로 점수를 계산한다. 수락: 이전보다 확실히 더 나아졌고, 허용 가능한 경우에만 받아들인다.
전체 채점 규칙은 다음과 같다. 이 부분이야말로 가져가 쓸 만한 핵심이다:
score = (criteria covered / all criteria) × weight(weakest evidence)

          measured 1.00 · documented 0.90 · prior 0.75 · judgment 0.50
커버리지는 실제로 달성한 범위이고, 등급 가중치는 그 근거를 얼마나 신뢰할 수 있는지를 나타낸다. 그리고 이 둘을 곱한다.
이 곱셈이 바로 이 도구의 전부다. 왜 이렇게 했는지 설명하겠다. 만약 평균을 내면, 모든 항목을 순전히 추측으로만 커버한 계획도 측정에 근거한 계획과 비교해 80%쯤 되는 그럴듯한 점수가 나온다. 하지만 이건 완전히 잘못이다. 단순히 약한 정도의 같은 주장이 아니라, 아예 성격이 다른 주장이다. 곱셈은 이 차이를 명확히 드러낸다: 판단 등급에서 아무리 완벽하게 커버해도 점수는 최대 0.50을 넘지 못한다.
실제 예시를 실행해보자 — 신입 엔지니어 온보딩 시간을 단축하는 실제 결정을 다룬다. 세 가지 옵션을 선택하고, 4개 기준 모두를 충족하며, 점수는 0.75이다. 커버리지는 만점이지만, 세 옵션 중 하나가 사내 측정이 아닌 업계 벤치마크에 근거했기 때문에 점수의 4분의 1이 깎인다.
출력 결과는 이를 분명히 보여준다:
score 0.750 at prior tier · 4/4 criteria · stopped on plateau
   ✓ devcontainer for the five main repos        [documented]
   ✓ CI gate on stale setup docs                 [documented]
   ✓ golden-path starter task                    [prior]
   → the claim is only as strong as its weakest evidence: prior
모든 기준을 충족하면서 그 근거가 잡지 기사임을 밝히는 계획은, 모든 기준을 충족하면서 아무런 근거를 밝히지 않는 계획보다 더 가치 있다.이 감점은 곱셈에서 비롯된다.
여기에 두 가지 추가 동작이 있다. 둘 다 공학적 규칙처럼 보이지만, 사실은 도덕적 입장이다:
강한 제약 조건은 점수를 깎는 대신, 아예 멈춘다. 예시에서 한 옵션은 명시된 한계를 넘는다 — 신입에게 첫날부터 프로덕션 접근 권한을 주는 것이다. 루프는 점수만 깎고 매력적인 계획이 점수로 이를 뚫고 지나가게 두지 않는다. 즉시 멈춘다, 그리고 반드시 사람이 이름을 적어 승인해야 한다고 명확히 알린다. 점수로 넘어설 수 있는 제약은, 결국 누군가가 충분히 원하면 언젠가는 반드시 넘어가게 된다.
수식은 일부러 밋밋하게 만들었다.의사결정 순간에는 어떤 언어 모델도 돌지 않는다. 같은 요약, 같은 답, 언제나 동일하다. 검토자는 연필로 점수를 다시 계산해 기계가 거짓말하는지 잡아낼 수 있다. 직접 다시 계산할 수 없는 추천은 증거가 아니라, 그럴듯한 주장일 뿐이다.
2단계 — 20분 실습, 도구 불필요
지금 고민 중인 실제 결정을 하나 골라라. 한 장에 다음을 적는다: 목표 · 성공을 의미하는 기준 3~5개 · 고려 중인 모든 옵션 · 그리고 각 옵션 옆에, 어떤 기준을 충족하는지와 그 근거 (측정 / 문서화 / 타인의 데이터 / 본인 판단).
이제 이렇게 계산한다: 충족한 기준의 비율 × 가장 약한 증거의 가중치. 이 숫자가 바로 당신의 계획 점수다. 대부분 처음 솔직하게 해보면 0.35~0.55 사이에 걸린다. 이 차이는 거의 항상 커버리지 때문이 아니라, 구조 전체가 아무도 이름 붙이지 않은 미측정 가정 하나에 기대고 있기 때문이다.
네 가지 추가 기능, 같은 루프
이 패턴의 진짜 가치는 다음 기능을 추가하는 일이 지루할 만큼 단순하다는 데 있다. 짧게 네 가지 예를 들겠다:
코드베이스 리팩터. 코드 변경을 제안하고, 구조적 품질을 점수화한 뒤, 테스트가 여전히 통과할 때만 — 아니면 롤백한다. 안전성은 바로 이 수용 규칙에 있다. 품질 점수만으로는 망가진 프로그램의 겉모습만 멀쩡하게 바꿔줄 뿐이다.
배포 환경을 보안 기준에 맞춰 점검한다. 이 예시는 이 패턴이 사실 소프트웨어에만 국한되지 않음을 가장 잘 보여준다. 공개된 통제 기준표는 설문지처럼 생겼다. 그 자체가 채점자다. 일단 그렇게 보면, 기준표가 점수 함수로 바뀌고 루프가 각 항목에 대한 증거를 스스로 모으며, 컴플라이언스 문서는 빌드를 실패시킬 수 있는 무언가로 변한다. 당신이 받아본 모든 체크리스트, 표준, 평가 가이드는 누군가 중간에 멈춘 닫힌 루프다.
시스템의 기업 실전 준비도를 평가한다. 일곱 개의 축, 그리고 모든 격차마다 그 격차를 메우는 정확한 명령이 출력된다. 후속 조치가 없는 발견은 그냥 불평에 불과하다.
반성, 측정 가능한 실천으로서. 이게 전체의 정직함을 지키는 장치다. 확률과 마감일이 붙은 예측 장부를 들고, 결론이 나면 점수를 매기고, 그리고 결론을 만료시킨다.그래서 신념이 쌓이기만 하는 것이 아니라, 주기적으로 다시 검증받는다. 주간 점검은 '이번 주가 어땠는가'를 묻는다. Brier 점수로 평가하는 장부는 '정말로 맞았는가?'를 묻고, 그 결과를 기록한다.
애드온 시스템이 부패하지 않게 지키는 세 가지 규칙
애드온은 대부분의 시스템이 무너지는 방식이다. 브라우저 확장, 엔터프라이즈 소프트웨어, 팀의 프로세스 문서, 그리고 '기타' 폴더까지. 지금까지 이 세 가지 규칙이 그 붕괴를 막아왔다.
규칙 1 — 새로운 기능은 별도의 루프를 가져올 수 없다.만약 어떤 기능이 자기만의 루프를 필요로 한다면, 그 기능을 아직 충분히 이해하지 못한 것이다. 이건 강한 주장이고, 가끔은 틀릴 때도 있다. 하지만 실제로 틀리는 경우는 그 순간 느끼는 것보다 훨씬 적다. 그리고 이 규칙이 막아주는 실패의 대가는, 그로 인한 불편보다 훨씬 크다.
규칙 2 — 경계는 반드시 '시임(seam)'을 통해 넘어야 하며, 직접 import해서는 안 된다.전략 애드온은 어딘가에 의사결정 그래프를 쓴다. 어디에 쓰는지는 스스로 모른다. 포트(추상 인터페이스)를 제공하고, 별도의 어댑터가 실제 저장소에 연결한다. 저장소만 바꿔도 나머지는 그대로 두고, 양쪽 모두에 똑같은 테스트 스위트를 돌릴 수 있다.
David Parnas가 1972년에 이 원칙을 썼고, 이후로 더 나은 설명은 나오지 않았다:
"Its interface or definition was chosen to reveal as little as possible about its inner workings." (번역: 그 인터페이스나 정의는 내부 동작을 최대한 드러내지 않도록 선택되었다.)
— D. L. Parnas, On the Criteria To Be Used in Decomposing Systems into Modules, CACM 15(12), 1972 [R1]
그의 주장은 미적 취향이 아니었다. 그는 변화에 대해 예측하고 있었다. 가장 변할 가능성이 높은 설계 결정을 먼저 찾아, 각각을 모듈 안에 숨겨라. 그러면 그 결정이 바뀔 때 변화는 그 안에서 멈춘다. 54년이 지난 지금, 내 도구에서 실제로 가장 자주 바뀌는 결정들은 모두 시임 뒤에 있다. 이건 내가 미리 설계한 게 아니라, 시임 없이 만든 부분에서 직접 실패해보고 나서야 깨달은 사실이다.
나는 전략 애드온을 만들며 이 원칙을 직접 경험했다. 내 다른 레포지토리에 있는 엄격한 그래프 저장소에 연결했더니, 그 무결성 규칙이 내 쓰기를 거부했다:의사결정 노드는 반드시 사람이 작성해야 한다. 나는 여러 후보 옵션 묶음을 '의사결정'으로 모델링했다. 하지만 그건 진짜 의사결정이 아니다. 후보를 제안하는 루프는 분석을 하는 것이고, 결정은 사람이 내리는 일이다.규칙이 옳았고 내 모델이 틀렸으니, 나는 모델을 고쳤다.이것이 진짜 시임의 가치다 — 반대편에 있는 것이 거부할 수 있고, 그 거부 자체가 곧 정보가 된다.
규칙 3 — 시스템은 반드시 자기 소유자에게 '아니오'라고 말할 수 있어야 한다.이 부분은 다음에서 더 다룬다. 모두가 동의하지만 실제로 구현하는 사람은 거의 없는 규칙이기 때문이다.
3단계 — 가장 불편한 실습 (10분)
당신의 일에서, 현재 문서나 관행, 혹은 선의에만 의존하는 규칙 하나를 찾아보라 — '금요일에는 배포하지 않는다', '모든 주장에는 출처가 필요하다', '업체는 반드시 두 개 이상의 추천서를 받아야 한다' 같은 것.
실제로 거부하는 장치를 만들어라. 예를 들어 테스트, 직접 체크해야 하는 체크리스트 항목, 제출이 불가능한 폼 등이 있다. 그런 다음 스스로의 규칙을 어기려고 시도해 보고, 정말로 막히는지 확인하라. 실제로 발동하지 않는 규칙은, 그저 제복을 입은 선호에 불과하다.
이 모든 내용을 신뢰하게 만드는 결정적 대목
내가 만약 이걸 팔고 있다면, 이 부분은 아마 건너뛰었을 것이다.
이 도구의 매뉴얼에는 경고 문구가 붙은 서브커맨드 두 개가 등장한다: 둘 다 실제로 구현된 적이 없다 — 이건 바람일 뿐, 기능이 아니다. 이 둘은 실제로 존재하기 전에 문서에 먼저 등장했다. 그리고 조용히 문단을 삭제하지 않고, 그 문단은 남아 경고문이 붙었다. 이 항목은 매뉴얼에서 가장 쓸모 있는 부분 중 하나다. 미래의 내가 존재하지 않는 기능을 자신 있게 제공하는 일을 막아주기 때문이다.
더 아픈 사례도 있다. 시스템에는 매 세션마다 교훈을 저장하는 자기개선 루프가 있다고 문서화되어 있었다. 매뉴얼에도 그렇게 적혀 있었다. 실제로 존재한 것은 단 하나의 파일, lessons.jsonl, 여기에 멈춰 있었다. 42개 기록 — 약 23개의 작업이 진행되는 동안 단 한 번도 갱신되지 않았는데도, 문서는 그 루프가 잘 돌아가고 있다고 태연하게 설명하고 있었다.
문서에는 있지만 실제로 만들어지지 않은 루프는 조용히 고장난 루프와 구별할 수 없다. 이것이 바로 핵심 교훈이고, 이 교훈은 무자비하게 일반화된다: 당신 조직이 있다고 믿지만 실제로 발동되는 걸 본 적 없는 모든 프로세스가 지금 이 상태다. 온보딩 체크리스트, 사후 분석 후속 조치, 분기별 접근 권한 검토 — 모두 마찬가지다.
이 문단을 쓰면서 나는 그 파일을 다시 확인했다. 혹시 이미 고쳐진 사실을 인용하고 있는 건 아닌지 확실히 하려고.
여전히 42개 그대로다.
이 문장이야말로 이 글에서 가장 솔직한 문장이라고 생각한다 — 그리고 이 문장은 남겨둔다. 신뢰할 수 있는 시스템을 만든다는 글에서, 저자의 미해결 결함을 조용히 누락시키는 건 이 글의 논지와 정반대를 시연하는 셈이기 때문이다.
패턴과 반패턴
| 패턴 | 대체되는 반패턴 |
|---|---|
| 컨트롤러 하나; 각 기능은 세 개의 함수를 제공한다 | 각 기능이 자체 루프, 재시도 규칙, 로깅을 따로 갖는다 |
| 제한은 생성자에 명시되어 있고, 조건을 만족하지 않으면 생성 자체를 거부한다 | "타임아웃은 나중에 추가하자" |
| 평가자와 제안자는 명확히 서로 다른 객체여야 한다 | 계획을 세운 팀이 그 계획의 성과도 직접 보고한다 |
| 증거의 신뢰도는 점수에 곱셈으로 반영된다 | 신뢰도를 평균내면, 추측이 점수를 희석시킬 뿐 상한을 설정하지 못한다 |
| 강한 제약 조건은 사람이 개입해야 할 때 즉시 멈춘다 | 강한 제약을 벌점으로 처리하면, 충분히 큰 수치로 얼마든지 넘어설 수 있다 |
| 두 개의 실제 구현을 가진 포트를 통해 경계를 넘는다 | 직접 import하면, 의존성이 거부하거나 교체될 수 없다 |
| 실제로 실행되어 빌드를 실패시키는 규칙 | 아무도 실제로 발동하는 걸 본 적 없는 문서 속 규칙 |
| 검토자가 직접 다시 계산할 수 있을 만큼 일부러 단순하게 만든 산술 | 의사결정 경로에 모델이 끼어 있으면, 답이 바뀌고 감사가 불가능하다 |
핵심 원칙, 한 문장으로
새로운 기계를 만드는 대신 함수 세 개로 기능을 추가해야 하며, 무엇을 만들든 만든 사람조차 거부당할 수 있어야 한다.
앞으로 20분 동안 할 수 있는 실천
| 실행 항목 | 효과 확인 방법 | 기한 |
|---|---|---|
| 내가 관리하는 반복 업무 하나를 골라, 제안/평가/수용의 세 가지 역할을 명확히 정의하기 | 세 가지를 한 문장으로 설명할 수 있고, 평가자가 내가 아님을 확인한다 | 오늘, 2분 |
| 실제 결정을 목표·기준·옵션·증거(등급 포함)로 한 페이지에 정리하기 | 한 페이지에 모든 옵션마다 '어떻게 아는지'가 명시되어 있다 | 이번 주, 20분 |
| 커버리지 × 가장 약한 증거 등급의 가중치를 직접 손으로 계산해본다 | 0과 1 사이의 값이 나오고, 무엇이 그 값을 제한하는지 정확히 말할 수 있다 | 바로 그 자리에서 |
| 문서로만 존재하던 규칙 하나를 실제로 위반을 막는 장치로 바꾼다 | 직접 위반을 시도했을 때 실제로 저지당했다 | 이번 주, 10분 |
| 자동으로 동작한다고 믿는 프로세스 하나를 골라, 마지막으로 실행된 시각을 실제 산출물에서 확인한다 | 기억이 아니라 실제 증거로 마지막 실행 시점을 알고 있다 | 오늘, 5분 |
마지막 항목이 가장 자주 적중한다. 조용히 멈춰 있는 42를 적어도 하나는 발견할 확률에 내기를 걸겠다.
참고 문헌
- Parnas, D. L. (1972). On the Criteria To Be Used in Decomposing Systems into Modules. Communications of the ACM 15(12), 1053–1058. PDF — quoted verbatim above; verified 2026-09-29.
- Conway, M. E. (1968). How Do Committees Invent? Datamation. melconway.com — "organizations which design systems (in the broad sense used here) are constrained to produce designs which are copies of the communication structures of these organizations", verified verbatim 2026-09-29. 왜 이 인용이 여기 있는가: 기능이 뒤섞인 도구함은, 대개 공유 엔진에 대해 한 번도 대화하지 않은 팀의 단면도다.
- Brier, G. W. (1950). Verification of Forecasts Expressed in Terms of Probability. Monthly Weather Review 78(1), 1–3. 위에서 설명한 예측 장부의 점수 산정 규칙.
Paul Jialiang Wu 작성. 이 글에 등장하는 모든 수치는 2026-09-29 기준 코드베이스에서 직접 확인한 값이다. 41개의 서브커맨드, 8개의 루프, 109줄짜리 공유 컨트롤러, 1,035개의 통과 테스트, 그리고 여전히 42에서 멈춰 있는 lessons 파일 하나. 이 도구는 비공개라서, 여기서 논하는 원칙과 규칙은 도구 자체가 없어도 적용된다. 구분하자면: 수치는 실측값, 세 가지 규칙은 설계 원칙, 비소프트웨어 영역에도 이 논리가 통한다는 주장은 논쟁을 환영하는 추론이다.