AI-NATIVE 系列 · 架构
一条循环,四十一条命令:工具怎么长大还能不变成杂物堆
我维护的一个工具有 41 个子命令和一个主控循环。引擎本体 109 行。每加一个新能力,只需写三个函数。下面是它的模式、一个完整实例,以及让插件系统不烂尾的三条规则——这些原则完全不依赖这个工具本身。
1 分钟速览
这是什么: 一个个人 AI 工具的架构,已经长到 41 个命令却没变成杂物堆——所有能力都插在同一个主循环里。
为什么重要: 杂物堆不是代码问题,而是所有系统成长时的必经之路——无论是团队、课程体系还是公司流程,每次新需求都单独造一套机制,而不是给已有机制换件新衣服。
你可以试试: 拿你这周要做的一个决策,写成四个部分,手算一行算式。二十分钟。很可能你会发现,自己的方案其实是架在比想象中更脆弱的基础上。
背景说明:一条循环就是全部思路,这篇不是在讲我的工具
下面所有内容都出自同一个代码库,但几乎都不是在讲那个代码库。工具是私有的,你装不了,这也是我写作时自设的约束:如果一篇文章的价值取决于读者能不能拿到它描述的东西,那它就是宣传册。所以我给自己定的标准是:这里的每条原则都必须能撑过这句话——「……而且我永远不会见到那个仓库。」
这个问题,其实你早就有了。你手上总有些会不断膨胀的东西——代码库、团队流程、课程体系,或者家里的各种系统。每个新需求看着都像独一份。每次最顺手的反应,都是给它单独造一套机制,各自为政。
每个需求都配一台新机器:系统失控的经典剧本
这种失控有迹可循。每个新需求看起来都很特别,于是就有了自己的机制:自己的循环、自己的重试规则、自己对“完成”的定义、还有和旁边那套微妙不同的日志。明明一个引擎就够,却造了六个。(厨房的版本是台面上堆满了单一用途的小家电,每个都有自己的电机等着坏;而搅拌机只要换个头就行——不过这个比喻只是引子,不是论点,我就不展开了。)
没人会坐下来郑重决定“我要造个杂物抽屉”。杂物抽屉的诞生,恰恰是因为没人决定不要这么做。真正的代价不是乱,而是你改进了某一项,只能让那一项变好。有了共享引擎,每个能力都会一起进步。
四个能力,其实只是同一个能力换了四身马甲
故事的转折点不是啥妙招,而是我翻自己代码时发现的一个无聊事实。
当时有四个独立的循环——一个用来改进生成的 app,一个重构代码库,一个逆向分析某个制品,一个从模糊的吐槽里挖产品需求。四个完全不同的领域,写作时间也隔了好几个月,看起来毫无关联。
它们其实就是同一个函数。不是“有点像”——一模一样,甚至连拒绝零次迭代的防御性判断都一字不差地出现在四处。我居然写了四遍一模一样的防御行还没察觉,这基本是最可靠的信号:不是代码长得像,而是你总在不自觉地重复发明同一个小心思,这说明它该被提取出来了。
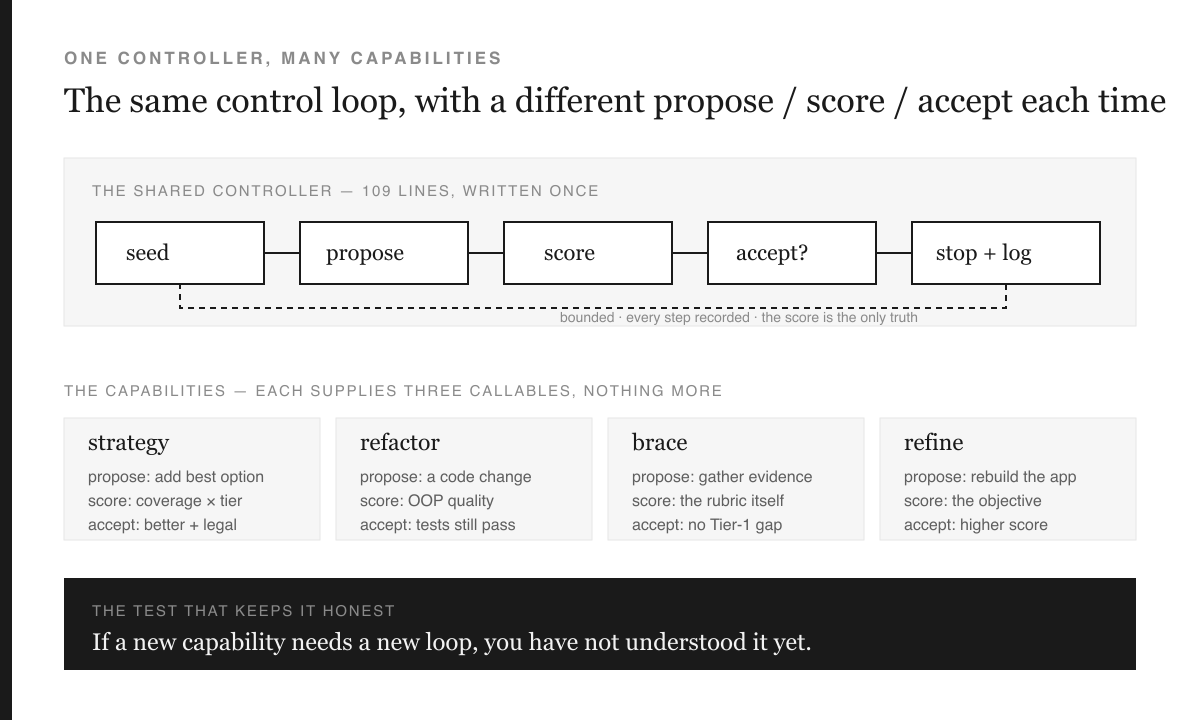
它们背后其实都是这个流程:
随便找个起点,先提一个候选项,用外部标准打分,只保留更好的那个。每一步都记下来,设定硬性上限。达到目标或不再进步就停。
就这样,这就是发动机。无论是改 app、清理代码库、拆解竞品、选策略、做安全审计——全都一个模子,区别只在三个问题:什么算候选,什么算更好,什么算允许。
引擎本身,小到可以直接读完
这个共享控制器连文档一共 109 行。核心大致是:
best = seed
best_score = score(best)

while best_score < target and iterations_left:
    candidate = propose(best, i)
    candidate_score = score(candidate)
    if accept(candidate, candidate_score, best, best_score):
        best, best_score = candidate, candidate_score
    record(i, candidate_score, accepted)
有三样东西是关键,每一样都是你能带去任何领域的规则。
上限不是可选项。循环的构造器里,限制必须大于等于 1。不是“最好别”——而是根本不允许,直接拒绝。任何能提出新方案的流程都可能跑飞,拦住它的地方应该是构造器,而不是代码评审。
打分和提案绝不能是一拨人。 负责生成候选项的函数,不能同时负责给它们打分。在策略模块里,这条规则在构造阶段就被硬性执行:如果你把同一个函数同时传给 proposer 和 scorer,系统会直接报错,提示 “never self-certify”(中译:绝不自我认证)。这条规则在软件之外被破坏得最频繁——写方案的团队往往也负责汇报方案成效。
每一步都会被完整记录,包括那些被淘汰的选项。 轨迹本身就是最终结果,不只是调试用的副产品。知道答案本身,远不如知道答案击败了哪些备选更有价值。
第一阶——请在继续往下读前先做这个(2 分钟)
随便挑一个你手头反复在做的流程:比如招聘、每周回顾、改稿、选供应商。把它的三个关键动作大声说出来。提出(Propose): 候选项从哪里来?评分(Score): 到底是什么决定了哪个更好——而且这个标准在你之外吗?接受(Accept): 在什么情况下你会保留一个分数更低的候选项?
大多数人会发现,第二个问题往往是缺失的。这其实就是发现本身,不是你做错了。
实操例子:怎么决定要做什么
我会把最新的这个模块完整展示,因为“策略”这个领域最容易出现假装严谨、最容易藏猫腻。
你给它一份包含四项的简报:目标(objective),成功标准(success criteria)(即什么算达成),你实际掌握的证据(evidence),以及你正在权衡的选项(options) 你在权衡的每个选项。每条证据都要标明你是怎么知道的:实测, 有文档, 他人数据(别人的数据,不是你自己的),或者主观判断(你自己觉得)。
接下来就是循环:Propose = 加入能覆盖最多未覆盖标准的选项。Score = 一行算术。Accept = 必须严格更好,且合法。
完整的评分规则在这里,也是最值得拿走的部分:
score = (criteria covered / all criteria) × weight(weakest evidence)

          measured 1.00 · documented 0.90 · prior 0.75 · judgment 0.50
覆盖度是你实际做到的,证据等级的权重代表你有多大理由相信它。两者相乘.
这个乘法就是工具的全部观点,所以我得为它撑腰。如果你用平均值,一个全靠猜测覆盖所有标准的方案,看起来只比全靠实测的方案弱一点——大概八成多分。其实不是。这不是同一类主张的弱化版,而是完全不同的主张。乘法的意思是:只要是主观判断等级,即使覆盖再全,分数也最多只有 0.50。
跑一下自带的例子——一个关于缩短新工程师入职时间的真实决策——它选了三个选项,覆盖了4/4个成功标准,得分0.75。覆盖度满分,但分数还是被扣了四分之一,因为三个选项里有一个只是行业基准,不是内部实测。
输出会直接说出来:
score 0.750 at prior tier · 4/4 criteria · stopped on plateau
   ✓ devcontainer for the five main repos        [documented]
   ✓ CI gate on stale setup docs                 [documented]
   ✓ golden-path starter task                    [prior]
   → the claim is only as strong as its weakest evidence: prior
一个覆盖所有标准、而且坦白告诉你它是靠杂志文章支撑的方案,比一个什么都不说的全覆盖方案更有价值。这个折扣就是乘积。
还有两个行为,其实都是工程外壳下的道德立场:
硬性约束直接终止流程,不是扣分。 示例里有个选项越过了明说的边界——比如让新员工第一天就有生产权限。循环不会扣它分数,也不会让一个足够诱人的方案“买通”这个限制。它会直接停下,并要求必须有个人实名签字。任何可以被“权衡”掉的约束,最终都会被某个特别想要的数字压过去。
这套算术故意做得很朴素。 决策时绝不会调用任何语言模型。相同的简报,永远给出相同的答案——而且审阅者完全可以用铅笔手算一遍分数,现场拆穿机器的把戏。一个你没法自己复算的推荐,不叫证据,只是一本正经的主观判断。
第二阶——二十分钟手算版,无需任何工具
拿一个你现在真的要做的决策,在一页纸上写下:目标 · 3–5 条判定成功的标准 · 你考虑的每个选项 · 以及每个选项旁边,标明它覆盖了哪些标准,以及你是怎么知道的(measured / documented / someone-else's-data / you reckon)。
然后算一算:覆盖标准的比例 × 你最弱那条证据的权重。 这个数就是你的方案分数。大多数人第一次诚实地算下来,分数都在 0.35 到 0.55 之间,问题几乎从来不是覆盖度——而是整个结构其实压在了某个没人点名、也没人测过的假设上。
再举四个能力,还是同一个循环
这个模式的好处是,下一个能力加起来毫无悬念。随便举四个小例子:
重构一份代码库。 提出一次代码修改,打分其结构质量,只有在测试依然全部通过时才接受,否则回滚。安全感就藏在接受规则里。单靠质量分,坏掉的程序也能被“优化”得更漂亮。
对一次部署做安全标准审计。 这个例子最能说明,这个模式根本不限于软件。公开的控制标准长得像问卷,其实就是打分器。一旦你看明白了,标准就成了评分函数,循环会自动为每一项收集证据,一份合规文档就成了能让构建失败的东西。你手上拿过的任何清单、标准或评分表,本质上都是别人只做了一半的闭环。
评估系统的企业级就绪度。 七大支柱,每个缺口都会打印出精确的补救命令。只指出问题、不给后续动作的,都是抱怨。
反思,作为一种有据可查的实践。 这是让整个系统保持诚实的那一环。它维护一份带概率和截止日期的预测账本,结算时打分,并且让结论自动过期这样结论会过期,信念会被重新检验,而不是一味堆积。每周回顾会问你感觉如何;Brier 评分的台账则会问你当初判断得准不准,并且会记住答案。
让插件系统不烂尾的三条铁律
插件系统,才是大多数系统的死法。浏览器扩展、企业软件、团队流程文档,还有那个“杂项”文件夹,最后都栽在这里。到目前为止,有三条铁律还算顶得住。
规则 1 —— 新能力不能自带自己的循环。如果你加的能力还得带一套自己的循环,那说明你还没真正想明白它。这话说得很绝对,偶尔也会错,但实际出错的概率远低于你当下的直觉,而且它能防住的烂摊子,比它带来的麻烦要严重得多。
规则 2 —— 跨界只走接口,绝不直接导入。策略附件会把决策图写到某个地方,但它根本不知道写到哪。它只持有一个端口——一个抽象接口——再用单独的适配器把它接到实际存储上。你可以随意换存储,其他什么都不用动,测试套件对两套实现都能无缝通过。
David Parnas 1972 年就把理由写明白了,至今没人能超越:
“Its interface or definition was chosen to reveal as little as possible about its inner workings.”(中译:它的接口或定义被设计为尽可能少地暴露其内部实现。)
—— D. L. Parnas,On the Criteria To Be Used in Decomposing Systems into Modules,CACM 15(12), 1972[R1]
他的观点不是美学,而是对变更的预测:先把最容易变的设计决策藏进模块里,这样将来真要变,影响也只会止步于此。五十四年后,我工具里最容易变的决策,恰好就是藏在接口背后的那些——这不是我事先规划好的,而是我在没做对的地方亲身踩坑才发现的。
我在做策略附件时就被现场教育了一次。我把它连到另一个仓库里的严格图存储上,结果它的完整性规则直接拒绝了我的写入:decision nodes are human-authored only.我把一组候选方案建模成了“决策”,但其实不是。循环提出候选方案是在做分析,真正的决策只能由人来下。规则没错,是我的模型错了,所以我改了模型。这就是“真接口”带来的好处——对面有权拒绝你,而这种拒绝本身就是信息。
规则 3 —— 系统必须能对自己的主人说“不”。这一条后面会详细聊,因为大家都口头同意,但真落地的几乎没有。
第三阶——最扎心的练习(10 分钟)
找出你工作里一条现在只写在文档、规范或靠自觉维持的规则,比如“我们周五不发版”、“每条结论都要有出处”、“供应商必须有两个推荐人”等。
让某个东西真的能拦住你。比如加一个测试、一个必须手动勾选的清单项,或者一个死活提交不了的表单。然后试着自己违反这条规则,看看你是不是真的被挡下来了。不能真拦住人的规则,只是穿了制服的偏好。
让前面那些内容站得住脚的部分
如果我是来推销产品,这一节我肯定会跳过。
这个工具的手册里有两个命令,旁边都挂着警告标签:NEITHER IS BUILT —— 这些只是想法,不是现有能力。它们在功能还没影子的时候就写进了文档,而且不是悄悄删掉那段话,而是让它留着,还专门加了个警告。结果反倒成了手册里最有用的条目之一,因为它的作用就是防止未来的我自信满满地承诺一个根本不存在的功能。
还有个更扎心的例子。系统文档里写着有个自我改进循环,每次运行后都会存下一条教训。手册里确实这么说了。但实际上,只有一个文件,lessons.jsonl,内容卡在42 条——大约二十三次交付都没动过,而文档还在乐呵呵地描述着一个“正在运行的循环”。
一个只写在文档里、但从没真正跑起来的循环,和一个悄悄坏掉的循环没有任何区别。这就是全部教训,而且推广起来毫不留情:你们组织自以为有、但从没见它真的“触发”过的每一个流程,现在都处于这种状态。比如入职清单、事后复盘、季度权限审查。
写这段时我又去翻了一遍那个文件,确认自己不是在引用一个早就被修掉的漏洞。
它还是 42。
我觉得,这大概是本文最诚实的一句话——它必须留下来。毕竟,如果一篇讲怎么构建可信系统的文章,悄悄把作者没修的漏洞藏起来,那才真是在反面示范。
模式与反模式
| 模式 | 它替换掉的反模式 |
|---|---|
| 一个控制器,所有能力只需提供三个函数 | 每个能力都带自己的循环、重试规则和日志 |
| 上限写死在构造器里,遇到不合理直接拒绝 | “我们以后再加个超时吧” |
| 评分器和提案器必须是两个明确不同的对象 | 写方案的团队自己给方案打分 |
| 证据质量直接作为分数的乘数 | 信心分数取平均,结果是猜测只会稀释分数而不是设上限 |
| 硬性约束必须让人类介入并直接终止流程 | 硬性约束被当作扣分项处理,所以只要分够高就能强行突破 |
| 跨边界必须通过一个有双实现的端口 | 直接 import,导致依赖永远无法拒绝或替换 |
| 规则实际执行,并且能让构建失败 | 规则只写在文档里,从没人见它真的触发 |
| 刻意无聊的算术,审阅者能手算复查 | 决策路径里有模型,结果随时会变,无法审计 |
首要原则,一句话总结
每个能力只该付出三个函数的代价,而不是一套新机器——而且你造的任何东西都必须能拒绝你本人。
接下来二十分钟可以做什么
| 要做的事 | 怎么判断做成了 | 截止时间 |
|---|---|---|
| 为你手头的某个重复流程,明确 propose / score / accept 这三个函数 | 你能一句话说清这三项,而且评分人不是你自己 | 今天,2 分钟 |
| 把一个真实决策写成 objective · criteria · options · evidence-with-tiers 四项 | 一页纸,每个选项都写明你怎么知道 | 本周,20 分钟 |
| 用手算一遍:覆盖率 × 最弱证据的权重 | 你会得到一个 0 到 1 之间的数字,而且能准确说出是什么在卡住它 | 同一轮内搞定 |
| 把一条写在文档里的规则,变成真的能拦人的机制 | 你试图违反,结果真的被挡了下来 | 本周内,10 分钟 |
| 挑一个你觉得“自动在跑”的流程,查查它最近一次的输出时间戳 | 你能靠证据(不是靠记忆)说出它上次真的触发的时间 | 今天,5 分钟 |
最后一行的命中率最高。我敢打赌你至少能翻出一个静悄悄的 42。
参考文献
- Parnas, D. L. (1972).On the Criteria To Be Used in Decomposing Systems into Modules.Communications of the ACM 15(12), 1053–1058.PDF——上述已原文引用;2026-09-29 验证。
- Conway, M. E. (1968).How Do Committees Invent?Datamation.melconway.com——“organizations which design systems (in the broad sense used here) are constrained to produce designs which are copies of the communication structures of these organizations”(中译:在这里广义理解的系统设计组织,最终产出的系统设计必然映射其沟通结构),2026-09-29 原文验证。为什么要放在这里:一堆杂乱无章的功能抽屉,通常正是一个团队从没聊过“共用引擎”的真实写照。
- Brier, G. W. (1950).Verification of Forecasts Expressed in Terms of Probability.Monthly Weather Review 78(1), 1–3。上文预测记账本的评分规则出处。
作者:Paul Jialiang Wu。本文所有数据均于 2026-09-29 直接查自代码库:41 个子命令、8 条循环、一个 109 行的共享控制器、1,035 个通过的测试,还有那份依然卡在 42 条的 lessons 文件。工具本身是私有的,所以这里没有任何内容依赖于它。说明一下:数字是实测,三条规则是设计立场,至于这些原则能否迁移到非软件领域——这是个推断,欢迎来杠。