AI-NATIVE 시리즈 · 하니스 엔지니어링
모든 것이 플러그인이고, 진짜 일은 계측 도구에 있다.
1분 소요
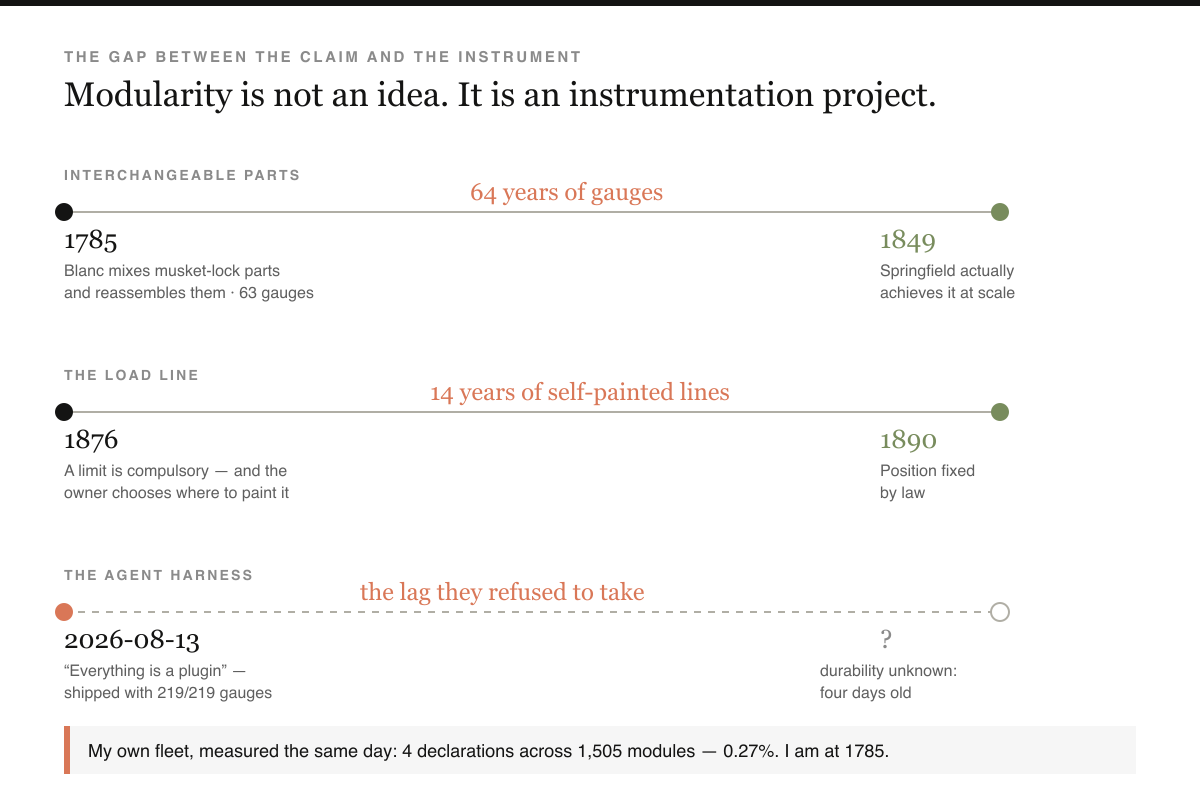
DeepSeek이 8월 13일 에이전트 하니스를 오픈소스로 공개했고 4일 만에 GitHub 스타 147,620개를 모았다. 모두가 반복한 슬로건—everything is a plugin—은 이 저장소에서 가장 덜 흥미로운 부분이다. 나는 이를 클론해서 직접 숫자를 세어보았다. 실제로는 219개의 패키지와 219개의 불변성 동반자, 각 패키지마다 하나씩 빠짐없이, 그리고 그중 184개(84%)는 '여기서 보장할 불변 조건이 없으며, 그 이유는 다음과 같다'고 명확히 서술한다. 게이트는 설명 없는 공백을 거부한다. 이것은 아키텍처가 아니라 계측 도구다. Honoré Blanc는 63개의 계측기를 1785년에 머스킷 부품의 상호 교환성을 실현하기 위해 만들었고, 이를 모방한 Springfield Armory는 실제로 상호 교환성을 달성하기까지 1849무려 64년이 걸렸다. 주장하는 건 쉽다. 계측기가 진짜 일이다. 그래서 나는 동일한 게이트를 내 코드베이스에도 만들어 27개 저장소에 적용했다. 결과는 1,505개 모듈 중 선언은 4건 — 0.27%에 불과했다. 이 수치는 수정 없이 그대로 공개한다. 두 번째 발견이 더 뼈아프기 때문이다. 1876년 Samuel Plimsoll의 하중선 법은 선주가 선체 어디에 하중선을 그릴지 임의로 정하도록 허용했다, 그리고 이 허점은 1890년에 가서야 바로잡혔다. 내 임계값 대부분도 여전히 내가 정한 선에 머물러 있다.
1. 4일, 147,620개의 별, 그리고 잘못된 헤드라인
deepseek-ai/deepseek-harness (dsh)가 2026-08-13 MIT 라이선스로 공개됐다. 8월 17일 GitHub API를 조회하니, 별이 147,620개, 포크가 15,083개였고, 마지막 커밋은 그날 아침이었다. 언론은 이를 경쟁적 행보로 해석했다 — Claude Cowork을 겨냥한 오픈 런타임, 즉 모델 위 레이어를 주장하는 모델 회사라는 식이다.상위 레이어다.
이런 해석이 맞을 수도 있지만, 내게는 별 의미가 없다. 별의 속도는 배포 상황만 보여줄 뿐, 엔지니어링의 본질은 드러내지 않는다. 그래서 나는 저장소의 AGENTS.md 권고를 그대로 따랐다 — "We recommend using an agent to explore the codebase"(번역: 코드베이스 탐색에는 에이전트 사용을 권장합니다) — 81MB를 클론해서, 훔칠 만한 규칙이 있는지 직접 찾아봤다.
노트북을 덮고 한참 생각하게 만든 규칙이 하나 있었다. 지난 2주 동안 글로만 주장해왔지만 실제로 구현해본 적 없는, 내게 필요한 규율의 작동 원리였다.
2. 실제로 읽은 것과 그 방식
내가 실제로 행동으로 옮길 대상을 선별할 때 쓰는 네 개의 연구 창이 있다. 지금 무엇이 논의되고 있는지, 데모에서 표준이 된 것은 30개월 동안 무엇이었는지, 30년이 지나도 여전히 핵심을 떠받치는 것은 무엇인지, 그리고 30년이 아니라 300년을 버틴 것은 무엇인지다. 마지막 창은 단순한 장식이 아니다. 그저 그럴듯하게 들렸던 아이디어를 실제로 걸러낸 유일한 시간의 길이다.
오직 1차 자료만, 대충 넘기지 않고 직접 세어가며 읽었다:
- 저장소 자체:
docs/architecture.md, 루트와 패키지AGENTS.md,docs/testing.md,.agents/notes/트리,scripts/, 그리고 각 범주에서 실제invariant.ts하나; - Agent Harness Engineering: A Survey — CMU, UAB, Tulane, Yale, Northeastern, Stanford, Amazon, UChicago, Virginia Tech, Rutgers 등에서 집필한 37,794단어 분량의 리뷰로, 170개가 넘는 오픈소스 프로젝트를 7계층 분류 체계에 매핑한다;
- 두 개의 긴 창에 해당하는 해양 및 제조 기록은 기억에 의존하지 않고 박물관과 표준 자료를 대조해 확인했다.
이하 모든 수치는 내가 직접 센 값이거나, 명시된 출처에서 인용한 수치다. 검증하지 못한 부분은 분명히 밝힌다.
3. 정말 배울 만한 단 하나의 규칙
출처 packages/AGENTS.md, 원문 그대로:
모든 패키지는 자신만의 컴패니언을 가진다./invariant. 매니페스트 이름을 등록하고, 이벤트/데이터 관계를 점검하거나, 빈 설치자라면 패키지별No runtime invariant:사유를 명확히 적는다. 자동 생성된 컴패니언, 설명 없는 빈 선언, 무시된 리포터는 모두 실패 처리된다verify-package-invariants.
내가 실제로 그들의 트리에서 집계한 항목:
| 항목 | 값 |
|---|---|
| 패키지 수 | 219 |
컴패니언이 있는 패키지 수invariant 컴패니언 | 219 — 예외 없음 |
| "No runtime invariant: …"(런타임 불변 조건 없음: …)을 명시한 컴패니언 | 184 (84%) |
verify-* 저장소 게이트 | 36 |
| 해당 게이트용 테스트 파일 | 46 — 이 게이트들은 웬만한 제품보다 더 많이 테스트된다 |
| Agent Notes (의사결정 기록) | 693 — 25 제안됨 · 515 구현됨 · 11 거절됨 · 142 동결·아카이브됨 (1,385개 파일: 모든 노트는 영어/중국어 쌍으로 보관됨) |
| 각 규칙에서 링크된 번호 매겨진 사후 분석 | 10 |
실제 설명이 붙은 빈 선언, 출처 packages/code-runtime/code-runtime/src/invariant.ts:
/**
 * No runtime invariant: this package exposes no independent event sequence or mutable
 * data relation beyond contracts enforced at its owning seam.
 */
const install: InvariantInstaller = () => {}
이 비율을 다시 보라: 출력의 84%는 '주장할 불변 조건이 없음'을 명확히 밝힌 문장이다. 이걸 보는 동료는 낭비라고 할지 모르지만, 내가 보는 건 설계 전체다. 이 게이트의 산출물은 35개의 어설션이 아니라, 누구도 반박할 수 없는 184개의 침묵 대신, 인간이 이의를 제기할 수 있는 184개의 문장이다.
그리고 정말 아팠던 한 줄. 내가 지금까지 쓴 모든 드리프트 게이트를 정확히 꿰뚫는 문장이다:
런타임 불변성은 소유 관계를 명확히 검증해야 한다. 신뢰할 수 있는 이벤트 스트림이나 실제로 변하는 데이터를 점검하라. 서비스나 메서드의 단순 존재 여부, 플러그인 메타데이터, 부수 효과, 고정된 예시 등은 검증 대상이 아니다. 설득력 있는 관계가 없다면, 이유가 명확히 설명된 빈 선언이 오히려 정답이다.
내 하네스에는 문서화된 명령이 빠져 있으면 실패로 처리하는 드리프트 게이트가 있다. 설치된 CLI 해시가 소스와 다르면 실패로 잡아내는 닥터도 있다. 둘 다 결국 존재만 확인한다. 이름만 바뀌어도 잡지만, 처음부터 잘못된 모듈도 조용히 영원히 초록불로 통과시킨다. 내가 반복해서 배포하는 바로 그 결함이다. 6일 전, 945개의 테스트를 모두 통과한 이중언어 카드 리더를 배포했지만, 실제 결함 두 개는 직접 소리를 들어보고 나서야 발견했다. 존재 확인만으로는 문제를 잡을 수 없었다.
4. 1785년: 주장보다 계측기가 일한다
1785년 7월 8일, 샤토 드 뱅센느 안뜰에서 Honoré Blanc는 단순히 모듈식 부품을 만든 것보다 더 근본적인 실험을 했다. 그는 머스킷 자물쇠를 분해해 부품을 섞고, 다시 조립했다. 설계를 내세워 논쟁하지 않았다. 실제 부품을 증인들 앞에서 섞고 조립해 결과로 증명했다.
이를 가능하게 하려고 그는 63개의 게이지를 만들었다. 63대의 기계가 아니라, 63개의 검증 도구였다. Jean-Baptiste de Gribeauval은 이미 대포알용 go/no-go 게이지를 공식화했는데, 이 도구는 단순히 '크기가 맞는가'가 아니라, 부품이 허용 오차 범위 안에 들어가는지를 묻고, 받아들이거나 거부하는 두 가지 답만을 내놓는다.
그리고 냉정한 현실. Springfield Armory는 1810년대에 그 목표를 받아들여 1825년까지 11개의 마스터 게이지를 갖췄지만, 실제로 대량 생산 부품이 호환성을 갖춘 것은 1849한참 뒤였다. Blanc의 시연에서 진짜로 맞는 부품이 나오기까지 64년이 걸렸다. 병목은 아이디어가 아니라, 계측기였다.
이 관점 덕분에 나는 dsh를 제대로 읽을 수 있었다. "Everything is a plugin"이라는 구호는 1810년대 Springfield가 꿈꿨던 이상을 타입 시스템 언어로 다시 쓴 것에 불과하다. 진짜 중요한 건, 그들이 주장과 동시에 219개의 계측기와 36개의 검사 지점을 실제로 함께 내놓았다는 사실이다. 그리고 Blanc이 부품을 섞어 재조립했던 실연은, 이들의 테스트 정책에 고스란히 이어진다: "Registry contributions prove disposal through the HMR-safety test: dispose the fiber and observe removal."(번역: 레지스트리 기여는 HMR-안전성 테스트로 폐기가 입증된다: 파이버를 폐기하고 실제로 사라지는지 관찰하라.) 플러그인이 정말 언로드될 수 있는지는 코드를 읽어서는 알 수 없다. 직접 언로드해보고, 실제로 사라지는지 눈으로 확인해야 한다.
5. 1876년: 스스로 그은 한계선은 한계가 아니다
두 번째 역사적 사례는, 이 글을 단순한 흥미거리에서 내 작업에 대한 자가 진단으로 바꿔놓았다.
1870년대 영국 상선들은 고의로 과적되어 침몰했고, 보험금이 지급되었으며, 선원들까지 희생되었다 — 관선(coffin ships)이라 불렸다. Samuel Plimsoll은 1872년 왕립위원회를 이끌어냈고, 이어 Merchant Shipping Act 1876을 통과시켰다. 이 법은 하중선 표시를 의무화했다. 지름 12인치 원판에 18인치 선을 그어 선체 중앙 양쪽에 칠하게 한 것이다. 부두에서도 한눈에 보이는, 법적으로 강제된 명확한 한계선이었다.
하지만 1876년 법은 하중선을 선체 어디에 그릴지는 선주가 정하도록 남겨두었다.
상무부는 1886년에 하중선 기준표를 발표했고, 위치는 1890에서 법으로 고정되었으며 1894년에 추가로 확정됐다. 즉, "you must declare a limit"(번역: 한계를 반드시 선언해야 한다)와 "you do not get to choose your own limit."(번역: 스스로 한계를 정할 수 없다) 사이에 14년이 걸렸다. 첫 번째 법은 과적을 드러냈고, 두 번째 법이 비로소 그것을 막았다.
이제 이 사실을 염두에 두고 내 도구들을 다시 들여다본다.
- 내 에이전트 스킬 파일에는 테스트로 강제되는 바이트 예산이 있다. 그 숫자는 내가 정했다, 그리고 테스트의 실패 메시지에는 "when the required content genuinely needs more space."(번역: 필요한 내용이 정말로 더 많은 공간을 요구할 때 상한을 올릴 수 있다)라고 적혀 있다. 실제로 상한을 올린 적이 있다. 내가 그은 선이다.
- 내가 배포하는 모든 결과물은 주요 성과를 0~1로 점수화한 리포트 카드로 남긴다. 증거 등급이 점수의 상한을 정하고, 그 위에 실제 결과에 따라 또 한 번 바늘이 제한을 덮는다. 그런데도 결국 목표는 작성자인 내가 정한다. 내 작업 로그에는 이 미해결 이슈가 몇 주째 내 말로 이렇게 남아 있다: "the Mate still sets its own targets, and sets them low."(번역: 여전히 Mate가 스스로 목표를 정하고, 그 기준을 낮게 잡는다.) 진단만 하고 방치해 두었다.
dsh역시 예외가 아니다. 이 시스템의 doc-budget 매니페스트에는 내가 손수 고른 아홉 개의 정수가 들어 있다(AGENTS.md: 1950단어,docs/architecture.md: 2400 …) 그리고 자체 규칙에 따라 상한을 올릴 수 있다. Plimsoll선과 같다. 선주가 그은 선이다.
일반화할 수 있는 규칙은 150년 전 해운법이 명확히 해준다: 제약을 받는 당사자가 직접 정한 임계값은 통제가 아니라 공개에 불과하다. 둘 다 필요하지만, 실제로 배를 구하는 건 단 하나뿐이다. 자신이 어떤 쪽을 갖고 있는지 아는 것이 전부다.
6. 2024–2026: 문헌이 지적한 빈틈은 어디인가
Agent Harness Engineering: A Survey 는 170개가 넘는 프로젝트를 다음 기준에 따라 분류한다: ETCLOVG — 실행, 도구 인터페이스, 컨텍스트 관리, 라이프사이클/오케스트레이션, 관측성, 검증, 거버넌스 — 그리고 이 집계 결과는 내가 이미 서 있던 바로 그 지점을 정확히 가리킨다:
실행, 도구 인터페이스, 라이프사이클 오케스트레이션, 검증은 가장 촘촘하게 가시적 커버리지를 보인다… 관측성과 거버넌스는 오픈소스에서 상대적으로 빈약하다 그리고 상업적 플랫폼, SDK 기능, 엔지니어링 기술문 등에서 더 자주 등장한다. 이는 운영 통제가 런타임이나 벤치마크 인프라보다 늦게 성숙했음을 시사한다.
이 논문에서 내가 실제로 만들 계획을 바꾼 네 가지 발견:
대부분의 에이전트 실패는 모델 자체의 실패가 아니다. AgentFixer는 IBM의 CUGA 프로덕션 시스템에 15개의 검증 도구와 함께 배포되어 64~88%의 이슈 탐지율을 기록했고, 작업 실패의 38%가 파싱 오류에서 비롯된다 — 저자들은 이를 "결정적 검사로 충분히 해결 가능한 실패 모드"(번역: a failure mode fully addressable by deterministic checks)라고 설명한다. 실제 에이전트 시스템의 실패 중 3분의 1 이상이 순수하게 기계적 결함이었다. 이것이 게이트 도입의 실증적 근거이며, 취향이나 미감에 기대는 주장보다 훨씬 강력하다.
관찰하는 이는 많지만, 평가하는 이는 절반에 불과하다. 이 논문은 LangChain이 2026년에 실시한 설문을 인용한다: 팀의 89%가 관찰 도구를 쓰고, 52.4%만이 오프라인 평가를 수행한다. 저자들은 이를 관찰–평가 격차(observability–evaluation gap)라 명명하며, 그 결과를 정확히 이렇게 적는다: "teams can see what agents did without systematically judging whether the behavior was correct."(번역: 팀은 에이전트가 무엇을 했는지는 볼 수 있지만, 그 행동이 올바른지 체계적으로 판단하지 않는다.)
최종 점수는 잘못된 계측기다. §12.3에서: "a failed rollout may originate from model reasoning, a misleading tool schema, sandbox misconfiguration, stale context, flaky tests, benchmark ambiguity, judge instability, or orchestration loops."(번역: 실패한 롤아웃은 모델 추론, 오해를 부르는 도구 스키마, 샌드박스 오구성, 만료된 컨텍스트, 불안정한 테스트, 벤치마크 모호성, 평가자 불안정성, 오케스트레이션 루프 등에서 비롯될 수 있다.) 권고는 트레이스-네이티브 평가(trace-native evaluation) — 최종 점수가 아니라 트레이스를 1차 산출물로 삼는 방식 — 이며, 이는 미해결 과제(open problem)로, 아직 표준화된 실천은 아니다.
멀티 레포지토리 오케스트레이션은 생태계의 공식적 결손 지점으로 꼽힌다. 다섯 가지 '레이어 경계에서 반복적으로 드러나는' 격차 중 하나로, 비용 귀속, 실패 복구, 도구 간 상호운용성, 인간-에이전트 인계와 함께 언급된다. 내 플릿 도구 역시 지난 한 달간 그 틈새에서 이름도 모른 채 살아왔다.
그리고 같은 논문에서, 내가 가장 인기 없는 짓 — 내 프롬프트 텍스트를 지우는 일 — 을 소급적으로 정당화해주는 원칙이 하나 있다:
하네스-가정 원칙(harness-as-assumption principle). 모든 하네스 컴포넌트는 모델이 스스로 할 수 없는 것에 대한 가정을 내포한다. 모델이 발전할수록, 관찰 시스템은 에이전트의 실패뿐 아니라 하네스 컴포넌트가 불필요한 오버헤드(unnecessary overhead).
7. 세 영역, 그리고 실제로 구축한 것
네 개의 창이 한 문장으로 모인다:실제 관계를 주장하고, 실제 조립된 산출물에서 이를 증명하며, 저자가 기준을 정하게 두지 마라. 이 세 가지는 각각 하나의 프로그램으로 나뉜다. 나는 첫 번째를 이번 주에 직접 만들었다. 나머지 둘은 명세만 했고, 아직 구현되지 않았음을 분명히 밝힌다. 그렇지 않으면 6일 전 내가 저질렀던 실수 — 한 번도 실행해보지 않은 공개 API 기반 기능을 배포했다가, 설치 10분 만에 내 가정 두 개가 틀렸음을 깨닫는 일 — 을 반복하게 된다.
R&D 1 — 모듈별 불변성 선언 또는 설명, 게이트로 강제(구현됨)
anyagent invariants [repo] [--fleet] [--gate --baseline …]. 모든 모듈은 헤더에 두 가지 선언 중 하나를 반드시 명시해야 한다:
Runtime invariant: concatenating a text's segments reproduces that text EXACTLY, so
segmentation can never drop or duplicate a character.
@invariant-test: test_invariant_segmentation_is_lossless
…또는 명시적No runtime invariant: <reason>. 네 가지 상태가 있다:asserted (관계를 명시하고그리고 실제 존재하는 테스트를 함께 적음),declared (정직하게 비워두고, 그 이유를 설명함),absent (위반),broken (관계를 주장하지만 테스트를 명시하지 않거나, 존재하지 않는 테스트를 적음).
이 설계에서 반드시 지켜야 할 원칙 세 가지가 있다.정직한 공란도 커버리지로 인정한다 — 만약 이를 실패로 처리하면, 작성자는 게이트를 통과하려고 내용 없는 선언만 양산할 것이고, 이는 "여기엔 아무것도 없음"보다 더 해롭다.게이트는 품질을 평가하지 않는다: 불변성이충분히 좋은 불변성인지 여부는 리뷰에서 다룰 문제이고, 이를 자동으로 판정하는 스크립트는 결국 존재 확인만 한 단계 위에서 반복하는 셈이 된다.기준선이 없으면 통과시키지 않고 실패시킨다, 근거 없는 초록불이야말로 이 모든 작업이 막으려는 바로 그 결함이기 때문이다.
이 네 가지 불변성을 직접 작성하면서 바로 효과를 봤다. 내 언어 세그먼터가 손실이 없다고 주장하려면 실제로 깨뜨려봐야 했기에, 2만 개의 무작위 이중언어 문자열로 퍼징을 돌려보고, 실패가 일회성 오류가 아니라 재현 가능하도록 시드된 4,000개 케이스 버전을 커밋했다. 견뎌냈다. 하지만 선언에서 테스트를 반드시 명시하라고 요구하지 않았다면, 이 퍼징을 돌리지 않았을 것이다 — 불변성 선언이야말로 강제력이었고, 테스트 자체가 목적은 아니었다.
R&D 2 — 트레이스 기반 증거: 조립된 트랜스크립트 스냅샷(명세만 있고, 구현되지 않음)
dsh 반박할 수 없고 아직 구현하지 않은 규칙이 하나 있다:
모델에 노출된 정보 ⟺ 로그에 기록됨: 모델 요청에 도달하는 모든 정보는 세션 로그만으로 재구성할 수 있어야 하며, 새로운 모델 입력이 생기면 반드시 세션 이벤트가 남아야 한다.
…이 원칙은 런타임 불변 조건으로 강제되고, 이에 맞춘 테스트 규칙이 따라온다: "Package tests, e2e assertions, mock/test-only compositions, and PR rationale do not replace the assembled transcript."(번역: 패키지 테스트, e2e 단언, 목업/테스트 전용 조합, PR 근거는 조립된 트랜스크립트를 대체하지 않는다.) 그들의 커버리지 문서에는 내가 내 시스템에 새기고 싶은 문장이 추가되어 있다: "Line coverage is necessary, never sufficient — it proves lines ran, not that the feature works as shipped."(번역: 라인 커버리지는 필요조건일 뿐, 결코 충분조건이 아니다 — 코드를 실행했다는 증거일 뿐, 실제 기능이 제대로 동작함을 보장하지 않는다.) 그리고, 정말 마음에 드는 구절: "An uncovered line is often dead code the gate is correctly flagging for deletion, not a missing test to bolt on."(번역: 커버리지에 잡히지 않은 라인은 대개 삭제 대상인 죽은 코드이며, 게이트가 올바르게 삭제 대상으로 표시하는 것이다. 추가 테스트를 붙여야 할 부분이 아니다.)
내가 이 원칙이 필요하다는 증거는 최근에, 그리고 꽤 민망하게도 얻었다. 945개의 유닛 테스트가 모두 초록불이었지만, 실제 출력을 귀로 들어보고서야 두 가지 결함을 찾았다. 잘린 문장이 브리핑 한가운데 '더 말해달라'는 신호를 남겨, 시작도 전에 끝난 것처럼 들렸다. 단수로 써야 할 핵심 결과가 복수로 읽혔다. 둘 다 순수 함수의 유닛 테스트로는 절대 잡히지 않지만, 녹음 한 번이면 명확하다. Blanc는 도면을 들여다보지 않았다 — 부품을 섞어 조립했다. Springfield의 후계 규칙은 섬유를 폐기하고 실제로 제거되는지 관찰하라고 한다. 내 규칙도 이렇게 써야 한다: 조립된 출력을 재생하고, 그 차이를 비교하라.
R&D 3 — 외부 고정 임계값(명세만 있고, 아직 구현하지 않음)
Plimsoll의 교정. 내 시스템의 모든 임계값은 자체 설정 또는 외부 고정으로 분류하고, 자체 설정된 값은 어디에 보고되든 그 사실을 명확히 표시한다. 내가 정한 예산, 내가 매긴 목표, 내가 고른 커버리지 기준선 — 이 모두는 공개 정보이며, 실제로 그렇게 출력되어야 한다. 1876년에서 1890년까지의 교훈은 가시성이 먼저 오지만, 그 자체로는 충분하지 않다는 것이다. 솔직한 과도기적 조치는, 자기가 그은 선이 측량선처럼 읽히지 않게 하는 것이다.
8. 내 시스템에서 실제로 측정된 값: 0.27%
이 컴퓨터의 27개 저장소에 새 게이트를 적용했다. 첫 실행, 보정 없이:
| 대상 범위 | 모듈 수 | 선언된 것 | 침묵 | 커버리지 |
|---|---|---|---|---|
| anyagent(하니스 본체) | 178 | 4 | 174 | 2% |
| 플릿 — 27개 저장소 | 1,505 | 4 | 1,501 | 0.27% |
비교 기준: dsh 공개 첫날 219/219 달성.
이 숫자를 공개하며 두 가지를 짚는다. 첫째, 이 결과는 정확하다 — 내가 배포하는 모든 것을 평가하는 도구가 증거가 없으면 측정된 것이 아니다라는 원칙 아래, 자기 모듈에 반드시 참이어야 할 조건을 한 번도 선언한 적이 없었다. 메커니즘 없는 원칙은 그저 기분에 불과하다. 둘째, 이 수치는 래칫 방식이지, 절대값이 아니다: 침묵하는 모듈이 1,501개라면 절대적 게이트는 영원히 빨간불이고, 변하지 않는 신호는 아무도 읽지 않는다. 새로 추가된 침묵 모듈만이 주간 실행에서 실패 처리된다. 상속된 침묵은 숫자로 남는 부채이며, 이것이 백로그와 단순 분위기의 차이다.
네 가지 선언은 단순 존재 확인이 아니라 실제 관계를 명시한다. 세그멘테이션은 손실이 없음을 퍼즈로 검증했고, 재생 결과는 구성 요소를 보존한다. 모든 발화 주제는 영어와 중국어 양쪽에서 예산을 지킨다. 빈 음성 엔진 선택에도 반드시 이유가 붙는다 — 이 마지막 항목이 바로, 더 이상 도큐먼트 문자열의 약속이 아니라 데이터 속성으로 명시된 '조용한 폴백 없음' 규칙이다.
이 글을 쓰며 얻은, 반드시 남겨야 할 정정
이 글을 발행하며 내 CI가 두 번 실패했다. 두 번 모두, 내가 3,000자에 걸쳐 내 플릿에 없다고 지적한 바로 그 패턴이었다.
첫 번째: 프로모션 파일에는 반드시 URL, LinkedIn 게시물, 코멘트그리고 스레드가 모두 있어야 하며, 하나라도 빠지면 빌드가 실패한다. 나는 스레드 없이 배포했다. 두 번째가 더 본질적이다 — 아티클에는 네 개 언어 번역또는 명시적이고 날짜가 찍힌, 만료가 설정된 유예가 반드시 있어야 하며, 게이트의 에러 메시지는 이렇게 나온다: "no translation AND no explicit deferral — the silent-gap state this gate exists to forbid."(번역: 번역도 없고 명시적 유예도 없음 — 이 게이트가 금지하려는 침묵-공백 상태임)
이것이 invariant-or-explain이다. 내 포트폴리오 저장소에서는 몇 주째 이 규칙이 돌아가고 있다. 새 게이트에는 없는 만료 기능도 있다. 90일이 지난 유예는 실패 처리된다. 그래서 0.27%의 진짜 의미는 헤드라인 숫자보다 더 좁다 — 플릿 전체에는 모듈별 런타임 불변성이 거의 없고, 저장소 단위에서는 DeepSeek을 읽기 전부터 최소 한 곳에 이 규율이 실제로 구현되어 있다. 두 가지를 연결하지 못했다. 내가 쓴 게이트가 게이트에 관한 글을 발행하지 못하게 막을 때까지.
이것이 논증의 본질이다. 거꾸로 도달했다. 메커니즘은 이미 내 손에 있었지만, 어디에도 일반 규칙으로 이름 붙여져 있지 않았기에 나는 그것을 알아채지 못했다.어디에도 일반화된 규칙으로 명명된 적이 없었다. 남의 코드베이스를 읽는다는 건, 새로운 아이디어를 배우는 일이 아니라, 내가 이미 한 군데에서 쓰고 있었으나 보편화하지 않았던 개념에 이름을 얻는 경험이다.
9. 내가 의도적으로 따라하지 않은 것들
인상적인 레포지토리를 읽을 때 가장 흔한 실패는 무비판적 모방이다. 내가 손대지 않기로 한 세 가지와 그 이유를 적는다:
219개 패키지. 이 정도의 세분화는 팀 단위와 파일별 100% 커버리지 게이트가 있을 때 의미가 있다. 1인+에이전트 체제에서는 의식만 늘고 명확성은 줄어든다. 조직도를 흉내 내지 말고, 계측기만 가져와라.
693개 Agent Notes. 공개된 지 나흘밖에 안 된 레포에 이 정도 기록이 있다는 건, 목표라기보다는 긴 비공개 역사가 있었다는 뜻이다. 내가 진짜로 가져오려는 건 라이프사이클 — proposed/ → implemented/ → archived/, 폐쇄된 클래스 집합, 그리고 하나의 훌륭한 규칙: 아카이브된 노트는 영구 동결되며, 현재 동작의 근거로 삼아서는 안 된다. 오래된 문서가 진실인 양 인용되는 것, 이게 내가 겪었으나 이름 붙이지 않았던 실패 패턴이다.
"은유를 쓰지 말 것." 그들의 산문 기준은 은유를 금지하고, contract, boundary, shape 같은 단어 대신 정확한 명사를 요구한다. 계약 문서라면 그게 당연히 옳고, 나도 거기서는 따라 쓴다. 하지만 내 시스템은 모든 딜리버리를 하나의 이어지는 이야기 챕터로 의도적으로 서술한다. 체인지로그를 읽지 않을 독자를 위해, 등급과 근거는 항상 본문 옆에 원문 그대로 인쇄되고, 본문 안에는 들어가지 않는다. 두 규칙 모두 자기 영역에서는 옳다. 실수는 어느 쪽이든 모든 곳에 적용하는 것이다.
10. 실제로 어떻게 적용되는가
이번 주에 실제로 배포했다. 그래서 이 발견은 북마크로만 남지 않는다. 게이트는 명령어로 존재한다. 주간 플릿 워크플로가 여섯 차원 감사와 같은 래칫으로 이 명령을 돌리고, 결과 리포트를 아티팩트로 업로드한다. 기준선은 커밋되어 있고, 계약서는 업그레이드 플레이북 §8에 0.27% 측정치와 함께 들어 있다. 그리고 22개의 신규 테스트가 게이트와 네 개의 선언된 불변조건을 커버한다. 여기에는 기준선이 없어서 통과를 거부해야 하는 경우도 포함된다.
이것의 진짜 목적은 청소 프로젝트가 아니라 신규 작업을 위한 규칙이다. 새 모듈은 작성되는 순간 불변조건이나 그 이유를 선언한다. 저자가 '무엇이 항상 참이어야 하는가'를 아직 기억하고 있을 때다. 1,501개 모듈을 소급 적용하는 게 목표가 아니다. 그건 대부분 1,501개의 공허한 문장만 낳을 것이다. 목표는 이 숫자가 한 방향으로만 움직이게 하는 것이다.
정직한 한계선
- 나흘짜리 이력은 실적이라 부르기 어렵다.
dsh는 개발자 프리뷰 단계이며, 이렇게 못 박는다: "THERE WILL BE COMPATIBILITY-BREAKING CHANGES." 내가 다루는 것은 이 운영 규율이다. 내가 직접 읽고 세어볼 수 있는 것만 말한다. 내구성은 누구도 아직 알 수 없다. - 나는 그들의 게이트 논리만 분석했다. 실제로 그들의 게이트를 실행한 것은 아니다.내 집계는 파일시스템에서 직접 뽑았다 — 패키지, 동반 계측기, 설명이 붙은 빈 선언, 게이트 파일, 노트 등. 그들의 CI는 돌리지 않았다.
- 내 0.27%라는 수치는 내가 모듈을 어떻게 정의하느냐에 달려 있다.나는 엔진 소스 루트만 범위로 잡고, 테스트, 패키지 마커, 순수 타입 파일, 외부 라이브러리 트리는 제외했다. 모든 파일을 스캔한 1차 시도에서는 이 저장소에서 178개가 아니라 196개의 모듈이 나왔다. 범위가 달라지면 분모도 달라진다.
- 세 가지 프로그램 중 두 개는 아직 구현되지 않았다.R&D 2와 3은 명세만 되어 있다. 구현했다고 말하는 순간, 바로 내가 지난주에 저질렀던 실수를 반복하는 셈이다.
- 서베이의 수치는 모두 그들의 것이다. 내 데이터가 아니다.89%/52.4% 분할, 38% 파싱 오류, 64–88% 탐지율은 모두 해당 논문에서 명시적으로 인용한 수치다. 나는 그 어떤 것도 재현하지 않았다.
길 위에 남길 숫자 하나. Blanc의 실물 시연에서 대량 생산되는 호환 머스킷까지 64년이 걸렸다. "하중 한계선을 그려라"에서 "이제 네가 그 위치를 정할 수 없다"까지 14년이 더 걸렸다. 두 간극 모두 아이디어가 아니라 계측기를 만드는 데 쓰였다. 만약 당신의 하네스가 계측기 없는 플러그인 아키텍처라면, 당신은 1785년에 서 있는 셈이다 — 그 자체로 나쁠 건 없지만, 지금이 몇 년도인지는 알고 있어야 한다.
출처
- deepseek-ai/deepseek-harness — 저장소,
docs/architecture.md,AGENTS.md,packages/AGENTS.md,docs/testing.md,.agents/notes/README.md,scripts/. 2026-08-17 shallow clone 기준 집계; 메타데이터(147,620 stars · 15,083 forks · 2026-08-13 생성)는 같은 날 GitHub API에서 추출. - Cordis 및 A Programming Paradigm for Spatiotemporal Composability — 이 플러그인 프레임워크는
dsh위에 구축되어 있다. - Li, Xiao, Zhang, Liu 외,Agent Harness Engineering: A Survey(내가 읽고 인용한 판본; OpenReview에도
eONq7FdiHa로 공개되어 있으나, PDF 대신 브라우저 인증 절차가 있음) — ETCLOVG 분류 체계, 170개 이상 프로젝트 매핑, 관측성–평가 간극, 하네스-가정 원칙, §12 미해결 과제. - RUCAIBox/awesome-agent-harness — 해당 설문과 짝을 이루는 프로젝트 색인.
- Royal Museums Greenwich — Samuel Plimsoll과 선박 안전 그리고 Lloyd's Register Foundation Heritage — Plimsoll선이란 무엇인가? — 1876년 선박법, 선주 임의 표식, 1886년 무역위원회 표, 1890년 법적 위치 고정.
- 230년의 호환 부품 역사 그리고 go/no-go 게이지 — Blanc의 1785년 시연과 63개 게이지, Gribeauval의 허용오차 밴드, 1825년 Springfield의 11개 마스터 게이지, 1849년 호환성 달성.
- Chatterbox, Qwen3-TTS — 이번 주 내 증거로 언급한 라이선스 제한 음성 작업.