AI-NATIVEシリーズ · アーキテクチャ
ひとつのループで41コマンド——ツールがガラクタ箱に堕ちず成長する仕組み
私が管理しているツールには、41個のサブコマンドとひとつの制御ループがある。エンジンは109行。機能を増やすには関数を3つ書くだけでいい。このパターン、実例、そしてアドオンシステムの腐敗を防ぐ3つのルールを紹介する——どれもツール自体は不要だ。
1分でつかめる要点
これは何か 41コマンドまで膨らんでもガラクタ箱にならなかった個人用AIツールのアーキテクチャ——ひとつの共通制御ループに、機能を差し込む形で拡張していく。
なぜ重要か ガラクタ箱になる失敗はコーディングの問題ではない。成長するあらゆるシステム——チーム、カリキュラム、会社の業務——で、新しいニーズごとに専用の仕組みを作ると、既存の仕組みを着せ替える発想が消えてしまう。
あなたができること 今週直面している意思決定をひとつ選び、4つの項目に分けて書き出し、手計算で1行の算術をしてみてほしい。20分あれば十分だ。きっと自分のプランが思ったより脆い前提に乗っていることに気づくはずだ。
背景:ひとつのループという発想がすべてであり、これは私のツールの話ではない
これから書く内容はすべてひとつのコードベースから来ているが、そのほとんどはコード自体の話ではない。このツールは非公開で、あなたはインストールできない。だからこそ、もしこの記事の価値が「読者がそのツールを手に入れること」に依存するなら、それは単なる宣伝に過ぎない。そこで自分に課したテストは、ここで述べるすべての原則が「…そして私はそのリポジトリを見ることは決してない。」という一文を生き延びることだった。「…そして私はそのリポジトリを見ることは絶対にない。」
この話題は、すでに私たちが直面している問題そのものだ。あなたもきっと、成長し続ける何か——コードベース、チームの運用、教えている講座、家庭の仕組み——を維持しているはずだ。新しい要件はどれも一見バラバラに見えてやってくる。そして毎回、最も手っ取り早いのは、それぞれに専用の仕組みを作ってしまうことだ。
失敗の典型例——ニーズごとに新しい仕組みを作る
この失敗には明確なパターンがある。新しい要件が来るたびに、それぞれ専用の仕組み——独自のループ、独自のリトライルール、「完了」の独自定義、隣とは微妙に違うロギング——が増えていく。1つで済むところに6つのエンジンが並ぶ。(キッチンで言えば、カウンターが単機能家電で埋まり、それぞれが壊れやすい独自モーターを持つのに対し、1台のスタンドミキサーに単純なアタッチメントを付けるようなものだ。ただしこの例えは導入に過ぎないので、ここまでにしておく。)
誰も「ガラクタ引き出し」を作ろうと決めるわけではない。ガラクタ引き出しは、やめようと誰も決めなかったときに自然にできあがる。そして本当のコストは散らかりではなく、どれか一つを改善しても他には波及しないことだ。エンジンを共有すれば、すべての機能が一度に良くなる。
圧縮の発見——4つの機能は、実は4つの衣装を着た同じ機能だった
この話の転機は、目新しいアイデアではない。自分のコードを読み返していて気づいた、地味な発見だ。
4つの独立したループがあった。生成アプリの改善、コードベースのリファクタリング、成果物のリバースエンジニアリング、曖昧なクレームからプロダクトのヒントを掘り出すもの。4つの異なる領域で、数ヶ月おきに書かれ、互いにまったく無関係に思えた。
だが、実は全部同じ関数だった。似ているのではなく——本当に同じもので、4つすべてに一字一句同じガード句(ゼロ回のイテレーションを拒否する防御行)が入っていた。同じ防御コードを4回も無意識に書いていた——これは「抽出すべき」もっとも確かなサインだ。コードが似ているからではなく、同じ小さな予防策を独立して何度も再発明してしまうからだ。
そのすべての根底には、こういう流れがあった。
どこかから始めて、候補を提案し、自分の外側にある何かで評価する。より良ければ残す。これを上限つきで繰り返し、すべてのステップを記録する。目標に到達するか、改善が止まったら終了。
それだけだ。これがエンジンの核だ。アプリの改善、コードベースの整理、競合製品の分解、戦略の選定、システムのセキュリティ監査——全部同じ構造で、違いは「何を候補とするか」「何をより良いとするか」「何を許容するか」の3つの問いに集約される。何が候補か、何がより良いか、何が許されるか——この3つだけが違いだ。
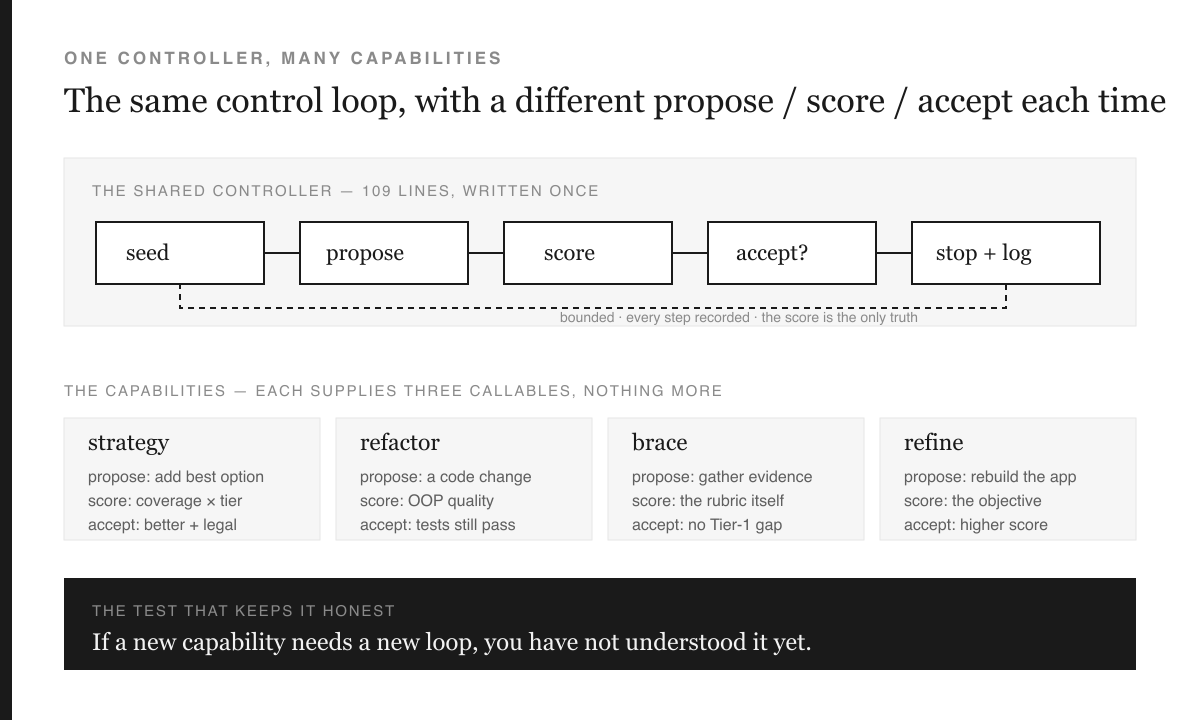
エンジンは、誰でも読めるほど小さい
共有コントローラーは、ドキュメント込みで109行しかない。そのコアはざっくり言えばこうだ。
best = seed
best_score = score(best)

while best_score < target and iterations_left:
    candidate = propose(best, i)
    candidate_score = score(candidate)
    if accept(candidate, candidate_score, best, best_score):
        best, best_score = candidate, candidate_score
    record(i, candidate_score, accepted)
3つの要素が本体を支えていて、それぞれどんな分野にも持ち込めるルールになっている。
上限は絶対に必要だ。ループは1未満のリミットでは絶対に作れない。「すべきでない」ではなく「できない」——拒否する。候補を提案できるプロセスは暴走しうるので、それを止めるのはコンストラクタであって、コードレビューではない。
評価する役割と提案する役割は、必ず分ける。 候補を作る役割と、それを評価する役割は分けなければならない。ストラテジー用のアタッチメントでは、これを構築時に強制している。両方に同じ関数を渡すと、次のメッセージとともに例外を投げる。"never self-certify"(訳:自己認証は絶対にするな)。このルールは、ソフトウェアの外では人がしょっちゅう破るものだ——計画を書いたチームが、その計画の成否まで自分たちで報告する、というやつである。
すべてのステップが記録される。却下されたものも含めてだ。 軌跡はアウトプットそのものであり、デバッグ用の副産物ではない。答えを知るだけではなく、その答えが何を打ち負かしたのかを知るほうが、はるかに価値がある。
第1段階──この先を読む前にやってみてほしい(2分)
自分が持っている繰り返し型のプロセスを一つ選んでほしい。たとえば採用、週次レビュー、下書きの編集、サプライヤー選定などだ。そのプロセスに必要な3つの関数を、声に出して挙げてみよう。提案 候補はどこから生まれるか?評価 何が、どのようにして「より良い」と決まるか──そしてそれは自分の外側にあるか?受理 評価が低かった候補を、どんな場合に残すのか?
たいていの人は、2つ目(評価)が抜けていることに気づく。それがこの演習の発見であり、失敗ではない。
実例:何をするかを決める
最新のアタッチメントを全文紹介する。なぜなら、ストラテジーという領域は「見せかけの厳密さ」が最も蔓延しやすく、隠しやすいからだ。
これに4つの要素からなるブリーフを渡す。目的、成功基準(それを達成したとみなせる条件)、実際に持っている証拠、そして検討中の選択肢を比較している。各証拠には「どう知っているか」のタグが付く:測定済み, 文書化済み, 既存データ(他人のデータ、自分のものではない)、または判断(自分の推測)。
ここでループを回す。Propose=まだカバーされていない基準を最も多く満たす選択肢を追加する。Score=算術一行で計算。Accept=より良く、かつ条件を満たしている場合のみ受け入れる。
これがスコアリングルールの全貌であり、ぜひ真似してほしい部分だ。
score = (criteria covered / all criteria) × weight(weakest evidence)

          measured 1.00 · documented 0.90 · prior 0.75 · judgment 0.50
カバレッジは「どこまで達成したか」。ティアの重みは「どれだけ信じてよいか」。そして両者は掛け算.
この掛け算こそがツールの主張のすべてだ。なぜそうするか説明しておく。もし平均を取ってしまうと、全てを推測だけでカバーしたプランが、測定に基づくプランの「やや弱い版」に見えてしまう——8割そこそこの出来、という具合に。だがそれは違う。同じ種類の弱い主張ではなく、まったく別種の主張だ。掛け算はそれを明確に示す:判断ティアでのフルカバレッジは、どれだけ完璧に見えても0.50で頭打ちになる。
実際の出荷例——新入社員のオンボーディング期間短縮という本物の意思決定——を走らせると、3つの選択肢を選び、4つ中4つの成功基準をカバーし、スコアは0.75。カバレッジは満点だが、それでもスコアの4分の1を失う。なぜなら、3つの選択肢のうち1つが社内で測定したものではなく業界ベンチマークに依拠しているからだ。
出力はそれをはっきり言葉にする:
score 0.750 at prior tier · 4/4 criteria · stopped on plateau
   ✓ devcontainer for the five main repos        [documented]
   ✓ CI gate on stale setup docs                 [documented]
   ✓ golden-path starter task                    [prior]
   → the claim is only as strong as its weakest evidence: prior
「すべてをカバーして『雑誌記事を根拠にしている』と明言するプランは、すべてをカバーして何も言わないプランより価値がある。」(訳:「A plan that covers everything and tells you it is resting on a magazine article is worth more than a plan that covers everything and says nothing.」)ディスカウントは掛け算で決まる。
さらに2つの挙動がある。どちらもエンジニアリングの顔をした倫理的な立場だ。
ハード制約は減点ではなく、そこで止まる。例の中のある選択肢は明示された境界を越えている——新入社員に初日から本番アクセスを与える案だ。ループはスコアを減らして「魅力的なら突破できる」ようにはしない。止まる、そして人間が名前入りで承認しなければならないと告げる。数値で上回れるものは、いずれ誰かが欲しいだけ大きな数字で上回してしまう。
計算式は、あえて地味で単調にしてある。 意思決定の瞬間に言語モデルは一切動かない。同じブリーフには、いつでも同じ答えが返る。レビュアーは鉛筆一本でスコアを再計算でき、機械の嘘も暴ける。自分で再計算できない推奨は証拠ではなく、見かけだけ立派な主張にすぎない。
第2段階——20分でできるバージョン(ツール不要)
実際に直面している意思決定を一つ選び、1ページに次の4つを書く:目的・成功を意味する3〜5の基準・検討中の全オプション・そして各オプションの横に「どの基準をカバーしているか」とその根拠(測定済み/文書化済み/他人のデータ/自分の推量)。
次に計算する:カバーした基準の割合 × 最も弱い証拠の重み その数値があなたのプランだ。ほとんどの人が最初に正直にやると0.35〜0.55の間に収まり、そのギャップはたいていカバレッジではなく——全体が誰も明言していなかった未測定の仮定一つに乗っている、という点にある。
さらに4つの機能も、同じループで回る
このパターンの価値は、「次の機能追加」が退屈なほど簡単になることだ。短い例を4つ挙げる。
コードベースのリファクタ。 コード変更案を提案し、その構造的品質をスコアし、テストがすべて通った場合だけ受け入れる。通らなければ巻き戻す。受け入れルールにこそ安全性が宿る。品質スコアだけなら、壊れたプログラムの形をいくらでも良くしてしまう。
セキュリティ基準に対するデプロイの監査。 これは、このパターンが本質的にソフトウェアの話ではないことを最もよく示している。公開されたコントロール・ルーブリックはアンケートのような見た目をしている。つまりスコアラーだ。それと気づいた瞬間、ルーブリックはスコア関数に変わり、ループが各項目の証拠を自律的に集め、コンプライアンス文書がビルドを落とすものへと変わる。これまで手渡されたあらゆるチェックリスト、基準、スコアガイドは、誰かが途中で作るのをやめたクローズドループである。
システムのエンタープライズ対応度をスコアする。 7つの柱があり、すべてのギャップにはそれを埋める正確なコマンドが出力される。次のアクションがない指摘は、単なる不満でしかない。
リフレクションを「測定可能な実践」として行う。 これこそが全体の誠実さを担保するものだ。確率と期日付きの予測台帳を持ち、解決時にスコアし、結論を失効させるつまり、信念は蓄積されるのではなく、再検証される。週次レビューは「どう感じたか」を問うが、Brierスコア付きの台帳は「本当に正しかったか」を問うし、記録し続ける。
アドオンシステムが腐敗しないための三つのルール
アドオンは、ほとんどのシステムが崩壊する原因だ。ブラウザ拡張、エンタープライズソフトウェア、チームのプロセス文書、「その他」フォルダ——どれも同じ。ここまで三つのルールが効いている。
ルール1——新しい機能は独自のループを持ち込んではならない。その機能が独自のループを必要とするなら、まだ本質を理解しきれていない証拠だ。これは強い主張で、時には間違うが、実際に間違う頻度は直感よりずっと低い。そしてこのルールが防ぐ失敗の方が、多少の摩擦よりもはるかに深刻である。
ルール2——境界はimportではなくseam(継ぎ目)で越える。ストラテジーアタッチメントは、どこかに意思決定グラフを書き出す。ただし「どこか」は知らない。port(抽象インターフェース)を持ち、別のアダプターが実ストアに接続する。ストアを差し替えても他は一切変えず、同じテストスイートを両方に流せる。
この理由を1972年にDavid Parnasが書いており、いまだにこれを超える説明はない:
"Its interface or definition was chosen to reveal as little as possible about its inner workings."(訳:そのインターフェースや定義は、内部の仕組みをできるだけ明かさないように選ばれている)
— D. L. Parnas, On the Criteria To Be Used in Decomposing Systems into Modules(訳:システムをモジュールに分割する際に用いるべき基準について), CACM 15(12), 1972 [R1]
彼の主張は美学ではない。彼は「変化」について予言していた。change(訳:変化)——最も変わりやすい設計判断から始め、それぞれをモジュールの中に隠す。そうすれば、何かが変わってもその変化はそこで止まる。54年後の今、私のツールで最も変わりやすい判断は、まさにseamの裏側にあるものだった。これは計画したのではなく、間違えた場所で発見した。
ストラテジーアタッチメントを作っている最中、私は自分の別リポジトリにある厳格なグラフストアに接続した。すると、その整合性ルールが私の書き込みを拒否した:decision nodes are human-authored only.(訳:意思決定ノードは人間が作成したもののみ許可)私は候補オプションの一覧を「decision」としてモデル化していたが、それは意思決定ではない。候補を提案するループは分析であり、「決める」のは人間の仕事だ。ルールが正しく、私のモデルが間違っていたので、モデルを修正した。これが本物のseam(継ぎ目)がもたらすものだ。向こう側のものが拒否でき、その拒否自体が情報になる。
ルール3——システムは所有者に「ノー」と言えなければならない。この話は次で詳しく述べる。なぜなら、誰もが賛成しつつ誰も実装しないルールだからだ。
第3段——居心地の悪いもの(10分)
今あなたの仕事に存在するルールで、文書・慣習・善意の中にしかないものを一つ探せ。「金曜はリリースしない」「すべての主張に出典をつける」「ベンダーは2件以上の推薦が必要」など。
何かが本当に拒否する仕組みを作る。たとえば、テスト、物理的にチェックを入れなければ進めないチェックリスト項目、送信できないフォームなどだ。そのうえで、自分のルールを破ろうとしてみて、実際に止められるか確かめる。発火しないルールは、ただの「好み」に制服を着せただけだ。
この仕組み全体を信じられる根拠
もしこれを売り物として勧める立場だったら、この節はきっと飛ばしていただろう。
このツールのマニュアルには、警告付きで2つのコマンドが載っている。どちらも未実装——「欲しいもの」であって「機能」ではない。 これらは実装前からドキュメントに書かれていた。こっそり段落を消すのではなく、そのまま残して警告文が追加された。実はこのエントリはマニュアルの中でもっとも役立つものの一つだ。なぜなら、将来の自分が存在しない機能を自信満々に提供しようとするのを止める役割を持っているからだ。
さらに厳しい例もある。システムには「毎回のセッション後に教訓を記録する自己改善ループ」があるとドキュメントに書かれていた。マニュアルにもそう書いてあった。だが、実際にあったのはファイル一つ、lessons.jsonl、そのまま凍結されて42件——およそ23回分の成果物を出荷する間、まったく手つかずのまま、ドキュメントだけは楽しげにループが動いていると説明していた。
ドキュメントにだけ存在し、実際には作られていないループは、静かに壊れているループと区別がつかない。これがすべての教訓であり、しかも容赦なく一般化できる:組織が「ある」と信じていて、一度も発火した現場を見たことがないプロセスは、今まさにこの状態にある。オンボーディングのチェックリスト。ポストモーテムのフォローアップ。四半期ごとのアクセスレビュー。
この段落を書きながら、念のためそのファイルをもう一度確認した。すでに修正されている事実を引用していないか確かめるためだ。
まだ42のままだ。
これこそが本稿でいちばん正直な一文だと思う——だからこそ残す。信頼できるシステム構築を語る記事が、著者自身の未解決の穴をこっそり省略していたら、それは本論の真逆を体現することになるからだ。
パターンとアンチパターン
| パターン | 置き換えるアンチパターン |
|---|---|
| コントローラーは一つ、各機能は三つの関数を提供 | 各機能が独自のループ・リトライ・ロギングを持ち込む |
| 上限はコンストラクタにあり、拒否できる | 「タイムアウトは後で追加しよう」 |
| スコアをつける役割と候補を出す役割は、はっきりと別のオブジェクトでなければならない | 計画を書いたチーム自身が、その計画の成否も報告してしまう |
| 証拠の質はスコアに掛け算で効く | 信頼度を平均してしまうと、推測ベースの案が上限を持たずに全体を薄めてしまう |
| ハードな制約は、人間による明確な停止で効く | ハードな制約が単なるペナルティ扱いだと、十分大きな数字で押し切れてしまう |
| 2つの実装が動くポート(抽象インターフェース)越しに境界をまたぐ | 直接インポートすると、依存先は拒否も交換もできなくなる |
| 実際に実行され、ビルドを落とすルール | 誰も発火したところを見たことがない、ドキュメント上だけのルール |
| レビュアーが手計算できるような、わざと単調な算術 | 意思決定の経路にモデルが入り込むと、答えが動いて監査できなくなる |
この原則を一文で
機能追加のコストは「関数3つ」で済むべきで、新しい機械を作るべきではない——そして、作ったものは必ず自分自身を拒否できなければならない。
この20分でやること
| やること | うまくいったかの確かめ方 | 期限 |
|---|---|---|
| 自分が持つ繰り返しのプロセス1つについて、「propose」「score」「accept」を日本語で言語化する | 3つすべてを一文で言え、スコア担当が自分でないと説明できる | 今日・2分 |
| 実際の意思決定を1件、objective・criteria・options・evidence-with-tiersで紙に書き出す | 1ページにまとめ、すべてのオプションに「どう知っているか」を明記する | 今週・20分 |
| カバレッジに最も弱いエビデンス層の重みを掛け算し、手で計算する | 0から1の間の数値が出て、その値を制限している要因を自分で説明できる | 同じ作業時間内 |
| 書かれたルールを、違反しようとすると本当に止められる仕組みに変える | 自分で違反を試みて、実際に止められることを確認した | 今週中、10分 |
| 自動で動いていると思い込んでいるプロセスを一つ選び、出力のタイムスタンプを実際に確認する | そのプロセスが最後に動いた時刻を、記憶ではなく証拠で把握している | 今日、5分 |
一番下の行が一番ヒット率が高い。静かな42が少なくとも一つは見つかる、と私は本気で思う。
参考文献
- Parnas, D. L. (1972). On the Criteria To Be Used in Decomposing Systems into Modules. Communications of the ACM 15(12), 1053–1058. PDF — quoted verbatim above; verified 2026-09-29.(訳:上記で原文通り引用。2026-09-29に検証済み)
- Conway, M. E. (1968). How Do Committees Invent? Datamation. melconway.com — "organizations which design systems (in the broad sense used here) are constrained to produce designs which are copies of the communication structures of these organizations", verified verbatim 2026-09-29. Why it belongs here: a junk drawer of capabilities is usually a picture of a team that never had one conversation about the shared motor.(訳:「ここで使われている広い意味でのシステムを設計する組織は、その組織のコミュニケーション構造の写しである設計しか作れないように制約されている」2026-09-29に原文通り検証済み。なぜここに載せるか:能力の寄せ集めが詰まったガラクタ箱は、たいてい共通エンジンについて一度も話し合ったことがないチームの姿である。)
- Brier, G. W. (1950). Verification of Forecasts Expressed in Terms of Probability. Monthly Weather Review 78(1), 1–3. 上記で述べた予測レジャーのスコアリングルールの出典。
執筆:Paul Jialiang Wu。本稿のすべての数値は2026-09-29時点でコードベースから直接拾ったものだ。41のサブコマンド、8つのループ、109行の共通コントローラー、1,035件の合格テスト、そして42で止まったままのレッスンファイルがひとつ。ツール自体は非公開なので、ここに書いた内容は何ひとつツール入手を前提にしていない。記述の内訳:数値は実測、三つのルールは設計上の立場、非ソフトウェア領域にも転用できるという主張は、ぜひ異論をぶつけてほしい推論だ。