AI-NATIVEシリーズ · HARNESSエンジニアリング
すべてはプラグイン。価値を生むのはゲージだ。
1分で読める
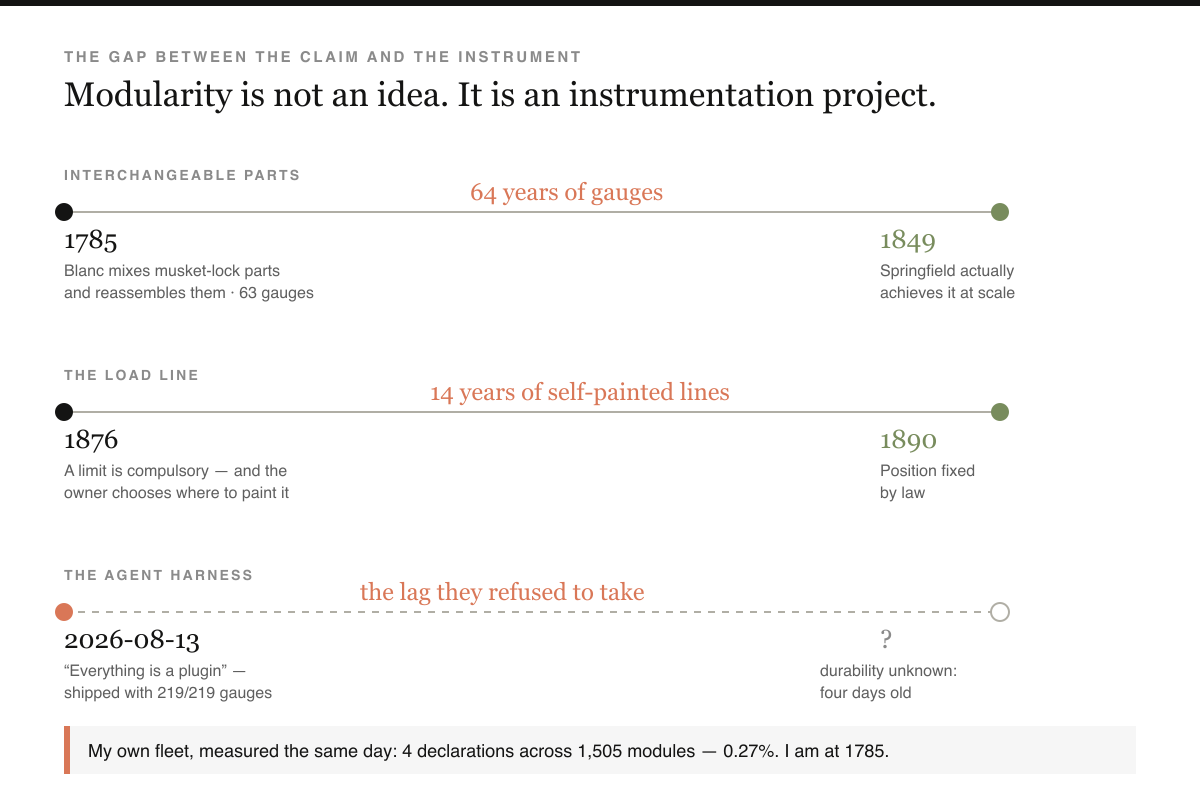
DeepSeekは8月13日にエージェントharnessをオープンソース公開し、4日間で147,620件のGitHubスターを獲得した。誰もが繰り返したスローガン——everything is a plugin——こそが、このリポジトリで最も本質から遠い部分だ。私は実際にクローンし、数を確かめた。内容は219個のパッケージと219個の不変コンパニオン、各パッケージごとに必ず1つ、例外なく、そのうち184件(84%)は「ここには主張すべきことがない」と、その理由まで文章で明示している。ゲートは説明のない空欄をはねる。これはアーキテクチャではなく、検査のための道具である。Honoré Blancは63本のゲージを1785年にマスケット銃部品の互換を実現するために用意したが、Springfield Armoryがその発想を取り入れてから実際に互換性を達成するまで1849、64年を要した。主張するのは簡単だが、実際に機能を担保するのはゲージのほうだ。そこで私は自分の手元のシステムにも同じゲートを設け、27のリポジトリに適用した。その結果は1,505モジュール中わずか4件の宣言——0.27%。この数字はあえて修正せずに載せている。なぜなら、2つ目の発見のほうがさらに深刻だからだ。Samuel Plimsollによる1876年のロードライン法は、船主がどこに線を引くか自分で決められるという抜け穴を1890年まで放置した。私自身の閾値も多くが、いまだに自分で引いた線のままだ。
1.4日間で147,620スター、そして的外れな見出し
deepseek-ai/deepseek-harness (dsh)が公開されたのは2026-08-13、MITライセンスの下で。8月17日にGitHub APIを叩いた時点で147,620スター、15,083フォーク、その朝に最後のプッシュがあった。報道はこれを競争的な一手と捉えた——Claude Coworkを狙ったオープンなランタイム、モデルの上位レイヤーを主張するモデル企業だ。
その見立てはおそらく正しいが、私には意味がない。スターの増加は広がりを示すが、エンジニアリングの質を示すものではない。だから私はリポジトリ自身のAGENTS.mdの推奨どおり——"We recommend using an agent to explore the codebase"(訳:コードベースの探索にはエージェントの利用を推奨します)——81MBをクローンし、参考にできるルールを探した。
ひとつ見つけて、思わずノートPCを閉じた。それは、ここ2週間ずっと文章で唱えてきた規律のための仕掛けであり、実際には一度も形にしたことがなかったものだった。
2. 実際に読んだものと、その読み方
自分が本気で手を動かす対象を見極めるための「4つの観測窓」:いま話題になっていること、現在、デモから標準になったもの(30か月)、いまだ現役で支えているもの(30年)、そして淘汰を生き延びたもの(300年)。最後の窓は単なる飾りではない。ただ耳障りがいいだけのアイデアを淘汰するのに十分な時間軸を持つ唯一の枠である。
参照するのは一次資料のみ。流し読みせず、すべて数え上げる:
- リポジトリ本体:
docs/architecture.md、ルートとパッケージAGENTS.md,docs/testing.md、.agents/notes/ツリー、scripts/、そして各カテゴリから実例をひとつずつinvariant.ts; - Agent Harness Engineering: A Survey — CMU、UAB、Tulane、Yale、Northeastern、Stanford、Amazon、UChicago、Virginia Tech、Rutgersによる37,794語のレビュー。170以上のOSSプロジェクトを7層の分類体系にマッピングしている;
- 長期2窓分の海事・製造記録は、記憶ではなく博物館や標準化機関の資料で照合した。
以下の数値はすべて自分で数えたものか、出典付きで引用したもの。検証できなかった場合はその旨を明記する。
3. 盗む価値のある唯一のルール
出典よりpackages/AGENTS.md、原文通り:
すべてのパッケージは所有する./invariant. マニフェスト名を登録し、イベント/データの関係を検証するか、空のインストーラーにはパッケージ固有のNo runtime invariant:理由を明記する。自動生成されたコンパニオン、説明のない空欄、無視されたレポーターは不合格とするverify-package-invariants.
彼らのツリーで私が実際に数えたもの:
| 項目 | 値 |
|---|---|
| パッケージ総数 | 219 |
コンパニオン付きパッケージ数invariant コンパニオン | 219 — 例外なし |
| 明示的に「No runtime invariant: …」と記載されたコンパニオン | 184 (84%) |
verify-* リポジトリゲート | 36 |
| それらのゲート用テストファイル | 46 — ゲートは多くのプロダクトよりも手厚くテストされている |
| Agent Notes(意思決定記録) | 693件 — 提案25件・実装515件・却下11件・凍結アーカイブ142件 (1,385ファイル:すべてのノートは英語/中国語ペアで保存) |
| 番号付きポストモーテム。各ルールからリンクされている | 10 |
実際の説明付き空欄、出典:packages/code-runtime/code-runtime/src/invariant.ts:
/**
 * No runtime invariant: this package exposes no independent event sequence or mutable
 * data relation beyond contracts enforced at its owning seam.
 */
const install: InvariantInstaller = () => {}この比率をもう一度見てほしい:アウトプットの84%は「主張すべきことはない」という署名付きの説明文だ。 これを見て「無駄が多い」と感じる人もいるだろうが、私には設計思想そのものが見える。ゲートの成果は35個のアサーションではなく、人間が異議を唱えられる184個の文であり、誰も気づかない184個の沈黙とは決定的に異なる。
そして本当に痛感した一文——それは、これまで自分が書いてきたすべてのドリフトゲートの本質を突いていた:
ランタイム不変条件は、所有する関係性を主張する。 権威あるイベントストリームや可変データを確認せよ。サービスやメソッドの存在有無、プラグインのメタデータや副作用、あるいは固定された純粋な例ではない。もっともらしい関係性がなければ、説明付きの空コンパニオンが正しい。
私のハーネスには、ドキュメント化されたコマンドが存在しない場合に落ちるドリフトゲートがある。インストール済みのCLIハッシュがソースと異なれば落ちるドクターもある。どちらも存在チェックにすぎない。リネームは検知できるが、静かに間違ったままのモジュールでも、永遠にグリーンで通ってしまう——まさに私が繰り返し出荷してきた失敗そのものだ。6日前、945件のテストがすべて通ったバイリンガルカードリーダーを出荷し、実際に2件の不具合を見つけたのは、実際に出力を耳で聞いたときだった。存在チェックが問題だったことは一度もない。
4. 1785年:主張は易く、ゲージこそが本質だ
1785年7月8日、ヴァンセンヌ城の中庭でHonoré Blancは、単なる部品のモジュール化を超える実験をやってのけた。マスケット銃のロックを分解し、部品を混ぜてから再び組み立てたのである。設計図を示して理屈を述べたのではなく、実物の部品を証人の前でシャッフルし、結果そのものを見せた。
そのために用意したのが63本のゲージだった。63台の機械ではなく、検査のための器具である。ジャン=バティスト・ド・グリボーバルはすでにカノン砲弾用のゴー/ノーゴーゲージを定式化していた。これは「サイズが合っているか」という単純な問いではなく、部品が許容範囲に収まっているかを問うもので、答えは「合格」か「不合格」の二択しかない。
ここからが現実だ。スプリングフィールド造兵廠は1810年代にこの志を受け継ぎ、1825年には11本のマスターゲージを揃えていた——だが実際に部品の互換性を実現したのは1849。Blancの実演から、大量生産で確実に合う部品ができるまで64年かかった。ボトルネックはアイデアではなく、器具だった。
この視点が、dshを自分の頭で読み解く鍵になった。「Everything is a plugin(すべてはプラグイン)」という標語は、Springfieldが1810年代に掲げた野望を型システムで言い換えたものにすぎない。だが本質的に重要なのは、彼らがその主張と同時に219個のゲージと36の検査ステーションを現実に揃えて出荷した点である。そしてBlancの「分解して混ぜて再組み立てる」実演は、彼らのテスト方針に直結している:"Registry contributions prove disposal through the HMR-safety test: dispose the fiber and observe removal."(訳:レジストリへの貢献はHMRセーフティテストによる廃棄で証明される:ファイバーを廃棄し、削除される様子を観察せよ) プラグインが本当にアンロードできるかどうかは、コードを読むだけでは分からない。実際にアンロードして、その挙動を目で確かめるしかない。
5. 1876年:自分で引いた限界線は限界にならない
2つ目の歴史的発見が、この記事を単なる面白い読み物から、自分自身の仕事の診断へと変えた。
1870年代、イギリスの商船は意図的に過積載され、沈没し、保険金が支払われ、乗組員ごと失われていた――coffin ships(棺桶船)。Samuel Plimsollは1872年に王立委員会を勝ち取り、続いてMerchant Shipping Act 1876(1876年商船法)を成立させた。これにより、船体中央部の両舷に直径12インチの円盤と、それを貫く18インチの線を描く「ロードライン」の表示が義務化された。埠頭からも一目で分かる、法的に定められた明確な物理的限界である。
しかし、この1876年法はロードラインを船体のどこに描くかを船主の裁量に任せてしまった。.
商務省が1886年にロードライン表を公表し、その位置は1890で法的に固定され、さらに1894年に最終的に確定した。つまり、「"you must declare a limit"(限界を宣言しなければならない)」から「"you do not get to choose your own limit."(自分自身の限界を自分で決めてはならない)」まで、14年の歳月がかかったということだ。最初の法律は過積載を可視化し、2つ目の法律がそれを実際に止めた。
この歴史を踏まえて、自分の手元の「計器」を見直してみる。
- 自分のエージェントスキルファイルには、テストで強制されるバイト数の上限がある。その上限値を決めたのは自分自身ださらに、テストの失敗メッセージ自体にも「必要な内容が本当にもっとスペースを要する場合は上限を引き上げてもよい」と明記されている。私は実際にその上限を引き上げた。結局、線を引いたのは自分自身だ。
- 私のシステムでは、すべての納品物がレポートカードとして記録され、主要な成果が0〜1でスコア付けされる。エビデンスの階層がスコアの上限を定め、さらに針が結果によってもう一度上限を決める——これが本当の制約である。ただし、目標値を決めているのは、結局のところ自分自身だ。この問題は、自分のキャンペーンログにも何週間も未解決のまま記録されてきた。自分の言葉で言えば:"the Mate still sets its own targets, and sets them low."(訳:相棒は依然として自分で目標を設定し、その水準も低くしている。)私はそれを自覚しながら、放置していた。
dshも例外ではない。doc-budgetマニフェストには、手作業で選んだ9つの整数(AGENTS.md:1950語、docs/architecture.md:2400 …)が並び、独自ルールで上限の引き上げも許可されている。これもまた、オーナー自身が引いたPlimsollラインに他ならない。
一般化できるルールはこうだ——そして、それを明確に言語化するには150年前の海運法が必要だった:制約される当事者自身が設定した閾値は、コントロールではなく「開示」にすぎない。どちらも意味はあるが、実際に効力を持つのは一方だけだ。自分がどちらを持っているかを見極めることがすべてである。
6. 2024〜2026年:文献が指摘する「穴」はどこか
Agent Harness Engineering: A Surveyは170以上のプロジェクトをETCLOVG(Execution, Tool interface, Context management, Lifecycle/Orchestration, Observability, Verification, Governance)にマッピングし、その総合的な知見は、まさに私がすでに立っていた地点を指し示している:
実行、ツールインターフェース、ライフサイクル・オーケストレーション、検証は、最も可視性の高いカバレッジが集中している……一方、オブザーバビリティとガバナンスはオープンソースでのカバレッジが薄いそして、それらは商用プラットフォームやSDKの機能、エンジニアリング記事などを通じて現れることが多く、運用コントロールの成熟はランタイムやベンチマーク基盤よりも後発であることを示唆している。
その論文から、私の設計計画を変えた4つの発見を挙げる:
エージェントの失敗の多くはモデルの失敗ではない。AgentFixerはIBMのCUGAプロダクションシステムに15のバリデーションツールとともに導入され、64〜88%の課題検出率を達成し、タスク失敗の38%はパースエラーが原因だった——著者はこれを「決定的なチェックで完全に対処できる失敗モード」と述べている。実運用のエージェントシステムで発生する失敗のうち、3分の1以上が機械的なものだった。これはゲートの実証的根拠であり、趣味的な議論よりもはるかに重い。
観察する者は多いが、評価する者はその半分しかいない。 本論文は、LangChainによる2026年の調査を引用している:チームの89%がオブザーバビリティを導入し、52.4%がオフライン評価を実施している。著者らはこれを「オブザーバビリティと評価のギャップ」と呼び、その帰結をこう明確に述べている:「teams can see what agents did without systematically judging whether the behavior was correct."(訳:チームはエージェントの行動を観察できるが、その振る舞いが正しかったかを体系的に判断していない)」
最終スコアは誤った計測手段である。 §12.3より:"a failed rollout may originate from model reasoning, a misleading tool schema, sandbox misconfiguration, stale context, flaky tests, benchmark ambiguity, judge instability, or orchestration loops."(訳:ロールアウトの失敗は、モデルの推論、誤解を招くツールスキーマ、サンドボックスの設定ミス、失効したコンテキスト、不安定なテスト、ベンチマークの曖昧さ、判定者の不安定さ、オーケストレーションループなどに起因しうる) 推奨されているのはトレースネイティブ評価——最終的な数値ではなくトレースそのものを主対象とする——そしてこれは未解決問題として挙げられている。
マルチリポジトリ・オーケストレーションは、エコシステム上の明確なギャップとして名指しされている。 これは「レイヤーの境界で繰り返し現れる」5つのギャップの一つであり、他にはコスト帰属、障害復旧、ツール間の相互運用性、人間とエージェントの引き継ぎが挙げられる。私の運用ツールも、このギャップに名前があると知らずに1か月間その中にいた。
そして同じ論文には、私が最も支持されない行動——自作プロンプト文の削除——を後付けで正当化する原則が一つある:
ハーネス=前提原則(harness-as-assumption principle)。 すべてのハーネス構成要素は「モデルが自力でできないこと」に関する前提をエンコードしている。モデルが進化するにつれ、オブザーバビリティシステムはエージェントの失敗だけでなく、ハーネス構成要素が不要なオーバーヘッド.
7. 三つの領域と、実際に作ったもの
四つの視点が一つの文に収束する:実在する関係を主張し、それを実際の組み立て出力で証明し、著者自身に基準を決めさせないこと。 これを三つのプログラムに分解できる。私は今週その一つ目を実装した。残り二つは仕様化だけしており、まだ作っていないとはっきり書く。なぜなら、そうしないと六日前にやったのと同じこと——公開APIに従って書いた機能を一度も実行せずに出荷し、インストール後10分で二つの前提が間違っていたと気づく——を繰り返すからだ。
R&D 1 — モジュール単位の「インバリアントまたは説明」宣言、ゲートによる強制(実装済み)
anyagent invariants [repo] [--fleet] [--gate --baseline …]。すべてのモジュールは、ヘッダーに次のいずれかの宣言を必ず含める必要がある:
Runtime invariant: concatenating a text's segments reproduces that text EXACTLY, so
segmentation can never drop or duplicate a character.
@invariant-test: test_invariant_segmentation_is_lossless…もしくは明示的なNo runtime invariant: <reason>。状態は4つに分かれる:asserted(関係を明示し、かつ 実在するテストを指定)、declared(正直な空欄、理由付き)、absent(違反)、broken(関係を主張するがテストを指定しない、または存在しないテストを指定する)。
この設計で守るべき判断が3つある。正直な空欄もカバレッジとして認める——これを失格扱いにすると、著者はゲートを通すためだけの空疎な主張を捏造し始める。それは「何もない」よりも悪い。ゲートは品質を判定しない:インバリアントが優れたインバリアントかどうかはレビューの論点であり、スクリプトがそこに踏み込めば、結局は一段上の存在チェックを再発明するだけだ。ベースラインがなければ失格とする。根拠のないグリーンが、この仕組み全体が防ごうとしているまさにその欠陥だからである。
4つのインバリアントを書いた時点で、すぐにその価値があった。自分の言語セグメンターがロスレスだと主張する以上、壊そうと試みる義務が生じ、2万件のランダムなバイリンガル文字列でファズをかけてから主張した。さらに失敗が再現可能になるよう、シード付き4,000ケース版もコミットした。耐えた。ただし、宣言でテスト名の指定を強制されなければ、そもそもこのファズは走らせなかっただろう。インバリアントこそが強制力であり、テストそのものではない。
R&D 2 — トレースネイティブ証拠:組み立て済みトランスクリプトのスナップショット(仕様のみ、未実装)
dsh には、自分が反論できず、まだ実装していないルールがある:
モデル可視 ⟺ ログ記録済み:モデルリクエストに到達するものはすべて、セッションログから再現できなければならない。新たにモデル可視となる入力には、必ず対応するセッションイベントが必要となる。
…これはランタイム不変条件で担保され、同じ方針のテスト規約が設けられている:"Package tests, e2e assertions, mock/test-only compositions, and PR rationale do not replace the assembled transcript."(訳:パッケージテスト、E2Eアサーション、モック/テスト専用の合成物、PRの根拠説明は、組み立てられた記録の代用にはならない) 彼らのカバレッジ文書には、私も自分の規約に刻みたい一文が加えられている:"Line coverage is necessary, never sufficient — it proves lines ran, not that the feature works as shipped."(訳:行カバレッジは必要条件であって十分条件ではない——それは行が実行されたことを示すだけで、機能が出荷時に正しく動くことの証明にはならない) さらに、見事なのは:"An uncovered line is often dead code the gate is correctly flagging for deletion, not a missing test to bolt on."(訳:カバレッジされていない行は、多くの場合ゲートが正しく削除対象として検知した死んだコードであり、追加すべきテストが抜けているわけではない)
私がこれを必要とする証拠は、つい最近の出来事で、しかも少々恥ずかしい。945件のユニットテストがすべてパスしても、出力を実際に耳で聞いて初めて2件の本物の欠陥に気づいた。短く切られた文が「もっと話して」と促す形でブリーフィングの途中に割り込み、始まる前から終わったように聞こえた。単数の主要成果が複数形として伝わった。どちらも純粋関数のユニットテストでは見抜けず、録音を一度聞けば一目瞭然だった。Blancは設計図を眺めず、実物の部品を混ぜて組み直した。Springfieldの後継ルールは「ファイバーを破棄し、削除を観察せよ」と定めている。自分のルールもこうあるべきだ:組み立てた出力をリプレイし、差分を取る。
R&D 3 — 外部固定しきい値(仕様のみ策定済み、未実装)
Plimsollの修正案。自分のシステム全体のしきい値はすべて、自己設定 か 外部固定 のどちらかに分類し、自己設定のものは必ずその旨を明示する。自分で決めた予算、自分で採点した目標、自分で選んだカバレッジバー——いずれも「開示」であり、そのように表示すべきだ。1876年から1890年の教訓は「まず可視化、だがそれだけでは足りない」。正直な暫定策は、自分で引いた線をあたかも公的な基準のように扱わせないことだ。
8. 私自身への計測結果:0.27%
このマシン上の27リポジトリに新しいゲートを適用した。初回実行、補正なし:
| スコープ | モジュール数 | 宣言済み | サイレント | カバレッジ |
|---|---|---|---|---|
| anyagent(このハーネス本体) | 178 | 4 | 174 | 2% |
| 自分の全体管理下にある27リポジトリ | 1,505 | 4 | 1,501 | 0.27% |
参考までに:dsh 公開初日に219/219を達成。
この数字を公開することについて二点述べる。第一に、これは正しい結果である——私が出荷するものすべてを「証拠がなければ測定されていない」という原則で評価するツール自身が、自分の各モジュールについて「常に満たすべき条件」を一度も宣言していなかった。仕組みのない原則は、単なる気分に過ぎない。第二に、これはラチェット式であって絶対値ではない。1,501個の沈黙したモジュールがあれば、絶対ゲートは永遠に赤のままになり、変化しないシグナルは誰も見なくなる。つまり、新規のサイレントモジュールは週次実行で検出されて落ちる。継承された沈黙は「数字付きの負債」として積み上がる——これがバックログと単なる雰囲気の違いだ。
この4つの宣言は、単なる存在チェックではなく、実際の関係を示している。セグメンテーションはロスレス(ファズ検証済み)、再生結果は構成要素を保持し、すべての発話トピックは英語・中国語の両方で予算内に収まり、空の音声エンジン選択には必ず理由が付く——この最後のものが、ドックストリングの約束ではなくデータの性質として初めて表現された「サイレントフォールバック禁止」ルールである。
この記事に関して私が負うべき訂正——公開作業中に得たもの
この原稿を公開する際、自分のCIを2度落としたが、そのどちらも、私が3,000語かけて自分の全体管理下に足りないと述べてきたパターンそのものだった。
一つ目:プロモファイルにはURL、LinkedIn投稿、コメントおよびスレッドが必須で、どれかが欠けるとビルドが失敗する。私はスレッドなしで出荷してしまった。二つ目はより良い失敗で——記事には4言語の翻訳または明示的・日付付き・期限付きの猶予が必要で、ゲート自身のエラーメッセージはこう出る:"no translation AND no explicit deferral — the silent-gap state this gate exists to forbid."(訳:翻訳も明示的な猶予もない——このゲートが禁じるために存在するサイレントギャップ状態)
これがinvariant-or-explainである。これは数週間前から私のポートフォリオリポジトリで稼働している。しかも新しいゲートにはない「90日超の猶予は失格」という期限もある。だから0.27%の正直な意味は、見出しの数字よりもさらに狭い——全体管理下にはモジュール単位のランタイム不変条件はほとんどなく、リポジトリレベルでは少なくとも一箇所、DeepSeekを読む前からこの規律が構築されていた。 自作ゲートが「ゲートについての記事」を公開するのを拒んだとき、初めて両者が繋がった。
これが逆方向からやってきた論拠である。仕組みはすでに自分の手の中にあったのに、それがどこにも一般則として「名前付け」されていなかったため、私はそれに気づけなかった。名前が与えられる それが一般的なルールとして明文化されている場所はどこにもなかった。他人のコードベースを読むというのは、たいてい新しいアイデアを学ぶことではない。自分がすでにどこかで使っていたのに一般化していなかったやり方に、名前を与えられる経験なのだ。
9. 意図的に真似しなかったこと
優れたリポジトリを読むと、つい模倣に走るという落とし穴がある。自分があえて手を出さないと決めたものが三つある。その理由も述べておく:
219パッケージ。 この粒度は、チーム体制とファイル単位の100%カバレッジゲートがあってこそ成立する。一人+エージェント体制でやれば、儀式ばかり増えて本質が見えなくなる。真似すべきはゲージであって、組織図ではない。
693 Agent Notes。 公開4日目でこの数というのは、長い非公開の歴史があったことを示しており、目標にすべきものではない。自分が参考にするのはライフサイクルだ——proposed/ → implemented/ → archived/クローズドなクラス集合、そして優れたルールが一つある:アーカイブされたノートは永久に凍結され、現行の挙動の根拠として扱ってはならない。古いドキュメントが真実として引用されるのは、自分も名前を付けていなかった失敗パターンだ。
「メタファーを使うな」 彼らの文体基準は比喩を禁じ、契約, 境界, 形状 のような曖昧な語ではなく、正確な名詞を要求する。契約文としてはまったく正しいので、自分もそこでは採用した。ただし自分のシステムは、すべてのデリバリーを一つの物語の章として意図的に語る。読者は変更履歴を読まない前提で、成績やエビデンスはそのまま横に印刷し、本文には混ぜない。どちらのルールも、その領域では正しい。どちらか一方を全領域に適用するのが誤りだ。
10. どう運用するか——記録だけで終わらせないために
今週リリースしたので、この発見がブックマークで風化することはない。ゲートはコマンドとして実装され、週次の全体ワークフローで六次元監査と同じラチェットで実行され、レポートはアーティファクトとしてアップロードされる。ベースラインはコミット済み。契約はアップグレード・プレイブックの§8に、測定された0.27%と並んで記載されている。さらに22個の新しいテストがゲートと4つの宣言済み不変条件をカバーし、ベースラインがない場合にパスを拒否すべきケースも含む。
能動的な側面は、新規作業のためのルールであり、後追いのクリーンアッププロジェクトではない。新しいモジュールは、その不変条件または理由を書いた時点で宣言する。著者が「常に真でなければならないこと」をまだ覚えているうちに、というわけだ。1,501モジュールを後付けで対応するのは目的ではなく、やれば1,501個の空疎な文が生まれるだけだ。目標は、この数が一方向にしか動かないことにある。
正直な限界
- 4日間の実績は、実績とは呼べない。
dshは開発者プレビュー段階で、「THERE WILL BE COMPATIBILITY-BREAKING CHANGES.」と大きく掲げている。私がここで扱っているのはその 運用規律 であり、私自身が読んで数えられるものだけだ。耐久性については、今の時点で誰にも分からない。 - 私は彼らのゲートのロジックだけを検証した。実際にCIを回したわけではない。 私のカウントはファイルシステム上の実体——パッケージ、コンパニオン、説明付き空欄、ゲートファイル、ノート——から得ている。CI自体は実行していない。
- 私の0.27%という数字は、モジュールの定義次第で変わる。 私はエンジンのソースルートのみを対象とし、テストやパッケージマーカー、純粋な型ファイル、ベンダーツリーは除外している。すべてを含めてスキャンした最初のパスでは、このリポジトリで196モジュールとなり、178とは異なる。どこまでを範囲とするかで分母が変わる。
- 3つのプログラムのうち、2つはまだ実装されていない。 R&D 2と3は仕様止まりで、実装はしていない。実装済みと偽るのは、まさに先週自分がやった失敗そのものだ。
- 調査の数値は先方のものであり、私自身のものではない。 89%/52.4%の比率、38%のパースエラー、64–88%の検出率はいずれも論文中の明記された出典から引用したもので、私自身が再現したものではない。
最後にひとつ数字を挙げておく。Blancの実演から互換マスケット銃の量産まで64年。「積載限界を宣言せよ」から「自分でその限界を決めてはならない」まで14年。どちらのギャップも、アイデアではなく計測器を作ることに費やされた。もしあなたのハーネスがゲージのないプラグインアーキテクチャなら、あなたは1785年にいる——それ自体は悪くない。ただし、今が何年かを自覚しているなら、という条件付きで。
出典
- deepseek-ai/deepseek-harness ——リポジトリ、
docs/architecture.md,AGENTS.md,packages/AGENTS.md,docs/testing.md,.agents/notes/README.md,scripts/。2026-08-17時点でシャロークローンからカウント取得。メタデータ(147,620スター・15,083フォーク・2026-08-13作成)は同日のGitHub APIより。 - Cordis および A Programming Paradigm for Spatiotemporal Composability ——このプラグインフレームワーク
dshの上に構築されている。 - Li, Xiao, Zhang, Liu ほか、Agent Harness Engineering: A Survey(私が読んで引用した版。OpenReviewにも掲載があり
eONq7FdiHa、そちらはPDFではなくブラウザ認証壁を通す)— ETCLOVG分類、170超のプロジェクト対応表、可観測性と評価のギャップ、ハーネス=前提という原則、§12の未解決課題。 - RUCAIBox/awesome-agent-harness — このサーベイの付録プロジェクト一覧。
- Royal Museums Greenwich — Samuel Plimsollと船舶安全 および Lloyd's Register Foundation Heritage — プリムソール・ラインとは何か — 1876年商船法、オーナーによる位置決定、1886年商務省の基準表、1890年に法で位置が確定。
- 230年の互換部品史 および go/no-goゲージ — Blancによる1785年の実演と63個のゲージ、Gribeauvalの許容帯、1825年時点でのSpringfieldの11個のマスターゲージ、1849年の互換性達成。
- Chatterbox, Qwen3-TTS — 今週自分で証拠として使ったライセンス制限付き音声ワーク。