AI-Native 系列 · 智能体工程全景对比:提示 · 上下文 · harness · 循环 · 图
提示工程是一份规范,不是魔法咒语
第 1 集(共 6 集)。本系列对比了构建 AI 智能体的五种工程路径——提示工程、上下文工程、harness 工程、循环工程与图工程:各自的起源、可控范围、主导者,以及哪些原则经得起实证检验。本集聚焦最早的那一级:提示工程,以及 2026 年的测量结果——它远未被“解决”。
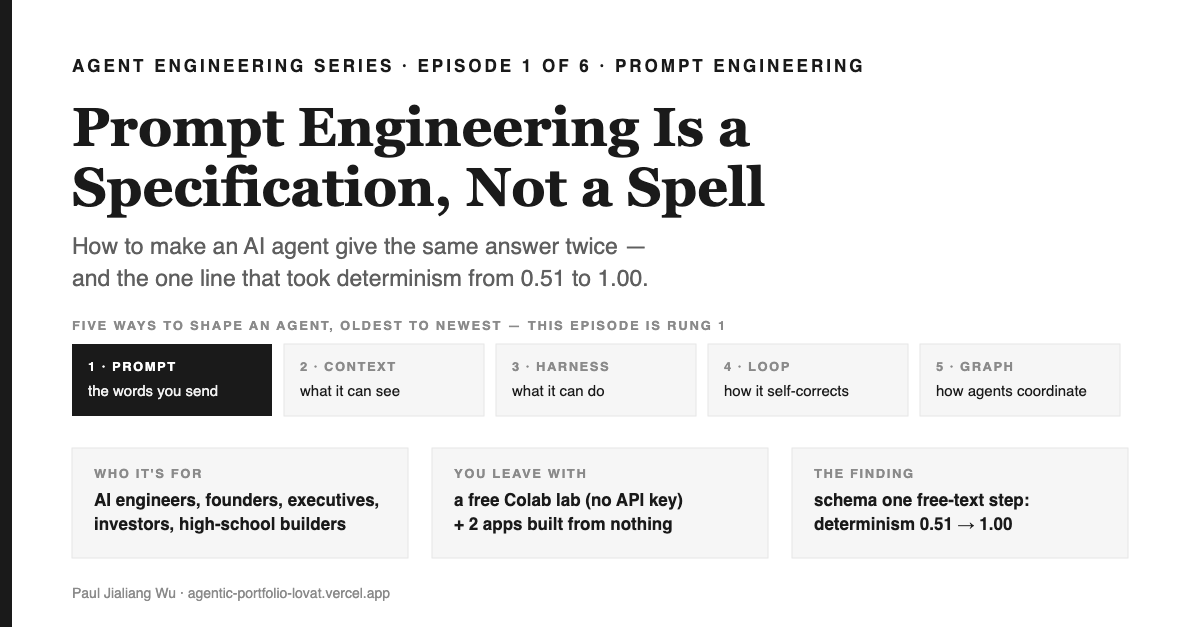
1 分钟速览 —— 你会获得什么
内容简介。 本系列对比了工程 AI 智能体的五种方式 —— 提示工程(你输入给模型的文本)、上下文工程(模型可获取的信息范围)、harness 工程(模型可调用的外部工具与资源)、循环工程(模型如何自我校正)、图工程(多智能体如何协作)。本集聚焦提示工程:回顾从 2020 年 GPT-3 到 2026 年的发展脉络、主要推动者,以及哪些原则经受住了实践检验。
为什么这值得关注 智能体面对同一请求却输出不同答案,这正是它们难以真正交付客户、通过审计、或被信任托管资金的核心障碍。2026 年的一项研究发现,问题的根源通常并非缺少某个框架,而是 某一个 未受约束的自由文本环节;只需为这一步加上 schema,复现率即可在 100 次运行中达到 1.000——四个实验单元中有三个如此,涵盖两个合成任务和两个开源模型,尚无独立复现;我们自己的路由器在六个合成工单上也复现了这一趋势(0.510 → 1.000)。对创业者而言,这就是从演示到产品的分水岭;对工程师来说,这是一个当天下午就能落地的修正。
读完后你可以做什么 将提示写成可检验的规范,测量其输出一致性的频率,定位导致波动的自由文本环节,并为其设置 gate。你将获得一个免费的 Colab 笔记本(无需 API key),以及两个从零实现的可用应用:一个购物清单生成器(首轮测量就暴露了我自己规范的不足),一个 IT 变更请求路由器(加上 CI gate 后确定性从 0.510 提升到 1.000,若不达标则直接阻断构建)。
Season 7 — 系列脉络
- 提示工程——规范,不是咒语 本集
- 上下文工程——预算,不是更大的窗口 第 2 集
- harness 工程——是 envelope,不是 agent 第 3 集
- 循环工程——是外部裁判,不是重试 第 4 集
- 图工程——是排班表,不是人设演员表 第 5 集
- 评估工程——这是真值函数,不是排行榜 第 6 集
本集内容与提示工程为何排在首位
目前,AI 智能体的构建已形成五大命名学科,出现顺序大致为:提示工程(2020)、循环工程(2022)、图工程(2023)、harness 工程(2024)、上下文工程(2025)。最清晰的公开表述见 Feng 等人的综述(arXiv:2608.21156),其排序依据是每一层允许你掌控的内容 ,而不是按年代先后:prompt → context → harness → loop → graph。本系列依此顺序展开,每集聚焦一门学科,并用同样的四个问题拆解:起源何处、具体可控范围、当前推动者,以及哪类失败会促使你迈向下一层。
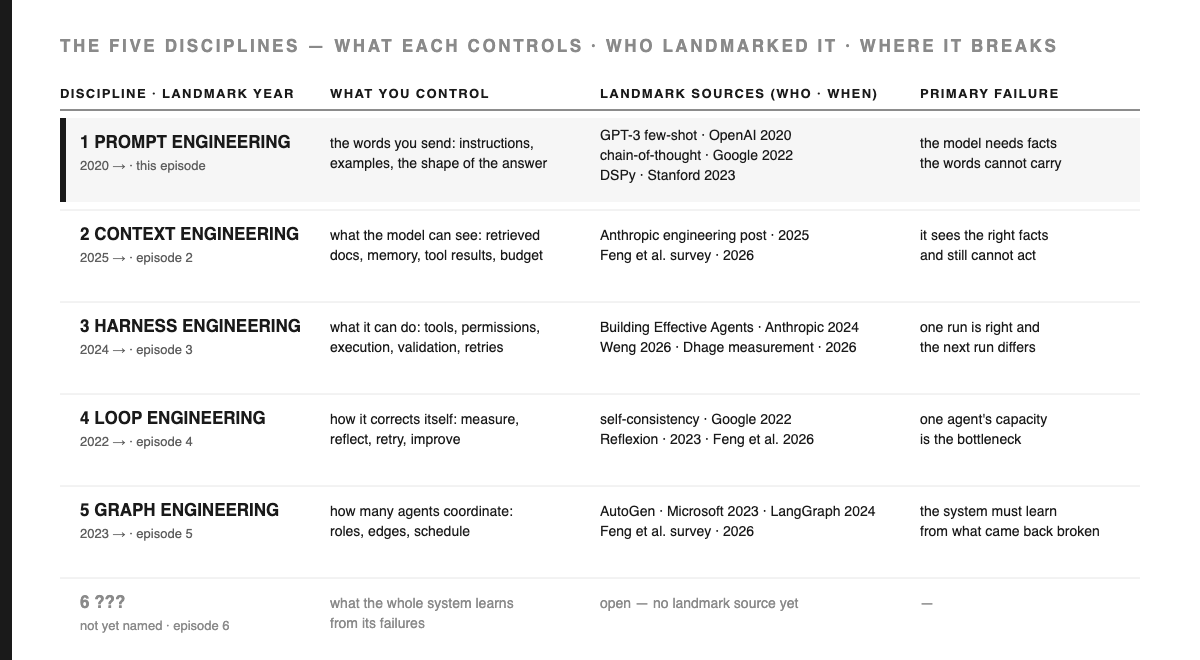
提示工程之所以排在首位,是因为其定义了所有更高层的边界。本集核心的 2026 年实证结果(Dhage,arXiv:2608.26197)原本旨在论证harness——也就是第三层——能够让智能体实现可复现。实际发现,剩余的输出差异全部源自模型仍被允许生成自由文本的那一步,而收紧这一 prompt 层面的环节,反而实现了 harness 所无法达到的效果。第一层无法被省略。
面向读者 本文适合需要同输入必得同输出的 AI 工程师、正在权衡 agent demo 能否转为产品的创始人,以及想要理解“提示工程”本质、拒绝玄学解释的高中开发者。唯一的前置条件是你曾调用过一次语言模型。
提示工程的起源与当前推动者
[DEF] prompt 指的是你提交给语言模型的文本,包括指令、示例,以及期望的答案格式。提示工程,是围绕如何编写这段文本,使输出严格符合需求的系统方法。定义止于此。历史,则是它如何从技巧演变为规范的过程。
| 时间 | 里程碑 | 作者 | 变革内容 |
|---|---|---|---|
| 2020-05 | GPT-3:Language Models are Few-Shot Learners (arXiv:2005.14165) | Brown 等人,OpenAI | 在输入中加入少量示例,无需权重更新即可引导模型。文本本身成为了控制界面。 |
| 2021-02 | Prompt Programming for Large Language Models (arXiv:2102.07350) | Reynolds & McDonell | 提出真正起作用的是提示的表达方式,而非示例内容。「Prompt programming」由此成为正式术语。 |
| 2021-07 | Pre-train, Prompt, and Predict 综述(arXiv:2107.13586) | Liu 等,Carnegie Mellon | 首次将提示作为独立于微调之外的范式命名。 |
| 2022-01 | Chain-of-thought prompting(arXiv:2201.11903) | Wei 等,Google Research, Brain Team | 提示中的特定句式能显著提升推理准确率。提示本身开始具备程序的特性。 |
| 2022-03 | Self-consistency(arXiv:2203.11171) | Wang 等,Google | 多次采样推理链,取多数结果:第一个由提示衍生出的循环结构。 |
| 2022-05 | “Let's think step by step”(arXiv:2205.11916) | Kojima 等,东京大学与 Google | “咒语”时代的高峰:一句话带来显著、可量化的影响。 |
| 2022-09 | “Prompt injection”命名(simonwillison.net) | Simon Willison | 提示成为攻击面,因此是安全属性,而非营销文案。 |
| 2023-03 | Prompt Engineering 调研(lilianweng.github.io) | Lilian Weng | 将各类技术系统化梳理,绘制成一张全景地图。三年后,这位作者又撰写了关于 harness engineering 的文章。 |
| 2023-10 | DSPy(arXiv:2310.03714) | Khattab 等,Stanford | 提示由声明式签名和指标自动编译生成。提示工程由此演变为带优化器的提示编程。 |
| 2024–25 | 主流模型实验室的提示工程指南(Anthropic, OpenAI) | 各大模型实验室 | 业界实践共识:指令需明确、给出示例、输出结构化、允许推理、复杂任务拆解为链式调用。 |
| 2025-03 | Promptware Engineering (arXiv:2503.02400) | Chen 等 | 将提示作为软件 artifact:具备需求、测试、版本管理和维护。 |
| 2026-08 | 五级阶梯(arXiv:2608.21156)与确定性实证研究(arXiv:2608.26197) | Feng 等;Dhage | Prompt engineering 被定位为五级体系的第一层——并被实证为依然是系统的核心约束。 |
[DESIGN] 这张表有三点值得关注。首先,这一领域起初并非工程学,而是 2020 年人们发现,仅靠输入的文字就能在无需重新训练的前提下引导模型。其次,「神奇短语」的黄金时代在 2022 年达到顶峰,2023 年底被 Stanford 的 DSPy 用声明式签名和优化器取代了手写 prompt。第三,实务界的权威指南——Anthropic 和 OpenAI 自己出的——最终都收敛到同一份简明清单:指令要明确、要有示例、输出结构化、允许模型先推理后作答、大任务拆解为链式调用。清单上的每一项都不是咒语,而是可校验的约束——这正是本期所采纳的定义。
当前的推动者 目前由模型实验室(OpenAI、Anthropic、Google)发布操作指南,并掌控系统 prompt。Stanford NLP 的 DSPy 以及软件工程领域的「promptware」项目,将 prompt 转化为有版本、可测试的软件工件。独立实践者则持续为行业把关——Simon Willison 在 2022 年首次提出 prompt injection,本文发稿前一天还在分析 Claude 最新的系统 prompt。而本期所依赖的测量数据,则来自一位独立作者在发稿前三周发布的实证研究。
本系列的核心比喻:厨房阶梯
有一幅图贯穿六集,这里用工具视角而非故事来展开。每位厨师都要经历同样的成长阶梯:先为自己做饭,再为家人下厨,接着进入餐厅厨房,之后管理快餐连锁,最终统筹全国供应链。AI 工程师的成长路径如出一辙——学生、初级开发者、资深开发者、AI 技术负责人、CTO、前沿领军者——每一级智能体工程对应厨房阶梯上的一个环节。第一阶是菜谱卡片。你写下卡片,厨师(你无法与之交流)按卡片做菜,你既不在厨房,也无法现场品尝。所有需求都必须事先写明,没有补充说明的机会:
西红柿炒蛋,两人份。三个鸡蛋、两个西红柿、3 克盐、1 茶匙糖。鸡蛋先炒至嫩滑盛出,再下西红柿——这样蛋才不会老。12 分钟内上桌。
这张卡片就是 prompt,厨师对应模型。每上一阶,对应你能干预的厨房环节就多一块——厨师用的食材和台面(上下文)、各工位、手边的工具与出菜口(harness)、试吃与纠偏(loop)、供应多家厨房的链路(graph)。本期你只负责卡片,其他部分都无法触及。食材、工具、卡片交出后发生的事,都不在你的控制范围内。
| 阶梯 | 厨房环节 | 对应身份 | 可控内容 |
|---|---|---|---|
| 1. prompt | 菜谱卡片 ——为自己做饭 | 学生 | 厨师手中的书面指令 |
| 2. context | 食材储藏间——为家人做饭 | 初级开发者 | 做菜过程中台面和冰箱可用的食材 |
| 3. harness | 餐厅厨房 | 资深开发者 | 各工位、可用工具、每道菜出菜前的检查环节 |
| 4. 循环 | 快餐连锁体系 | AI 技术负责人 | 品鉴、测量、修正,并将改进推广到每家门店 |
| 5. 图 | 全国供应链 | CTO | 多家厨房,一套排班表,一支运输车队 |
| 6. 评估 | 召回日志 | 前沿负责人 | 整个食品体系从被退回的菜品中获得的反馈——第 6 集会详细展开 |
两条维度,而非单一路径。 仔细看这张表,会发现这不是一条爬完就丢的阶梯:每个厨房其实始终具备六个层面。家常厨师有菜谱卡片、有储藏室、有灶台、有品鉴、有供应商。无论是厨师还是工程师,随着能力提升,真正变化的是 你被允许掌控多少层,以及你对每一层执行的严密程度:从凭经验,到量化,再到加 gate,最终实现自我纠错。一个全国连锁但只有漂亮供应链图、却没有品鉴环节的体系,成熟度还不如每盘都称重的单体餐厅。所以这五大工程其实是层次(你能控制的范围);资历体现为成熟度(你如何运行每一层);而“图”并不天然比“循环”更高级。第六层目前有一个有力的候选——评估工程,也就是其他层都要借用的“真值函数”——第 6 集会专门论证,而不是直接假定。
这个比喻可以用来引出观点,但不能作为论据——下方 1:1 技术映射表中,每个元素都能在代码中一一对应。本集的结尾,是这样一个发现:哪怕菜谱卡片写得再完美,做出来的菜依然可能各不相同,因为做菜时台面上从来不止有卡片。这正是第 2 集的主题。
这套阶梯并非我首创
[DEF] 术语体系需溯源明确——因为五个标签实际争夺同一领域,而多数流行清单都未能准确覆盖。
梯子的最权威公开表述,见 Feng 等人的综述(arXiv:2608.21156,2026-08-26 修订)。文中列出四个层级,并进一步论证了第五层:“Prompt Engineering to elicit model capabilities, Context Engineering to manage information access, Harness Engineering to organize external tools and resources, and Loop Engineering to support continual reflection and self-improvement”(中译:「提示工程用于激发模型能力,上下文工程用于管理信息访问,harness 工程用于组织外部工具和资源,loop 工程用于支持持续反思和自我改进」)——接着是 Graph Engineering,作者将其界定为System Intelligence,即当智能体的组织调度能力而非单体能力成为系统瓶颈时的分界点。
[DESIGN] 注意这对常见的四标签框架(prompt、harness、loop、graph)意味着什么——它实际上缺失了一层,而且这并非细枝末节。上下文工程位列第二,介于 prompt 与 harness 之间,也是实务文献中讨论最为充分的一环。第二集将专门聚焦于这一被清单文遗漏的层级。
[OPEN] 还需注意,这份综述并未断言各层级之间是递进替代关系。标签的表面顺序容易让人产生这种误解,本季将持续检验这一假设。上一季(第六季)曾专门验证过嵌套的观点——即 prompt 嵌入 harness,harness 驱动 loop,graph 协调 loop——但原始文献已否定这一结构,因为 Anthropic 的定义直接将 harness 视为 loop,而非其上一层。该结论依然成立。本季则进一步追问:当某一层出现问题时,下一层是否真能解决?
本集观点分类如下
[DEF] prompt 是一份规范。它不是请求,不是咒语,更不是“魔法词”——而是一份书面说明,明确规定输出需满足的条件,交由无法追问细节的执行者完成。
[EVIDENCE] 之所以要以字面意义理解这一定义,而非仅作比喻,是因为终于有了实证测量,其结果比行业经验更为清晰。
Dhage 的实证研究(arXiv:2608.26197,2026-08-25)旨在检验:为智能体加上一层确定性执行机制——有限状态控制、强制工具选择、输出校验、受控重试、结构化规划——是否能带来可复现性。实验覆盖两个合成任务(金融、法律),两个开源权重模型(Qwen-2.5-7B-Instruct 和 Gemma-3-27B),共四组模型-任务组合。
首次实验的结果并不理想,论文也坦率写明:harness "significantly improves reproducibility in one of four model-task cells, significantly degrades it in two, and has no effect in the fourth."(中译:在四个模型-任务单元中,harness 工程在一个单元显著提升了复现性,在两个单元显著降低,在第四个单元没有影响。)
请再读一遍。四个单元中,有三个要么没有改善,要么反而变差。团队加上了更多约束,结果 dashboard 依然报出问题。如果到这里就停下,最坦率的标题只能是:harness engineering does not work(harness 工程未能奏效).
[EVIDENCE] 接下来,trace 级诊断定位到了根本原因,这也是本集存在的核心。工具序列、状态序列和输出都已高度一致时,run-to-run 方差的主要来源只剩下:一个未受约束的自由文本规划环节。也就是 pipeline 里模型仍被允许生成自然语言的那一处。
只需对这一环节加以约束——"validating the plan against a fixed schema before any tool is invoked"(中译:在调用任何工具前,先用固定 schema 校验规划) — "eliminates the effect entirely: three of four cells reach a Reproducibility Rate and Determinism Index of 1.000 at N=100, and task success rises to 100% in three of four cells."(中译:完全消除了该影响:四个单元中有三个在 N=100 时复现率和确定性指数都达到 1.000,任务成功率也升至 100%。)
[DERIVATION] 因此,这一发现可以直接转化为可执行的原则:高阶环节再复杂,最终都受限于系统中最缺乏约束的那一段自然语言。确定性不是靠层层叠加获得,而是要定位到仍在输出自由文本的环节,并为其设定结构。
这是一个属于第一阶梯的问题,也需要用第一阶梯的方法来解决——而发现它的,正是本想论证第三阶梯的团队。
[DESIGN] 当然,这样做并非毫无代价,论文对此也有明确说明:"token cost falls in every cell, but latency shows a genuine, sample-size-robust split by model — one becomes faster under the constraint, the other markedly slower."(中译:每个单元的 token 成本都下降了,但延迟在不同模型间出现了真实且样本量稳健的分化——有的模型加约束后更快,有的则明显变慢。) 成本更低、可靠性更高,但速度可能变慢,具体取决于所用模型。论文的结论值得直接引用:harness 工程确实是一门独立的学科,"but its cost is model-dependent and must be measured, not assumed."(中译:但它的成本依赖于模型,必须实际测量,不能想当然。)
[OPEN] 上述所有结论有两个需要正视的前提:这只是一篇论文,涉及两个合成任务、两个 7B 和 27B 的开源模型,尚无独立复现。此外,“确定性”这个目标远比表面听起来复杂——系统每次都给出相同答案,并不代表每次都能给出正确的答案。复现性与正确性是两条独立的坐标轴,论文之所以都做了测量,正是因为二者可能完全背离。
1:1 技术映射
这个比喻中的每一个元素,都能在代码中精确对应到具体实现。比喻可以用来引出观点,但不能作为论据——所以这里给出逐项的技术映射,没有任何修饰成分。
| 厨房 | 系统 | 所在位置 |
|---|---|---|
| 递交给厨师的菜谱卡 | prompt——系统消息 + 用户消息 | messages[] |
| “3 g 盐” | 必须可校验的硬性约束 | 带边界的 schema 字段 |
| “这样蛋才会嫩” | 约束的原因 | 模型实际用来消解歧义的部分 |
| “12 分钟内上桌” | 厨房无法协商的截止时间 | 预算:tokens、墙钟时间、重试次数 |
| “按口味调整”——上面那张卡片特意没有写的那句话 | 唯一的自由文本环节 | trace 诊断定位到的未受约束的规划字段 |
| 厨师的判断 | 你未明确规定的所有内容 | 模型的先验——你真正的默认值 |
| 同一份菜谱,做出了两道不同的菜 | 每次运行之间的输出差异 | N 次运行中的复现率 |
| 菜品完全符合规范,却端给了对其过敏的人 | 满足了规范,却没有实现目标 | 你的断言覆盖得不够完整 |
| 出菜前的核查环节 | 输出验证 | 使用 JSON Schema 进行预检 |
[定义] 本季后续将反复引用的两个核心指标,定义如下:
- 复现率(Reproducibility Rate) ——在 N 次完全相同的运行中,输出字节级一致的比例。不涉及结果质量,仅衡量:同样的输入,能否得到完全一致的输出。
- 确定性指数(Determinism Index) ——同样的概念应用于 轨迹,而非仅看最终答案:工具调用顺序一致,状态变更序列一致,输出一致。
一个系统即便这两个指标都达到 1.000,也可能持续输出错误结果。这正是指标本身的设计特性,而非缺陷。它明确区分了 “是否稳定” 与 “是否正确”,而只有先解决前者,后者才有调试的基础。
预测门槛
请在继续阅读前,先做出你的判断并记录下来——这个环节的意义在于:没有写下来的预测,事后总会觉得自己猜对了。
选用一个能生成结构化输出的提示,提前写下二十条它的输出必须满足的断言:字段齐全、类型正确、枚举值合法、长度有界。将 temperature 设为 0,运行 100 次。
Q1. 有多少次的输出在字节级上完全一致?
Q2. 现在只做一个改动:要求模型先生成一个 plan,并且这个 plan 必须通过固定 schema 校验,之后才能调用任何工具。Q1 中的比例会发生什么变化?延迟又会如何?
Q3. 请按对 run-to-run 方差的减少效果从大到小,排列以下三项:(a)将 temperature 降为 0,(b)在提示文本中加入二十条明确断言,(c)对某个自由文本步骤进行 schema 校验。
答案见 Failure Room 和 Notebook。如果你对 Q3 的直觉排序和实际一致,这个 notebook 很值得你投入十五分钟。
Failure Room
有意制造失败。一个无法被你主动打破的机制,只是主张,不是真正的机制。
Failure 1 —— temperature 0 并不等于确定性。 这是本层最常见的误区,实际并非如此。temperature 0 让 sampling 变为贪婪采样;但这并不能让系统确定无疑,因为底层还存在批处理、GPU 内核非确定性、工具结果、时间戳、检索顺序等多种变因。Dhage 的四个 cell 都在受控环境下,依然出现足以写成一整篇论文的方差。如果你的可靠性论据只是“我们把 temperature 设为零”,那说明你还没有真正开始。
Failure 2 —— 那些你未曾写下的断言。 卡片上写着 3 g salt。厨师确实用了 3 克盐——但菜依然过咸,因为你只规定了盐,却没提酱油,而酱油自带咸味。每一份不完整的规范,在第一盘菜上桌前都显得无懈可击。这也是 notebook 要求你在 before 查看任何输出之前就写好断言的原因:事后补写的断言只是对结果的复述。
Failure 3 —— 过度规范反而消耗了你本该获得的能力。 反向极端就是另一种失败。把每个字段都限制死,禁止一切偏差,你就写出了一个极其昂贵的 if 说明书——一个机械照卡片执行、毫无厨艺判断力的厨师。你真正需要的是厨师的判断力。工程的核心问题从来不是 我还能加多少约束 ——而是 究竟是哪一个未受约束的步骤导致了最大的不确定性——这正是 arXiv:2608.26197 中跟踪级诊断用实证数据而非主观经验所解答的问题。
Failure 4 —— 1.000 的指标也可能毫无价值。让模型每次都输出 {},就能让复现率达到 1.000。这并不是玩笑,而是大多数奖励攻破的真实写照。任何确定性指标都必须与任务成功率同时报告,否则就成了作弊的温床。论文和 notebook 都给出了这两项指标。
Q3 的答案:(c),其次(b),最后(a)——而且差距非常显著。对某个自由文本步骤进行 schema 校验,让四个 cell 中有三个直接达到 1.000。把断言写进 prompt 文本,只能让模型更努力,但无法让输出真正可校验。测量方差时,temperature 0 已经启用。
Notebook
Lab 01 —— 方差,以及唯一能消除它的那一步。 
labs/01_prompt_as_specification.ipynb· Colab 免费版 ·无需 API key· CPU 约 15 秒 · 所有 cell 均在发布前实际运行。
共八个 cell。worker 是一个 stub,它的决策来自一个自由文本plan字段——这个设计选择就是整个实验的核心,因为决策上游的自由文本步骤带来的不是表面上的波动,而是直接改变了决策本身.
- worker 设计了四种与 plan 独立的打包失败模式,这样诊断工具就能分辨出决策发生了变化,而不是JSON 格式错误.
- 断言在看任何输出之前就以 schema 形式写好。在 查看任何输出之前。
- N=100 下的基线:复现率 0.280,确定性指数 0.330,任务成功率 0.890.
- 有界重试 —— 每个主流框架都默认实现的一行修正。任务成功率提升至 1.000,确定性提升至 0.440.
- 逐字段的追踪级诊断,定位方差来源。
plan,以及其下游的决策字段成为主导;ticket_id从未发生变化。 - 参数扫描,以及值得借鉴的那一格。调节自由文本步骤的不稳定性,观察两种干预方式的分化效果。
- 结构化规划 —— 在 决策读取之前 就对 plan 加以约束,并绘制对应曲线。
- 桥接:将同样的测量方法指向任意 OpenAI 兼容端点。
[EVIDENCE]让这个实验室值得搭建的结果就在第 6 格,而且和我写大纲时的预期完全不同。重试从未 降低 这个模拟器下任何设置的确定性——我原本以为会如此,结果是笔记本在运行时现算出来的,正是为了允许被数据推翻,结果它真的推翻了我。实际发生的情况更微妙,也更有启发:
| 上游漂移 | 基线 | 重试 | 重试带来的提升 | 计划校验环节 |
|---|---|---|---|---|
| 0.00 | 0.885 | 1.000 | +0.115 | 0.885 |
| 0.25 | 0.680 | 0.815 | +0.135 | 0.870 |
| 0.50 | 0.480 | 0.665 | +0.185 | 0.860 |
| 0.75 | 0.340 | 0.440 | +0.100 | 0.875 |
| 1.00 | 0.260 | 0.290 | +0.030 | 0.865 |
当上游步骤本身已经很稳定时,重试可以直接带来收益;但随着问题难度增加,这种优势会迅速消失。而计划校验环节则在整个区间内始终保持平稳,因为它是从根本上消除原因,而不是仅仅缓解表面症状。这正是结构性修正与临时补丁的本质区别——而如果你只在单一参数下测量,这一差异几乎无法被察觉,而现实中大多数人正是如此操作。
[设计] 为什么用 stub 而不是直接跑真实模型?第 1 季的实验室明确以机制为核心,“do not pretend a four-action bandit is an LLM”(中译:不要把一个四动作 bandit 当作 LLM 来看待)。模拟器可以在几秒内、免费、无需密钥地还原方差是如何进入系统、又是如何被消除的。但它无法还原真实的数值量级。notebook 里输出的所有数字都不能作为 Dhage 那个 N=100 时 1.000 结果的证据——那是用真实模型测出来的,只有论文本身才可作为引用。第 8 个 cell 是一座诚实的桥梁——只需设置两个环境变量,完全相同的测量代码就能跑在真实 endpoint 上。测量逻辑不变,变的只是 worker。
项目
两个完全从零实现的应用。无框架、无除标准库外的依赖。两者思路一致,但指向了截然不同的实际影响——而且都在本节写作前已实际运行,所以下面所有数字均为实测结果。
项目 1 —— 现实场景:the-grocery-slip
projects/01-real-grocery-slip/ · python3 measure.py 20
一个每周膳食计划转购物清单的生成器。很少有人会为这种需求写一份规范,这正是它适合作为第一个实验项目的原因:你能在一个出错代价极低的环境下,发现自己写下的断言远未覆盖全部情况。
prompt version : slip-v4
conformance    : 0.700   (14/20 passed every assertion)
reproducibility: 0.450   (identical output share)
[证据] 有三个问题暴露出来,README 在每次修复前都做了记录。
第 1 次运行——是我自己的 bug,不是模型的问题。 合规性检查全部未通过0.000。每次运行都失败。规范要求0 < qty <= 20针对每个单位,结果清单里却出现了500 克胡萝卜。约束本身没问题;问题出在粒度——“一户一周”用克计是 5000,用把计是 20,把两种单位混为一个数字,本质上是分类错误披着约束的外壳。修正后合规率提升到 0.700。第一次用可测量的规范,最先暴露的往往是规范自身的问题,这才是常态,也是为什么要先跑二十遍再相信任何结果。
第 7 次运行——这个项目的意义就在于让你发现这个盲点。清单里同时出现了milk和Milk,分属两个不同货架,所有断言都通过了。每一项单独看都合规,规范只检查了元素本身,没检查整体。它在错误的分析单元上实现了“完整”。我的购物清单每一项都合格,唯独不适合真正购物。
第 11 次运行——关于取舍。模型生成的清单,确实比规范允许的更优,我一度很想放宽断言,让这次运行也能通过。如果规范有误,应当有意识地单独修订,并记录原因。切勿为了某次喜欢的输出而随意调整规范。
项目二——企业应用:the-change-ticket
projects/01-enterprise-change-ticket/ · make compare · make gate
一个 ITSM 变更请求路由器:输入自由文本,输出结构化路由决策——风险等级、审批组、冻结窗口标记。六组黄金票据,每组 N=100。
[EVIDENCE]只变动了一个变量:
                        WITHOUT plan gate      WITH plan gate
determinism                     0.510                 1.000
conformance                     1.000                 1.000
escalation_recall               1.000                 1.000
make gate全部为 0。make gate去掉结构化规划后全部为 1。这正是论文在不同任务上的复现——注意,在未加干预时合规率已达 1.000。每个决策单独看都合规,但它们就是无法两次给出相同的决策,这正是所有单元测试都能通过但实际表现不稳定的典型故障。
30 分钟内完成——契约式实现
路由器所需全部内容,按工程师实际提问顺序排列。输入:自由文本。输出:一个Decision。不变式:只有规划通过 schema 校验后才允许做出决策。终止规则:规划被拒绝则升级处理,绝不重试。
PLAN_SCHEMA = {                       # the "to taste" step, given a shape
  "strategy":   enum["standard","expedited","emergency","reject"],
  "risk_tier":  enum["low","medium","high"],
  "freeze_hit": bool,
  "confidence": number in [0, 1],
}
def route(ticket, prompt_version):
    plan = model.plan(ticket)               # free text → structured plan
    if not validates(plan, PLAN_SCHEMA):    # 1 check, before ANY tool runs
        return escalate(ticket, "plan_rejected", prompt_version)  # no retry
    if plan.confidence < 0.60:
        return escalate(ticket, "low_confidence", prompt_version) # refusal path
    return decide(plan, prompt_version)     # deterministic given the plan

# CI gate (make gate): N=100 per golden ticket
#   determinism       == 1.000   (Decision.key() excludes decided_at)
#   conformance       == 1.000
#   escalation_recall == 1.000   (under-specified tickets escalate in ALL 100)
# any line below threshold → exit 1 → the build fails该模块有意省略的部分:被拒绝的规划不重试(重试会重新生成决策)、比较键不含时间戳(否则每次都唯一)、未接入真实模型(可随时替换model.plan 适用于任意 endpoint,测量代码无需调整。
[设计] 有四项设计,使这个方案具备企业级特征,而不仅仅是演示用例,每一项都不可或缺:
- 所有操作前必须先完成结构化规划。 规划方案需从四种已批准的路由策略中选择,并且要在 决策执行前完成验证。事后验证只能起到整理日志的作用。
- 被拒绝的方案不允许重试。 重试本质上是重新采样,会重新生成规划,也就意味着重新决策。被拒绝应直接升级处理,而不是再次尝试——notebook 的 sweep 结果显示,重试的收益在问题变难时会迅速降至 +0.030。
- 拒绝路径作为系统不变式被严格执行。 两张 golden ticket 是故意设计为信息不全的。当置信度低于 0.60 时,唯一允许的结果是升级给指定人类,并且
escalation_recall通过 1.000 的 gate,要求 100 次运行中全部 一致升级,而非仅以多数为准。 - 每条决策记录都需标注 prompt 版本。 审计员若要追溯 3 月份 #4471 路由到平台的原因,需要一个可复现的解释,这使 prompt 成为审计链的一部分,也成为有版本管理的规范——本集的核心观点正是从合规性角度切入。
[设计] 有一个值得讨论的选择。Decision.key() 明确排除了 decided_at:时间戳属于溯源信息,不属于决策内容,若纳入会导致每次运行都唯一,确定性指标将永远为 1/N。每一个确定性数据背后都隐藏着类似的取舍。如果你无法说明比较键排除了哪些内容及其原因,那你测量的就不是你想要的东西。
[开放] 这两组项目都未能直接证明什么。两套 golden set 都是合成数据,两个 worker 默认都是 stub。企业版的真实状态是可运行且已加 gate,而非已上线并有真实测量。要让它成为真正的产品,需要用历史工单及其实际路由结果采集一组黄金集,并在确定性旁边同步报告一致率——因为只有确定性、没有一致率的路由器,只会稳定地做出错误决策。
同一主题,五种切入
一条主线,每位读者一扇门。你只需选一个决策和一个行动,其余可暂且搁置。
| 你的身份是 | 本集聚焦的决策点 | 本周值得尝试的一步 |
|---|---|---|
| 高中开发者 | “提示工程”指的是写一份可检验的菜谱说明,而不是去寻找神奇咒语。 | 运行 Colab 实验(15 秒,无需密钥),然后把厨房阶梯的比喻讲给一位朋友。 |
| AI 工程师 | 确定性取决于你如何约束那一个自由文本环节,而不是不断叠加更多层。 | 用上文的规范在你自己的一个提示上实践,N=20 时加上 gate。 |
| 创始人 | 一个两次回答不一致的 demo 不能称为产品;修正它的成本低且效果可量化。 | 问你的团队:核心提示的复现率是多少?如果没人能说出这个数字,这本身就是一个重要发现。 |
| 管理者 | 可靠性本质上是审计问题:是哪一版提示做出了这个决策?结果能否复现? | 在下次架构评审中加入一项:“每条决策记录需标注提示版本号”。 |
| 投资人 | 真正的护城河在于可度量、可 gate 的规范,而不是团队租用的模型。 | 向任何 agent 创业公司同时索要确定性与任务成功率,两项并列。只给其中之一,等于没有答案。 |
现实行动
用十五分钟,聚焦你本周实际运行的某个系统。
- 挑选一个你真正依赖、日常使用的 prompt。
- 在查看任何输出之前,先写下它的输出必须满足哪些条件:字段、类型、枚举值、长度上限。尽量列出十条可检验的断言。你会发现这远比预期更具挑战性,而这种难度本身就是关键发现。
- 运行 20 次,统计断言未通过的次数,并记录下来。
- 定位流程中唯一还在生成无约束自由文本的环节——也就是你的“适量”。几乎总有且只有一个,而且往往并非你最初设想的位置。
- 为这一步添加 schema 约束,再运行 20 次,对比前后结果。
如果第 4 步没有发现任何自由文本环节,因为你的流程只有一次调用、没有 plan 步,那么你其实获得了更有价值的结论:你当前还未进入这条工程路径,下一集将更适合你。
研究挑战
把这个任务交给 agent,并在运行前预先登记你的预测——未记录的预测,事后总会被合理化。
以小规模复现 arXiv:2608.26197 的实验结构。选一个输出可校验的任务,在固定设置下先跑 N=100,建立基线的复现率和确定性指数。然后每次只引入一种干预,顺序随机:(a) 对 plan 步进行 schema 校验,(b) 强制工具选择,(c) 限定重试次数,(d) 增加输出校验。分别报告每项干预对确定性及任务成功率的边际影响,以及 token 成本和延迟。
预注册: 哪一项干预带来最大影响,以及延迟在两种模型上是否呈现相同趋势。
论文的结论是 structured planning 起主导作用,延迟则因模型不同而分化——有的更快,有的明显变慢。请先做预测,再验证。如果你在自己的任务上复现出不同的排序,这就是你与三周前新论文之间值得发表的分歧,而不是实验设置的 bug。
最新动态
本阶梯截至发稿时的进展。由每周同步 30 个前沿来源的实时 feed 自动生成research-anything (make watch-sync,仅按技术信号排序,从不以受众规模为序。
同步时间:2026-09-03。
- arXiv:2608.26197(2026-08-25)——本期所依托的实证研究,距截稿三周。
- arXiv:2608.21156v2(2026-08-26 修订版)——定义五级阶梯的综述,明确 context 工程是主流四标签框架遗漏的一环。
- Simon Willison (2026-09-02) — Claude's new system prompt really doesn't want to reproduce song lyrics:system prompt 依然是业内阅读量最高、版本管理最薄弱的软件制品。
- 更早但基础性的文献:arXiv:2401.14423 Prompt Design and Engineering;arXiv:2503.02400 Promptware Engineering;Lilian Weng 的 Prompt Engineering(2023-03-15),至今仍是对本阶梯技术最清晰的单篇综述。
[OPEN] 目前尚未有复现:至今尚无 arXiv:2608.26197 的复现性研究发表。这是一篇作者独立、仅覆盖两个合成任务的论文,是本期核心论点的全部实证基础——在有独立复现前,应据此审慎看待。
自查测试
请先自测,不要回头翻看内容。
- 按顺序写出五个已发表的阶梯,并指出主流四标签框架遗漏了哪一层。
- Reproducibility Rate 和 Determinism Index 有何区别?为何一个系统这两项都达 1.000,却依然可能毫无实际价值?
- 在 arXiv:2608.26197 中,第一轮 harness 让 reproducibility 在四个 cell 里有几个反而下降——又是哪一项关键改动解决了这个问题?效果变差,在四个实验单元中有多少出现了这种情况?又是哪一个具体改动解决了这个问题?
- 为什么 notebook 采用了 stub 而不是实际模型?这个 stub 在本质上无法作为你声称某些结论的依据?
- 如果有人说 pipeline 完全确定,只因为 temperature 设为 0,请给出三个不能因此成立的理由。
悬念时刻
你写下了一张近乎完美的菜谱卡片。
每个用量都明确限定且可检验,每条规则都写明了背后的原因,不只是列出要求。唯一的“适量”也被具体数字取代。你运行了一百次,Reproducibility Rate 显示 1.000,于是你短暂地相信自己已经彻底掌控了厨房。
但你把同一张卡片交给同一个厨师,这次换成了周五晚上,而不是周二早上。
你端上来的却是另一道菜。
卡片内容没变,厨师也没变。真正变化的是当时操作台上的环境——昨晚剩下半瓶的酱汁、还夹在轨道上的上一桌点单、以及有人放在盐罐旁边没盖盖子的罐子。
卡片从来不是厨房中唯一的决定性因素。
第二集——储藏室。 这正是流行的四标签列表所忽略的那一层,也是正式阶梯排在第二、并且目前生产智能体最容易出现高代价失误的环节。
推荐阅读
第 1 集,选自智能工程冒险,第七季——厨房阶梯本系列所有观点均按类别标注——定义、推导、证据、工程决策、开放问题。比喻可以用来引出观点,但不能作为论据。每一集都配有可在 Colab 免费运行、无需 API key 的实验笔记本,以及两个从零实现的应用——一个面向个人,一个面向企业。本文所用的“梯子”概念来自 Feng 等人(arXiv:2608.21156),并非我个人提出。「what moved」部分基于 30 个前沿来源的每周实时同步,按技术信号排序,从不以流量为序。本文不含任何雇主或客户的内容。——Paul Jialiang Wu · futuremake.io
参考文献
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. (2026)。Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2,修订于 2026-08-26。——五级梯子,原文引用见“The ladder is not mine”。
- Dhage, S. (2026)。Harness Engineering for Predictable Agentic Systems: An Empirical Study of Deterministic Execution Constraints. arXiv:2608.26197,2026-08-25。——1-of-4 / 2-of-4 的初步结果、逐步诊断,以及结构化规划在四个单元中有三个在 N=100 时达到 1.000。
- Chen, B., Zhang, Z., Langrené, N. 等 (2023)。Unleashing the potential of prompt engineering for large language models. arXiv:2310.14735。——技术综述。
- Amatriain, X. (2024)。Prompt Design and Engineering: Introduction and Advanced Methods. arXiv:2401.14423.
- Chen, Z., Wang, C. 等 (2025)。Promptware Engineering: Software Engineering for Prompt-Enabled Systems. arXiv:2503.02400。——“prompt 是软件 artifact”观点的完整论述。
- Weng, L. (2023)。Prompt Engineering. lilianweng.github.io,2023-03-15。——同一作者的 Harness Engineering for Self-Improvement (2026-07-04):一位作者,三个层级,七年跨度。
- Willison, S.(2026-09-02)。Claude's new system prompt really doesn't want to reproduce song lyrics. simonwillison.net.
- Brown, T. B., Mann, B. 等(2020)。Language Models are Few-Shot Learners. arXiv:2005.14165。—— 见历史表中的 2020 年标志性成果。
- Reynolds, L., McDonell, K.(2021)。Prompt Programming for Large Language Models: Beyond the Few-Shot Paradigm. arXiv:2102.07350.
- Liu, P., Yuan, W. 等(2021)。Pre-train, Prompt, and Predict: A Systematic Survey of Prompting Methods in Natural Language Processing. arXiv:2107.13586.
- Wei, J., Wang, X. 等(2022)。Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. arXiv:2201.11903.
- Wang, X., Wei, J. 等(2022)。Self-Consistency Improves Chain of Thought Reasoning in Language Models. arXiv:2203.11171.
- Kojima, T., Gu, S. S. 等(2022)。Large Language Models are Zero-Shot Reasoners. arXiv:2205.11916.
- Willison, S. (2022-09-12). Prompt injection attacks against GPT-3. simonwillison.net.
- Khattab, O., Singhvi, A. 等 (2023). DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines. arXiv:2310.03714.
- Shinn, N., Cassano, F. 等 (2023). Reflexion: Language Agents with Verbal Reinforcement Learning. arXiv:2303.11366——本系列表格中的循环工程代表作。
- Wu, Q., Bansal, G. 等 (2023). AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation. arXiv:2308.08155——本系列表格中的图工程代表作;LangGraph:github.com/langchain-ai/langgraph.
- Anthropic (2024-12-19). Building Effective AI Agents. anthropic.com/engineering——本系列表格中的 harness 工程代表作。
- Anthropic (2025-09-29). Effective context engineering for AI agents. anthropic.com/engineering——本系列表格中的上下文工程代表作。
- 提示工程相关指南(见历史表格描述,非直接引用):Anthropic · OpenAI.
- Liang, P., Bommasani, R. 等(2022)。Holistic Evaluation of Language Models. arXiv:2211.09110—— 系列表中评估工程的代表性文献。
- Zheng, L., Chiang, W.-L. 等(2023)。Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. arXiv:2306.05685—— 系列表中评估工程的代表性文献。
- Kapoor, S., Stroebl, B. 等(2024)。AI Agents That Matter. arXiv:2407.01502—— 系列表中评估工程的代表性文献。
- Intelligence Engineering Adventures,第六季 ——The Governor Engine,第 1 集和第 3 集,论证嵌套结构在实际中难以成立,以及现有标签体系无法完整表达系统稳定性。