AIネイティブ連載 · エージェントエンジニアリング徹底比較:プロンプト · コンテキスト · ハーネス · ループ · グラフ
プロンプトエンジニアリングは仕様であり、呪文ではない
全6回構成の第1回。本シリーズはAIエージェントを設計・構築する5つのアプローチ――プロンプト、コンテキスト、ハーネス、ループ、グラフエンジニアリング――それぞれの起源、制御できる範囲、推進者、そして計測で生き残る原則を比較する。今回は最も古い層であるプロンプトエンジニアリングと、「解決済みではない」とする2026年の計測結果を扱う。
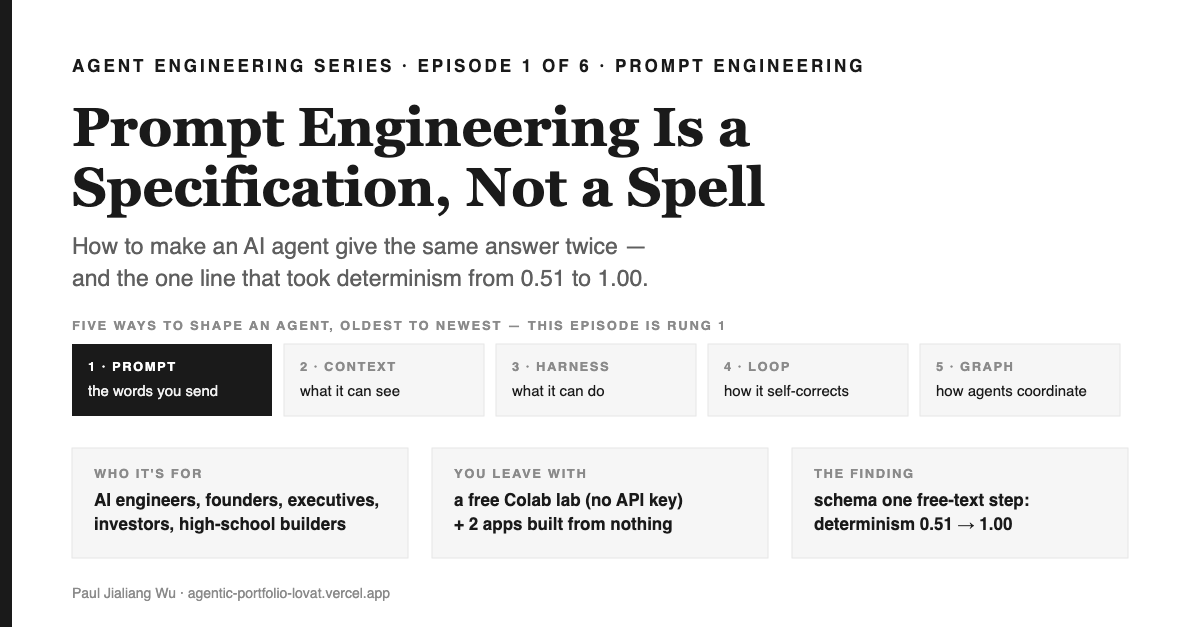
1分で掴む要点――この記事で得られるもの
この記事で扱うこと AIエージェントを設計する5つのアプローチを比較する連載――プロンプトエンジニアリング(あなたが送る言葉)、コンテキストエンジニアリング(見える情報)、ハーネスエンジニアリング(できること)、ループエンジニアリング(自己修正の仕組み)、グラフエンジニアリング(複数エージェントの連携)。本稿ではプロンプトエンジニアリングを取り上げる。2020年のGPT-3登場から2026年までの歩み、推進してきた人々、そして今なお有効な原則を語る。
なぜこれが重要なのか。 エージェントは同じリクエストに対して異なる答えを返す。この不安定さこそが、顧客への出荷も、監査の合格も、金銭を預ける信頼も阻んでいる。2026年の研究は、原因がフレームワークの不在ではなく、たった一つ 制約のないフリーテキストのステップにあると突き止めた。その一手にスキーマを与えるだけで、再現性は100回中100回=1.000に達した。4セル中3セル、2つの合成タスクと2つのオープンウェイトモデルで確認されている(独立再現は未報告)。自作のルーターでも、6つの合成チケットで再現性が0.510から1.000へと跳ね上がった。創業者にとってはデモと製品を隔てる決定的な溝であり、エンジニアにとっては今日中に直せる現実的な修正点である。
この記事を読んだ後にできること。 プロンプトを検証可能な仕様として書き、どれだけ同じ出力が得られるか測定し、分散の原因となる唯一のフリーテキストステップを特定してゲートを設ける。無料のColabノートブック(APIキー不要)と、標準ライブラリだけで動く2つの実用アプリが付く。1つは最初の計測で自分の仕様の誤りが発覚した買い物リスト生成器、もう1つは決定性が0.510から1.000に跳ね上がるCIゲート付きIT変更リクエストルーターだ。
Season 7 — シリーズの背骨
- プロンプトエンジニアリング——呪文ではなく仕様 この回
- コンテキストエンジニアリング——予算で考える、ウィンドウを広げる話ではない 第2話
- ハーネスエンジニアリング――エンベロープであってエージェントそのものではない 第3話
- ループエンジニアリング——再試行ではなく外部の判定者 第4話
- グラフエンジニアリング —— 配役ではなくスケジュール 第5話
- 評価エンジニアリング——リーダーボードではなく「正しさ」を決める関数 第6話
本稿の射程と、なぜプロンプトエンジニアリングが最初に来るのか
AIエージェント構築には今や5つの名付けられた分野があり、おおよそこの順で現れた。プロンプトエンジニアリング(2020)、ループエンジニアリング(2022)、グラフエンジニアリング(2023)、ハーネスエンジニアリング(2024)、コンテキストエンジニアリング(2025)。このセットを最も明確に定義したのがFengらのサーベイ(arXiv:2608.21156)であり、そこでは年次順ではなく各段階で何を制御できるか 年代順ではなく「何を操作できるか」で並べる:プロンプト → コンテキスト → ハーネス → ループ → グラフ。このシリーズはその順に各回で1つずつ取り上げ、毎回同じ4つの問いを立てる——どこから生まれたか、何を具体的に制御できるのか、誰が推進しているのか、どんな失敗が次の段階への移行を促すのか。
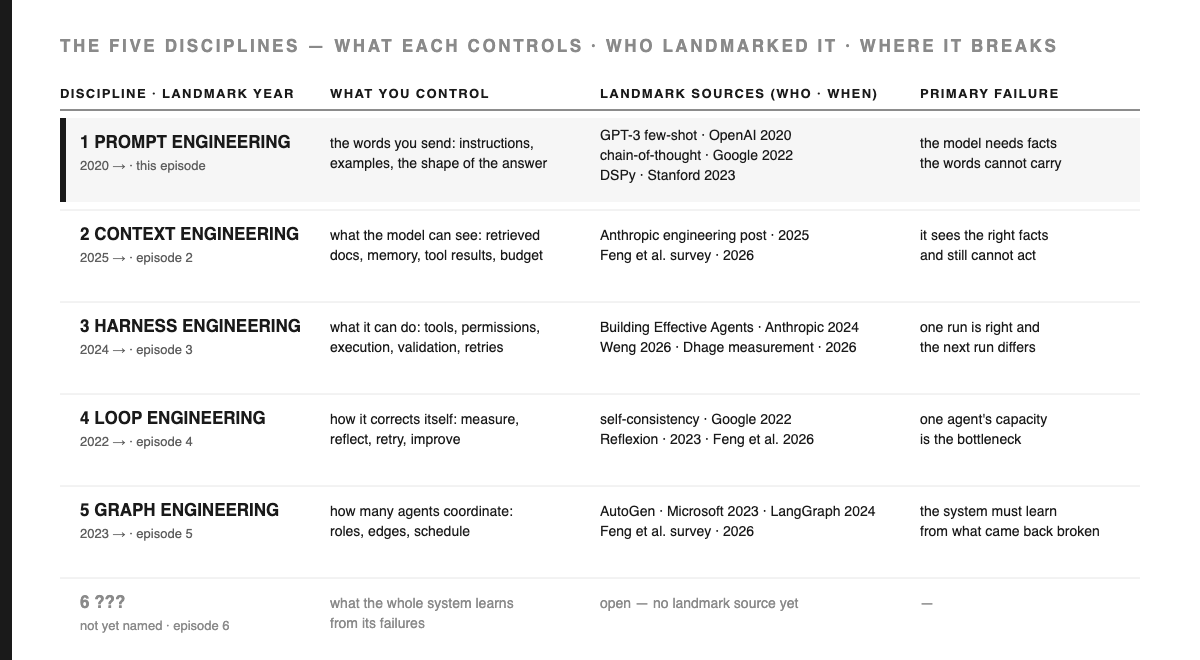
プロンプトエンジニアリングが最初に来るのは、以降のすべての層がプロンプトによって制約されるからだ。本エピソードの中心にある2026年の計測(Dhage, arXiv:2608.26197)は、ハーネス ——第3層——がエージェントの再現性を担保するかを検証しようとした。だが実際に残ったばらつきは、モデルがまだ自由に文章を書ける一箇所から生じていた。そのプロンプトレベルの一手順を制約することで、ハーネスでも解決できなかった問題が解消された。最初の階段を飛ばすことはできない。
このエピソードの対象 同じ入力から同じ出力を得たいAIエンジニア。エージェントのデモが製品化できるか判断したい創業者。「プロンプトエンジニアリング」とは何か、神秘性抜きで知りたい高校生。必要なのは、一度でも言語モデルを呼び出した経験だけだ。
プロンプトエンジニアリングの起源と牽引者
[DEF] プロンプトとは、言語モデルに送るテキスト——指示、例、そして望む出力形式——のことだ。プロンプトエンジニアリングは、そのテキストを「必要な出力が得られるように」設計する技術分野である。それがすべての定義だ。歴史は、それが単なる裏技から「仕様」へと進化した過程にほかならない。
| 時期 | 画期的な出来事 | 誰が関わったか | 何が変わったか |
|---|---|---|---|
| 2020-05 | GPT-3:Language Models are Few-Shot Learners (arXiv:2005.14165) | Brown et al., OpenAI | 入力にいくつか例を加えるだけで、重みの更新なしにモデルの挙動を誘導できることが判明。言葉が制御インターフェースとなった。 |
| 2021-02 | Prompt Programming for Large Language Models (arXiv:2102.07350) | Reynolds & McDonell | 例そのものではなく、枠組み(フレーミング)が本質だと論じ、「プロンプトプログラミング」という語が定着する。 |
| 2021-07 | Pre-train, Prompt, and Predict サーベイ(arXiv:2107.13586) | Liu ら、Carnegie Mellon | プロンプトをファインチューニングとは異なる独立したパラダイムとして明確に位置づける。 |
| 2022-01 | Chain-of-thought prompting(arXiv:2201.11903) | Wei ら、Google Research, Brain Team | プロンプト内の文型ひとつで推論精度が変わる。プロンプトがプログラムのように振る舞い始める。 |
| 2022-03 | Self-consistency(arXiv:2203.11171) | Wang ら、Google | 複数の推論チェーンをサンプリングし、多数決で決定する:プロンプトから初めてループが生まれる。 |
| 2022-05 | 「Let's think step by step」(arXiv:2205.11916) | Kojima ら、東京大学・Google | 呪文時代の頂点:たった一文で測定可能なほど大きな効果をもたらす。 |
| 2022-09 | 「Prompt injection」命名(simonwillison.net) | Simon Willison | プロンプトは攻撃対象、つまりセキュリティアーティファクトであり、マーケティング文ではない。 |
| 2023-03 | Prompt Engineering サーベイ(lilianweng.github.io) | Lilian Weng | テクニックが体系的に整理された。同じ著者が3年後にハーネスエンジニアリングの記事も執筆している。 |
| 2023-10 | DSPy(arXiv:2310.03714) | Khattab ら、Stanford | 宣言的なシグネチャと指標からプロンプトをコンパイルする。プロンプトエンジニアリングは、オプティマイザーを備えたプロンプトプログラミングへと進化した。 |
| 2024–25 | 主要ベンダーによるプロンプトエンジニアリングガイド(Anthropic, OpenAI) | モデルラボ | 実務家の定番:明確な指示、具体例、構造化された出力、推論の余地、タスクを分割してチェーン化する呼び出し。 |
| 2025-03 | Promptware Engineering (arXiv:2503.02400) | Chen ら | プロンプトをソフトウェアアーティファクトとして捉え、要件定義・テスト・バージョン管理・保守まで扱う。 |
| 2026-08 | 五段階ラダー(arXiv:2608.21156)および決定性の研究(arXiv:2608.26197) | Feng ら;Dhage | プロンプトエンジニアリングは五つの段階の最初に位置づけられ、今なお全体の制約条件であることが実測で示された。 |
[DESIGN] この表から読み取るべきことは三つある。まず、この分野は最初から「エンジニアリング」として始まったのではなく、2020年に「入力の言葉だけでモデルの挙動を変えられる」と発見されたことが出発点だった。次に、「魔法のフレーズ」時代は2022年に頂点を迎え、2023年末にはStanfordのDSPyが手書きプロンプトを宣言的シグネチャとオプティマイザに置き換え、その時代に終止符を打った。そして三つ目に、実務家の標準(AnthropicやOpenAIの公式ガイド)は、明示的な指示・例示・出力構造化・推論の余地・大きな作業の分割という、ごく短いリストに収束した。ここに呪文めいたものは一つもない。どれも出力を検証できる制約であり、本エピソードが拠って立つ「仕様としてのプロンプト」の定義そのものである。
今、その推進役は誰か。 モデルラボ(OpenAI、Anthropic、Google)はガイドを公開し、システムプロンプトを管理している。Stanford NLPのDSPyやソフトウェアエンジニアリングの「promptware」プログラムは、プロンプトをバージョン管理・テスト可能なアーティファクトへと進化させている。独立した実務家もラボの健全性を保っている——Simon Willisonは2022年にprompt injectionを命名し、本稿の入稿前日にもClaudeの最新システムプロンプトに注釈を付けていた。本エピソードの根拠となる計測は、彼らとは無関係で、入稿3週間前に投稿された単著の実証研究である。
シリーズ全体を貫く思考モデル:キッチンの階段
全六話を通して使う比喩をここで道具として提示する。料理人はみな同じ階段を登る——まず自分のために料理し、次に家族のため、やがてレストランの厨房で腕を振るい、ファストフードチェーンを運営し、最後は複数チェーンを支える全国サプライチェーンを回す。AIエンジニアも同じ構造を辿る——学校の学習者、ジュニア開発者、シニア開発者、AIテックリード、CTO、フロンティアリーダー。それぞれの段階が、エージェントエンジニアリングの一つの「キッチン」に対応する。最初の段はレシピカード。自分で書き、会話できない料理人がその通りに作る。あなたは厨房におらず、途中で味見もできない。欲しいものはすべて、事前にカードに書ききらなければならず、後からの確認や修正はできない:
トマトと卵の炒め物(二人分)。卵3個、トマト2個、塩3g、砂糖小さじ1。卵は最初に半熟で炒めて一度取り出し、その後トマトを入れる——卵が柔らかく仕上がるため。12分以内に食卓へ。
このカードがプロンプトであり、料理人がモデルである。上位の各分野は、キッチンの別の領域——料理人が使うパントリーやカウンター(コンテキスト)、各作業台や道具、パス(ハーネス)、味見と修正(ループ)、複数キッチンを支えるサプライチェーン(グラフ)——を操作できるようになる。このエピソードであなたが制御できるのはカードだけ。他の材料庫も道具も、カードを渡した後の工程も触れない。
| 段階 | キッチンの役割 | エンジニアの成長段階 | どこを設計できるか |
|---|---|---|---|
| 1. プロンプト | レシピカード ——自分のための料理 | 学校の学習者 | 料理人が参照する書かれた指示 |
| 2. コンテキスト | パントリー——家族のための料理 | ジュニア開発者 | 作業中にカウンターや冷蔵庫にあるもの |
| 3. ハーネス | レストランの厨房 | シニア開発者 | 各作業台、手の届く道具、すべての皿をチェックするパス |
| 4. ループ | ファストフードチェーン | AIテックリード | 味見・計測・修正・全店舗への展開 |
| 5. グラフ | 全国規模のサプライチェーン | CTO | 複数キッチンの統合運営、全体スケジュール、物流の一元管理 |
| 6. 評価 | リコールログ | フロンティアリーダー | フードシステム全体が「戻ってきた失敗」から学ぶこと——これはエピソード6で扱う |
軸は2つある。 この表をじっくり眺めてほしい。これは登りきって終わりの階段ではない。どのキッチンにも6層すべてが同時に存在している。家庭の料理人にもカードがあり、パントリーがあり、コンロがあり、味見があり、仕入れ先がある。料理人としてもエンジニアとしても、上に進むほど変わるのは、自分が手を入れられる層の数と、それぞれの層をどれだけ厳密に運用するかだ。感覚で回す段階から、計測し、ゲートを設け、自己修正する段階へと進む。見かけだけのサプライチェーン図があっても味見をしない全国チェーンは、全皿を計量する一軒のレストランよりも未熟だ。だから5つのディシプリンは「レイヤー」(何を制御できるか)であり、シニアリティは「成熟度」(どう運用するか)である。「グラフ」が「ループ」より自動的に高度というわけではない。開かれた第6層には有力候補がある——評価エンジニアリング、他のすべての層が「改善したか」を知るために借りる真理関数——であり、エピソード6ではそれを前提とせず議論する。レイヤー(制御できる対象)、シニアリティは成熟度(運用の厳密さ)であり、「グラフ」が「ループ」より必ずしも上位というわけではない。第6層には評価エンジニアリングという有力な候補があり、これは他の層が「改善したか」を知るための真理関数だ。エピソード6でこの点を論じる。
この比喩は主張の導入には使えるが、証拠にはならない——下の1:1技術マップで、すべての要素がコード上の何か1つに対応している。エピソードの最後では、どれだけ完璧に書かれたレシピカードでも違う料理ができてしまうことが明らかになる。なぜなら、調理時にカウンターにあるのはカードだけではないからだ。それがエピソード2のテーマである。
この階段の比喩は自分の発明ではない
[DEF] 用語は必ず出典とセットで示す。なぜなら、5つのラベルが同じ領域を巡って競合し、大半のまとめ記事がその全体像を誤って伝えているからだ。
このラダー構造について、最も明確に公表されたのはFengらによるサーベイ(arXiv:2608.21156, 2026-08-26改訂)である。ここでは4つの段階が明示され、さらに5つ目が提案されている:"Prompt Engineering to elicit model capabilities, Context Engineering to manage information access, Harness Engineering to organize external tools and resources, and Loop Engineering to support continual reflection and self-improvement"(訳:「モデルの能力を引き出すためのプロンプトエンジニアリング、情報アクセスを管理するためのコンテキストエンジニアリング、外部ツールやリソースを整理するためのハーネスエンジニアリング、継続的な内省と自己改善を支えるためのループエンジニアリング」) ——そしてGraph Engineering。著者らがSystem Intelligenceと呼ぶ、つまりエージェントの「能力」ではなく「組織化の力」こそが制約となる段階である。
[DESIGN] ここで押さえておきたいのは、よく見かける「prompt, harness, loop, graph」の4ラベル構成が、実は重要な1段を抜かしているという点だ。コンテキストエンジニアリングは2番目に位置し、promptとharnessの間にある。しかも実務家の文献で最も多く語られてきたのがこの段階だ。第2回は、世間のまとめが見落としがちなこの「抜けている段」を扱う。
[OPEN] さらに、このサーベイが「各段階が前の段階を必ずしも上書きする」とは主張していないことにも注意したい。ラベルの並びがそう読ませがちだが、今シーズンはその前提を問い直す。前シーズン6では、「ネスト構造」——プロンプトがハーネスの中にあり、ハーネスがループを回し、グラフがループを束ねる——という主張を検証し、Anthropic自身の定義が「ハーネス=ループそのもの」であり、上位層ではないことから、主要な出典によって否定されることが分かった。その結論は今も変わらない。今シーズンは新たに、「ある段階が破綻したとき、次の段階が本当に解決策になるのか?」という問いを加える。ある段階が破綻したとき、次の段階が本当に解決策になるのか?
この主張の分類
[DEF] プロンプトとは「仕様」である。依頼でも呪文でも「魔法の言葉」でもない。出力が満たすべき条件を明文化し、質問で確認できない作業者に手渡すための文書だ。
[EVIDENCE] この定義を詩的にではなく文字通り受け取るべき理由は、ついに誰かが実際に測定したことで、その結果が従来の通説よりもはるかに明快だったからである。
Dhageによる実証研究(arXiv:2608.26197, 2026-08-25)は、エージェントを決定的な実行レイヤー——有限状態制御、強制ツール選択、出力検証、リトライ回数制限、構造化プランニング——でラップすれば再現性が得られるのかを検証した。対象は2つの合成タスク(金融・法務)、2つのオープンウェイトモデル(Qwen-2.5-7B-InstructとGemma-3-27B)、計4つのモデル×タスクのセルである。
最初の試行結果は混乱そのものであり、論文もそれを率直に記している。ハーネスは"significantly improves reproducibility in one of four model-task cells, significantly degrades it in two, and has no effect in the fourth."(訳:4つのモデル・タスクセルのうち1つでは再現性が大きく向上し、2つでは大きく低下し、残り1つでは効果がなかった。)
もう一度読んでみてほしい。4つのうち3つのセルは、まったく改善しなかったか、むしろ悪化した。チームはガードレールを追加したが、ダッシュボードには不満が残った。この時点で止めていたら、正直な見出しはこうなるだろう。ハーネスエンジニアリングは効かない.
[EVIDENCE] だが、トレースレベルの診断が原因を突き止めた。それこそが、このエピソード全体の存在理由である。ツールのシーケンスも状態の遷移も出力もすでに高い一貫性を持っていたのに、実行ごとのばらつきの主な残存要因は制約されていないフリーテキストのプランニングステップだった。パイプラインの中で、モデルがまだ自由に文章を書ける唯一の箇所である。
その一点を制約する——"validating the plan against a fixed schema before any tool is invoked"(訳:どのツールも呼び出す前に、プランが固定スキーマに合致するか検証する) — "eliminates the effect entirely: three of four cells reach a Reproducibility Rate and Determinism Index of 1.000 at N=100, and task success rises to 100% in three of four cells."(訳:この効果を完全に排除した。4つのセルのうち3つで、N=100において再現率と決定性指数が1.000に到達し、タスク成功率も3つのセルで100%に上昇した。)
[DERIVATION] つまり、この発見を実践的なルールとして言い換えるなら、どれほど上位の仕組みを積み重ねても、システム内で最も制約の緩い言語部分が全体の限界になるということだ。レイヤーを増やしても決定性は得られない。唯一、まだフリーテキストを吐き出している箇所を特定し、そこに型を与えることでしか得られない。
これは、レベル1の問題にレベル1の解決策があったという話であり、レベル3の実証を目指していた人々によって発見された。
[DESIGN] そして、そのコストはゼロではないことを論文は丁寧に指摘している。"token cost falls in every cell, but latency shows a genuine, sample-size-robust split by model — one becomes faster under the constraint, the other markedly slower."(訳:すべてのセルでトークンコストは下がるが、レイテンシはモデルごとに明確かつサンプルサイズに頑健な分岐を示す——制約下で速くなるモデルもあれば、著しく遅くなるモデルもある。) より安価で信頼性は上がるが、どのモデルを使うかによっては遅くなる場合もある。論文自身の結論がまさに引用に値する:ハーネスエンジニアリングは確かに実体のある分野だが、"but its cost is model-dependent and must be measured, not assumed."(訳:ただしそのコストはモデル依存であり、測定されるべきものであって、想定で済ませてはならない。)
[OPEN] 以上すべてに対して、正直な限界が2つある。これは1本の論文、2つの合成タスク、7Bと27Bの2つのオープンウェイトモデル、独立した追試なし、という条件である。そして「決定性」という目標は響きほど単純ではない——毎回同じ答えを返すシステムが、毎回良い答えを返すとは限らない。再現性と正しさは異なる軸であり、論文が両方を厳密に測っているのは、それらがしばしば逆方向に動くからである。
1:1 技術マップ
この比喩の各要素は、コード上で明確に指させるものと1対1で対応している。比喩は主張の導入には使えるが、証拠にはならない——だからここでは、飾りを一切排した対応表を示す。
| キッチン | システム | どこに存在するか |
|---|---|---|
| 料理人に渡すレシピカード | プロンプト——systemメッセージ+userメッセージ | messages[] |
| 「塩3g」 | 必ず検証できる厳密な制約 | 上限付きのスキーマフィールド |
| 「卵が柔らかいままにするため」 | その理由——この制約の | モデルが曖昧さを解消する際に実際に使う部分 |
| 「12分以内にテーブルに出す」 | キッチン側が交渉できない締切 | 予算:トークン数、実時間、リトライ回数 |
| 「味見して調整」——上記のカードがあえて書かなかった一文 | 唯一の自由記述ステップ | トレース診断で特定された、制約のない計画フィールド |
| 料理人の判断 | あなたが指定しなかったすべてのこと | モデルの事前分布——本当のデフォルト |
| 1枚のレシピカードから生まれる2通りの料理 | 実行ごとの出力のばらつき | N回実行したときの再現率 |
| 仕様通りに完璧に仕上げた料理を、アレルギーのある人に出してしまう | 仕様はクリアしているが、本来の目的を果たしていない | アサーション(検証条件)がそもそも足りていなかった |
| パス — 皿を出す直前のチェック工程 | 出力のバリデーション | 利用前に検証されるJSONスキーマ |
[定義] このシーズンで今後よりどころにする2つの指標を、ここで一度だけ定義しておく:
- 再現率(Reproducibility Rate) — N回まったく同じ条件で実行したとき、出力がバイト単位で完全一致する割合。品質は一切問わない。ただ「同じことを2回やるか」だけを測る。
- 決定性指標(Determinism Index) — 同じ考え方を 軌跡 に適用したもの。つまり最終出力だけでなく、ツールの選択順・状態遷移・出力がすべて同じかを見る。
この2つの指標で1.000を取れても、システムは安定して間違い続けることができる。それはこの指標の仕様であり、欠陥ではない。「安定しているか」と「正しいか」を切り分けるためのもので、後者をデバッグするにはまず前者を固める必要がある。
予測ゲート
スクロールする前に、必ず自分の答えを書き出してほしい——この仕掛けの狙いは、記録しなかった予測は自分が当てたと錯覚するからである。
まず、構造化された出力を返すプロンプトを一つ用意する。その出力が満たすべき条件を二十個、アサーションとして書き出す——フィールドの有無、型の正しさ、列挙値の合法性、長さの上限など。これをtemperature 0で100回実行する。
Q1. そのうち、バイト単位で完全に同一の出力が返る割合はどれくらいか?
Q2. ここで一つだけ手を加える。モデルはまず、plan を固定スキーマで検証できる形で出力し、その後で初めてツールが呼ばれる。このときQ1の割合はどう変化し、レイテンシはどうなるか?
Q3. 以下の三つを「実行ごとのばらつきを減らす効果が大きい順」に並べてみてほしい:(a)temperatureを0に下げる、(b)プロンプト文に明示的なアサーションを20個追加する、(c)自由記述の1ステップをスキーマ検証する。
答えはFailure RoomとNotebookに書いてある。もしQ3を直感的な順序で並べたなら、そのノートブックに15分投じる価値は十分にある。
Failure Room
意図的に壊してみること。壊せない仕組みは、仕組みではなく単なる主張にすぎない。
Failure 1 — temperature 0は決定性ではない。 この段で最もよくある誤解だが、現実には成り立たない。temperature 0はsampling を貪欲化するだけで、システムを決定的にはしない。バッチ処理、GPUカーネルの非決定性、ツールの結果、タイムスタンプ、検索順序など、下層で変動する要素が多い。Dhageの4セルはすべて制御された設定下でも論文一本分のばらつきを示している。「temperatureをゼロにしたから大丈夫」という話は、そもそもスタート地点にすら立っていない。
Failure 2 — 書かなかったアサーション。 カードには3 g salt とだけ書いてある。料理人はきっちり3g使った——それでも料理は塩辛すぎた。なぜなら塩は指定したが、醤油(それ自体に塩分がある)には一言も触れなかったからだ。不完全な仕様は、最初の一皿が出るまで完全に見える。だからこそノートブックは「出力を見る前に」アサーションを書かせる。後から書いたアサーションは、単なる結果の説明にすぎない。before 出力を見る前に:後から書くアサーションは、得られたものの説明にしかならない。
Failure 3 — 過剰な仕様は、せっかくの能力を殺す。 今度は逆方向に振ると、鏡像の失敗が現れる。すべてのフィールドを制約し、逸脱を一切許さなければ、非常に高価なif ステートメント——ホッチキスのような想像力しか持たない料理人がカード通りに作るだけになる。料理人の判断力こそが雇った理由だ。エンジニアリングの問いは「どこまで制約できるか」ではなく、how much can I constrain ——ではなくどの一つの非制約ステップが、最も大きなバラツキの元凶になっているか——まさにこの問いに、arXiv:2608.26197 のトレースレベル診断は「勘」ではなく実測で答えを出している。
失敗4:1.000なのに無意味な指標 モデルに {} を毎回返させれば再現性は1.000になる。冗談ではない。ほとんどの報酬ハッキングはこの形だ。どんな決定性指標も、タスク成功率と並べて報告しなければ不正の温床になる。論文もノートブックも両方をきちんと報告している。
Q3の答え: (c)、次に(b)、最後に(a)——しかもその差は小さくない。自由記述ステップをスキーマ検証しただけで4セル中3つが1.000に到達した。プロンプトテキストにアサーションを追加しても、モデルが頑張るだけで何も検証可能にはならない。バラツキが測定された時点で温度0はすでに適用済みだった。
ノートブック
ラボ01:バラツキ、そしてそれを消す一手 
labs/01_prompt_as_specification.ipynb · Colab無料枠 · APIキー不要 · CPU約15秒 · 公開前に全セル実行済み。
全8セル。ワーカーはスタブで、意思決定は自由記述planフィールドから導かれる——この設計こそがラボの本質で、意思決定の上流に自由記述ステップがあると、見かけのバラツキではなく意思決定そのものが揺れる.
- ワーカーは、計画とは独立に4つのパッケージング失敗モードを意図的に保持しているので、診断で意思決定が揺れたのか、JSONが壊れていた.
- のかを切り分けられる。アサーションはスキーマとして出力を確認する前に。
- N=100での基準値:再現性0.280、決定性0.330、タスク成功率0.890.
- リトライ回数に上限を設ける ― どのフレームワークにも標準搭載されている一行の修正。これでタスク成功率は1.000まで上がり、決定性も0.440.
- トレースレベルの診断で、分散の要因を各フィールド単位で特定する。
planその下流にある意思決定フィールドが主な支配要因となり、ticket_idは変化しない。 - パラメータを一気に振るテスト、そして特に注目すべきセル。フリーテキスト部分の不安定さを変化させると、2つの介入策の効果がはっきり分かれる。
- 構造化プランニング ― 意思決定が参照する前にプランを制約する段階で ― さらにグラフ付き。
- ブリッジ:同じ測定コードをそのまま任意のOpenAI互換エンドポイントに向けて実行できる。
[EVIDENCE] このラボを作る決め手になった結果はセル6に現れたが、これは私が構想段階で予想していたものとは違った。リトライはどの設定でも決定性を下げることはない ― 私は下がると予想していたが、ノートブックの判定は実行時に計算されるため、私の予想を裏切ることができたし、実際にそうなった。実際に起きることは、より繊細で実用的だ:
| 上流の揺らぎ | 基準値 | リトライ | リトライによる上乗せ | プランゲート |
|---|---|---|---|---|
| 0.00 | 0.885 | 1.000 | +0.115 | 0.885 |
| 0.25 | 0.680 | 0.815 | +0.135 | 0.870 |
| 0.50 | 0.480 | 0.665 | +0.185 | 0.860 |
| 0.75 | 0.340 | 0.440 | +0.100 | 0.875 |
| 1.00 | 0.260 | 0.290 | +0.030 | 0.865 |
上流のステップがもともと安定していればリトライが圧倒的に効くが、問題が難しくなるとその効果は跡形もなく消える。一方でプランゲートは全域でフラットだ。なぜなら、これは症状を吸収するのではなく、原因そのものを取り除くからである。構造的な修正と応急処置の違いはここにあり、しかも多くの人が一つの設定でしか測らないため、この違いはほぼ見えなくなる。
[DESIGN] なぜスタブであってライブモデルではないのか。シーズン1のラボは徹底して「仕組み」優先であり、"do not pretend a four-action bandit is an LLM"(訳:「4アクションのバンディットをLLMだと思い込むな」)。シミュレータはどこでバラつきが入り、何がそれを消すのかを数秒で、無料・APIキー不要で再現できる。ただし、決して規模(値の大きさ)は再現しない。ノートブックが出す数値はDhageの「N=100で1.000」の証拠にはならない——それは実モデルで測定されたものであり、論文だけが根拠になる。セル8が正直な橋渡しで、環境変数を2つセットすれば同じ測定コードが実際のエンドポイントでも動く。測定方法は変わらず、変わるのはワーカーだけだ。
プロジェクト
2つのビルドをゼロから作った。フレームワークも標準ライブラリ以外の依存もなし。どちらも同じ発想を全く異なる現実にぶつけている——しかもこのセクションを書く前に実際に動かしているので、以下の数値はすべて予想ではなく実測値だ。
プロジェクト1 — 実生活編:the-grocery-slip
projects/01-real-grocery-slip/ · python3 measure.py 20
毎週のミールプランから買い物リストを自動生成するアプリ。これに仕様を書く人などいない——だからこそ最初の題材にふさわしい。失敗しても何も失わない場面で、自分のアサーションがいかに穴だらけかを思い知ることになる。
prompt version : slip-v4
conformance    : 0.700   (14/20 passed every assertion)
reproducibility: 0.450   (identical output share)
[EVIDENCE] 3つ壊れたポイントがあり、READMEには修正前の状態がすべて記録されている。
Run 1 — モデルのバグではなく自分のバグ。 適合率は0.000で返ってきた。すべての実行が失敗した。仕様には0 < qty <= 20が各単位ごとに必要と書いてあり、リストには500gのにんじん。制約が厳しすぎたのではなく、適用した単位が根本的に間違っていた。粒度——「1世帯1週間分」ならグラム換算で5000、束なら20。両方に同じ数値を当てはめるのは、制約の皮をかぶったカテゴリミスだ。修正後、適合率は0.700に上がった。測定して初めてわかったのは、仕様そのものが間違っていたという事実であり、これが普通である。何かを信用する前に20回は回してみるべき理由がここにある。
7回目——このプロジェクトが存在する理由となる穴。リストにはmilkとMilkが、別々の売り場に入っていたが、すべてのアサーションは通過した。各アイテムは個別には正しかったが、仕様は要素しか見ておらず、全体の集合をチェックしていなかった。分析単位を間違えて完全にしただけだった。私の買い物リストは、買い物以外のすべてのテストに合格した。
11回目——誘惑。モデルは仕様よりも明らかに良いリストを出してきて、その実行を通すためにアサーションを緩めたくなる誘惑に駆られた。仕様が間違っているなら、理由を記録して独立したコミットで意図的に修正せよ。たまたま気に入った出力に合わせて書き換えてはならない。
プロジェクト2——エンタープライズ:the-change-ticket
projects/01-enterprise-change-ticket/ · make compare · make gate
ITSMの変更申請ルーター。入力はフリーテキスト、出力は構造化されたルーティング決定(リスク階層・承認グループ・フリーズウィンドウフラグ)。ゴールデンチケット6件、各N=100。
[EVIDENCE] 変えたのは1つだけ:
                        WITHOUT plan gate      WITH plan gate
determinism                     0.510                 1.000
conformance                     1.000                 1.000
escalation_recall               1.000                 1.000
make gateでexit 0。make gate構造化プランニングを外すとexit 1。これは論文の見出しを別タスクで再現したものだ——注目すべきは、介入なしでも適合率はすでに1.000だった。個々の決定はすべて有効だったが、同じ決定が2回続けて出ることはなかった。これは、すべてのユニットテストを通過しても本質的に失敗しているパターンである。
30分で作る——契約
ルーターに必要なものを、エンジニアが尋ねる順にすべて用意する。入力:フリーテキスト。出力:1つのDecision。不変条件:プランがスキーマを通過するまで決定は下さない。停止条件:却下されたプランはエスカレーションされ、再試行はしない。
PLAN_SCHEMA = {                       # the "to taste" step, given a shape
  "strategy":   enum["standard","expedited","emergency","reject"],
  "risk_tier":  enum["low","medium","high"],
  "freeze_hit": bool,
  "confidence": number in [0, 1],
}
def route(ticket, prompt_version):
    plan = model.plan(ticket)               # free text → structured plan
    if not validates(plan, PLAN_SCHEMA):    # 1 check, before ANY tool runs
        return escalate(ticket, "plan_rejected", prompt_version)  # no retry
    if plan.confidence < 0.60:
        return escalate(ticket, "low_confidence", prompt_version) # refusal path
    return decide(plan, prompt_version)     # deterministic given the plan

# CI gate (make gate): N=100 per golden ticket
#   determinism       == 1.000   (Decision.key() excludes decided_at)
#   conformance       == 1.000
#   escalation_recall == 1.000   (under-specified tickets escalate in ALL 100)
# any line below threshold → exit 1 → the build failsこのブロックに意図的に含めていないもの:却下されたプランの再試行(決定を引き直す)、比較キーにタイムスタンプ(すべての実行が一意になる)、ライブモデル(model.plan 任意のエンドポイントに差し替え可能(測定コード自体は一切変わらない)。
[DESIGN] この4つの設計が、単なるデモではなく「エンタープライズ仕様」と呼ぶに値する理由である。それぞれに明確な役割がある:
- すべてのアクションより前に「構造化プランニング」を必須とする。 プランは、4つの承認済みルーティング戦略から選び、決定の前段階で検証する。後から検証しても、単にログが整うだけで意味がない。
- 却下されたプランは再試行しない。 再試行は新たなサンプリングであり、プランも決定も再度引き直される。却下は「もう一度」ではなく「エスカレーション」を意味する——ノートブックのスイープがその証拠であり、問題が難しくなるほど再試行の効果は+0.030まで縮む。
- 拒否経路を不変条件として厳格に守る。 2つのゴールデンチケットは意図的に仕様が不十分にしてある。信頼度が0.60未満なら、唯一許されるのは特定の人間へのエスカレーションであり、
escalation_recall1.000でゲートされる条件は、エスカレーションが100回すべてで全会一致でなければならず、「たいていそうなる」では足りない。 - すべての決定行にプロンプトのバージョンを明記する。 たとえば「#4471が3月にプラットフォームへルーティングされた理由」を問う監査人には、再現可能な説明が必要だ。そのためプロンプト自体が監査証跡の一部となり、バージョン管理されたアーティファクトとなる——このエピソードの主張が、コンプライアンスの観点からも必然的に導かれる。
[DESIGN] 議論の余地がある選択肢が一つある。Decision.key() ここでは意図的にdecided_atタイムスタンプを除外している。タイムスタンプは決定そのものではなく証跡情報であり、含めるとすべての実行が自動的に一意となり、決定性指標は永遠に1/Nになる。どの決定性指標にも、こうした比較キーの設計判断が必ず潜んでいる。自分の比較キーが何を除外し、なぜそうしたのか説明できなければ、測っているものを本当に理解しているとは言えない。
[OPEN] どちらのプロジェクトも「証明」していないことがある。両方のゴールデンセットは合成データであり、ワーカーもデフォルトではスタブだ。エンタープライズ構成の現状は「実行可能かつゲート済み」であり、本番導入・実測済み。これを「本物」にするには、実際のルーティング結果が付いた過去のチケットからゴールデンセットを作り、決定性の隣に合意率を並べて報告することが必要だ。合意なき決定性は、間違いを繰り返すだけのルーターにすぎない。
同じ物語、出口は五つ
一本の軸から、読者ごとに異なる扉が開く。決断を一つ、アクションを一つ選び、あとは置いていく。
| あなたがもし | このエピソードで変わる決断 | 今週ひとつだけやること |
|---|---|---|
| 高校生ビルダーなら | 「プロンプトエンジニアリング」とは、魔法の言葉探しではなく、検証可能なレシピカードを書くことだ。 | Colabラボを15秒だけ動かし、キッチンのはしごの話を友人一人に語ってみよう。 |
| AIエンジニアなら | 決定性は、レイヤーを積み重ねるのではなく、唯一残った自由記述ステップを型にすることで得られる。 | 上記の契約を自分のプロンプトで一つ実装し、N=20でゲートをかけてみよう。 |
| ファウンダーなら | 同じリクエストに二度違う答えを返すデモは製品ではない。その修正は安価で、しかも測定できる。 | 自分のチームに、コアプロンプトの再現率を尋ねてみよう。誰も答えられなければ、それ自体が発見だ。 |
| 経営層なら | 信頼性は監査の問いになる:どのプロンプトバージョンがこの決定を生み、それは再現できるのか? | 「全決定行にプロンプトバージョンを記録」を次回のアーキテクチャレビューに加えよう。 |
| 投資家なら | 「堀(Moat)」は、測定されゲートされた仕様の中にあり、チームが借りているモデルの中にはない。 | どんなエージェント系スタートアップにも「決定性」と「タスク成功率」を並べて尋ねよう。どちらか一方だけなら、それは単なる演出だ。 |
現実ミッション
今週すでに自分が使っているものを題材に、15分で実践する。
- 自分が本当に依存しているプロンプトを一つ選ぶ——実際に日常で使っているものだ。
- 出力を一切見る前に、その出力が満たすべき条件をすべて書き出す。フィールド、型、列挙値、長さの上限など。10個のアサーションを目安に挙げてみる。想像以上に難しいはずで、その難しさこそが発見である。
- 20回実行し、アサーション違反の回数を数えて記録する。
- パイプラインの中で、まだ自由記述のテキストを出している箇所——つまり「味はお好みで」に相当する部分——を一つ特定する。たいてい正確に一箇所あり、しかも意外な場所に潜んでいる。
- そのステップにスキーマを与える。再度20回実行し、結果を比較する。
もし4の手順で何も見つからなかった場合——つまりパイプラインが計画ステップなしの一発呼び出しだけなら——それ自体が重要な発見だ。あなたはまだこのラダーの段に到達していないので、次回があなたのための回になる。
リサーチチャレンジ
この課題をエージェントに渡し、実行前に自分の予測を事前登録する——予測していなかった結果は、後から必ず自分の中で正当化してしまうからだ。
arXiv:2608.26197 の実験構造を小規模で再現する。出力が検証可能なタスクを一つ選び、固定設定でN=100回のベースライン再現率と決定性指数を測定する。その後、介入を一度に一つだけ、ランダムな順序で適用する:(a)計画ステップのスキーマ検証、(b)ツール選択の強制、(c)リトライ回数の制限、(d)出力検証の追加。それぞれが決定性とタスク成功率、さらにトークンコストとレイテンシーに与える限界効果を報告する。
事前登録:どの介入が最も効果を持つか、またレイテンシーが2つのモデルで同じ方向に動くかどうか。
論文自身の答えは「構造化プランニングが効果を持ち、レイテンシーはモデルごとに分かれる——一方は速くなり、もう一方は顕著に遅くなる」。確認する前に自分の予測を書き留めておくこと。もしあなたのタスクで異なる順序が再現されたなら、それは3週間前の論文と公開で食い違ったということであり、あなたのセットアップのバグではない。
最新動向
この段階の現状。30の先駆的な情報源を対象に、毎週ライブでフィード同期して集計。research-anything (make watch-sync。技術的なシグナルのみで順位付けされ、決してオーディエンス規模では並ばない。
同期日時:2026年9月3日。
- arXiv:2608.26197(2026年8月25日)— 本稿の根拠となる実証研究。執筆時点で公開から3週間。
- arXiv:2608.21156v2(2026年8月26日改訂)— 五段階ラダーを定義したサーベイ。一般的な四ラベル解説が抜かしている「コンテキスト」段も明記されている。
- Simon Willison (2026-09-02) — Claudeの新しいsystem promptは本当に歌詞の再現を嫌がる:system promptは業界で最も読まれ、かつ最もバージョン管理されていないアーティファクトであり続けている。
- 古くても本質を支える:arXiv:2401.14423 Prompt Design and Engineering;arXiv:2503.02400 Promptware Engineering;Lilian Wengの Prompt Engineering(2023年3月15日)— 今もこの段の技法を最も明快に整理した単独サーベイ。
[OPEN] 動いていないこと :arXiv:2608.26197の追試はまだ誰も発表していない。著者一人・論文一本・二つの合成タスクが本稿の中核主張を支える全ての実証根拠であり、誰かが再現するまではその前提で読むべきだ。
セルフチェック
上まで戻らずに、自分の理解を確認せよ。
- 公表されている五つの段を順に挙げ、一般的な四ラベル解説が抜かしている段を答えよ。
- Reproducibility Rate(再現率)とDeterminism Index(決定性指標)の違いは何か、そしてなぜ両方で1.000を取ってもシステムが無意味になりうるのかを説明せよ。
- arXiv:2608.26197では、最初のハーネス導入で再現性が悪化(4セル中いくつで起き、どんな一手で解消されたか)
- なぜノートブックは実際のモデルではなくスタブを使うのか、そしてそのスタブでできないと断言できることは何か?
- 「temperatureを0にしたから決定的だ」と言われたとき、それが成り立たない理由を3つ挙げよ。
次回予告
完璧なレシピカードを書いたとしよう。
すべての分量に上限・下限があり、根拠も明記されている。「お好みで」はすべて数値化され、どの項目も検証可能だ。100回実行してReproducibility Rateは1.000。しばし「キッチンは制した」と思い込む。
だが、その同じカードを火曜の朝ではなく金曜の夜に、同じ料理人へ渡す。
出てくる料理が違う。
カードの内容は変わっていない。料理人も同じだ。変わったのは、調理台の上に何があったかだけ——昨夜の使いかけのソース、まだレールに挟まったままの別テーブルの伝票、塩の隣に誰かが開けっぱなしで置いた瓶。
レシピカードは、キッチンで唯一の要素ではなかった。
第2回:パントリーへ。——4ラベルのリストが抜かしている段であり、公刊されたラダーでは2番目。そして今まさにプロダクションのエージェントで最も高額な事故が起きている現場だ。
関連エピソード
第1話:インテリジェンス・エンジニアリング・アドベンチャーズ シーズン7——キッチンのはしご本シリーズの出典は、定義・導出・証拠・エンジニアリング上の選択・未解決の問いという分類で整理している。比喩は主張の導入には使うが、決して証拠にはしない。各エピソードには、APIキー不要・無料枠で動くColabノートブックと、完全自作の2つのアプリ(個人向けとエンタープライズ向け)が付属する。ラダーの比喩はFengら(arXiv:2608.21156)によるもので、私の発案ではない。「what moved」セクションは、技術的な信号を基準に30の先駆的な情報源を毎週ライブで同期し、その内容から自動生成している。読者数や人気順では並べていない。本記事には、雇用主やクライアント由来の素材は一切含まれていない。— Paul Jialiang Wu · futuremake.io
参考文献
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. (2026). Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2, revised 2026-08-26. — five-rung ladder(「The ladder is not mine」で逐語引用)
- Dhage, S. (2026). Harness Engineering for Predictable Agentic Systems: An Empirical Study of Deterministic Execution Constraints. arXiv:2608.26197, 2026-08-25. — 1-of-4 / 2-of-4の一次結果、トレースレベル診断、Structured Planningが3/4セルでN=100時に1.000到達
- Chen, B., Zhang, Z., Langrené, N. et al. (2023). Unleashing the potential of prompt engineering for large language models. arXiv:2310.14735。— 技法サーベイ
- Amatriain, X. (2024). Prompt Design and Engineering: Introduction and Advanced Methods. arXiv:2401.14423.
- Chen, Z., Wang, C. et al. (2025). Promptware Engineering: Software Engineering for Prompt-Enabled Systems. arXiv:2503.02400。— 「プロンプトはソフトウェアアーティファクトである」論の全容
- Weng, L. (2023). Prompt Engineering. lilianweng.github.io、2023-03-15。— 同著者によるHarness Engineering for Self-Improvement (2026-07-04)――一人の著者が三つの段階を七年かけて辿った記録。
- Willison, S.(2026-09-02)。Claude's new system prompt really doesn't want to reproduce song lyrics.(訳:Claudeの新しいシステムプロンプトは、どうしても歌詞を再現したくないようだ。) simonwillison.net.
- Brown, T. B., Mann, B. ほか(2020)。Language Models are Few-Shot Learners.(訳:言語モデルはFew-Shot学習者である。) arXiv:2005.14165――2020年、歴史を分けた論文。
- Reynolds, L., McDonell, K.(2021)。Prompt Programming for Large Language Models: Beyond the Few-Shot Paradigm.(訳:大規模言語モデルのためのプロンプトプログラミング――Few-Shotパラダイムのその先へ。) arXiv:2102.07350.
- Liu, P., Yuan, W. ほか(2021)。Pre-train, Prompt, and Predict: A Systematic Survey of Prompting Methods in Natural Language Processing.(訳:事前学習・プロンプト・予測――自然言語処理におけるプロンプト手法の体系的サーベイ。) arXiv:2107.13586.
- Wei, J., Wang, X. ほか(2022)。Chain-of-Thought Prompting Elicits Reasoning in Large Language Models.(訳:Chain-of-Thoughtプロンプトが大規模言語モデルの推論を引き出す。) arXiv:2201.11903.
- Wang, X., Wei, J. ほか(2022)。Self-Consistency Improves Chain of Thought Reasoning in Language Models.(訳:自己整合性が言語モデルのChain-of-Thought推論を向上させる。) arXiv:2203.11171.
- Kojima, T., Gu, S. S. ほか(2022)。Large Language Models are Zero-Shot Reasoners.(訳:大規模言語モデルはゼロショット推論者である。) arXiv:2205.11916.
- Willison, S. (2022-09-12). Prompt injection attacks against GPT-3. simonwillison.net.
- Khattab, O., Singhvi, A. et al. (2023). DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines. arXiv:2310.03714.
- Shinn, N., Cassano, F. et al. (2023). Reflexion: Language Agents with Verbal Reinforcement Learning. arXiv:2303.11366——シリーズ表でループエンジニアリングの基準点とされる論文。
- Wu, Q., Bansal, G. et al. (2023). AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation. arXiv:2308.08155——シリーズ表でグラフエンジニアリングの基準点となる論文。LangGraph: github.com/langchain-ai/langgraph.
- Anthropic (2024-12-19). Building Effective AI Agents. anthropic.com/engineering——シリーズ表でハーネスエンジニアリングの基準点となる記事。
- Anthropic (2025-09-29). Effective context engineering for AI agents. anthropic.com/engineering——シリーズ表でコンテキストエンジニアリングの基準点となる記事。
- プロンプトエンジニアリングのガイド(歴史表では記述のみ、引用はなし):Anthropic · OpenAI.
- Liang, P., Bommasani, R. ほか (2022). Holistic Evaluation of Language Models. arXiv:2211.09110 — 本シリーズの評価エンジニアリング分野の基準文献。
- Zheng, L., Chiang, W.-L. ほか (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. arXiv:2306.05685 — 本シリーズの評価エンジニアリング分野の基準文献。
- Kapoor, S., Stroebl, B. ほか (2024). AI Agents That Matter. arXiv:2407.01502 — 本シリーズの評価エンジニアリング分野の基準文献。
- Intelligence Engineering Adventures シーズン6 — The Governor Engine(エピソード1・3:入れ子構造図は現場で破綻すること、そしてここで使われるどのラベルも安定性を表現できないことを論じる回)。