AI-NATIVE 시리즈 · 에이전트형 AI 피칭하기, 3부작 중 2부
이번 시즌 에이전트 팔기: 경계를 긋고, 책임을 지우고, 증거로 이끌기
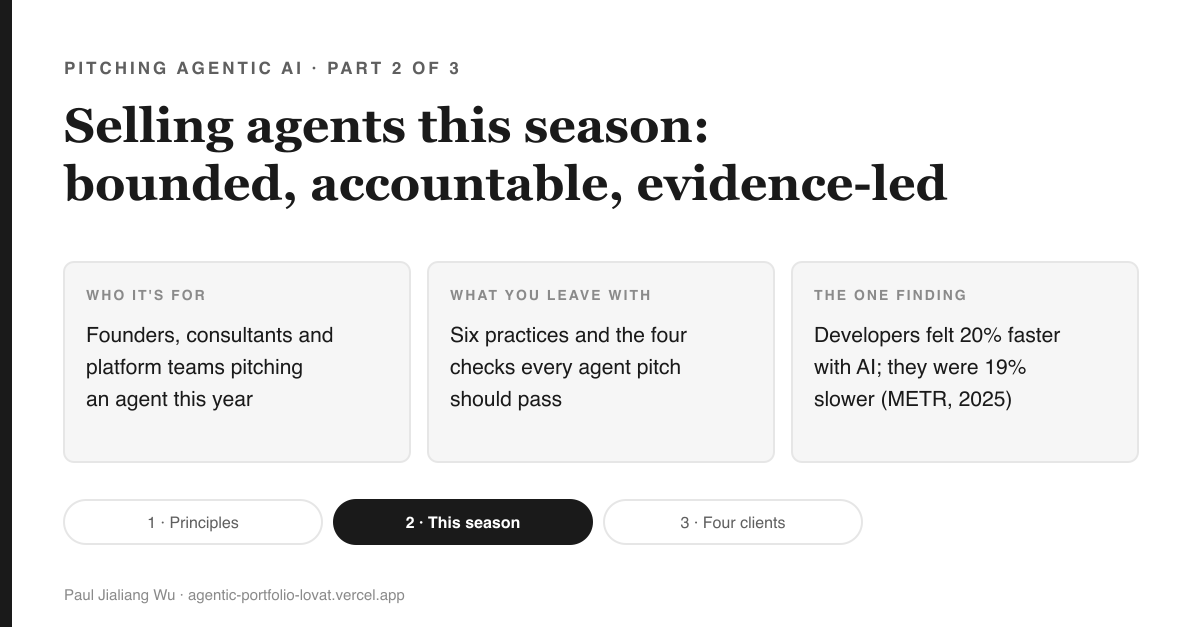
1분 요약
이 글은 무엇인가. 시리즈 2부. 이번 시즌 AI 에이전트를 피칭하는 실천법과, 모든 피칭이 통과해야 할 네 가지 점검: 구체적인가, 정직하게 규모를 잡았는가, 책임질 사람이 있는가, 사전에 측정 기준을 정했는가.
왜 중요한가. 2025년의 한 무작위 실험에서, 숙련된 개발자들은 AI 도구를 쓸 때 19% 더 느렸지만 그러면서도 자신이 20% 더 빨라졌다고 믿었다(METR). 뭉뚱그린 생산성 약속이야말로 증거가 가장 뒷받침하지 못하는 주장이다.
읽고 나서 할 수 있는 일. 네 줄을 네 가지 점검에 통과시켜 본 다음, 거부권을 쥔 사람에게 전할 한 문장을 써보라: 에이전트가 무엇을 건드릴 수 있고 누가 승인하는지.
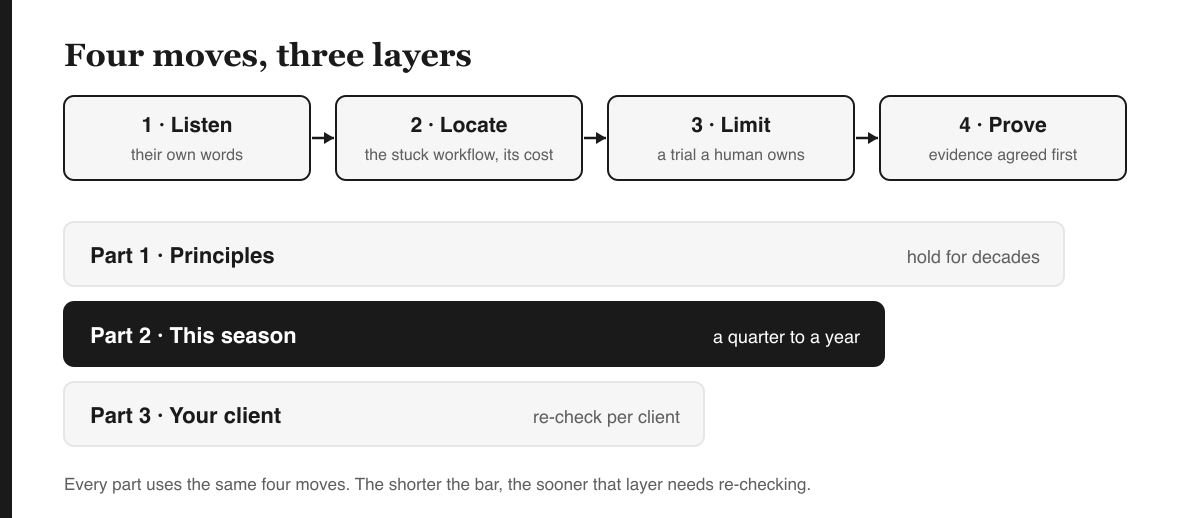
Pitching Agentic AI — 시리즈 줄기
- 모든 피칭보다 오래가는 원칙들 1화
- 이번 시즌, 에이전트 팔기 이번 화
- 네 고객, 네 가지 첫 워크플로우 3화
라벨 읽는 법: EVIDENCE는 출처가 있다는 뜻이고, DESIGN은 권장 실천, OPEN은 아직 검증되지 않음, LENS는 내 개인적 견해다.
기업의 AI 파일럿은 자주 멈춰 선다. 그 이유의 상당 부분은 범위를 어떻게 설정했는가에 있다. 2025~26년을 위한 여섯 가지 실천, 그 중심에는 하나의 아이디어가 있다: 막혀 있는 워크플로 하나를 고르고, 사전에 합의한 짝지어진 측정값이 판매를 대신하게 하라. 놀라운 점은, AI 코딩 도구를 다룬 최고의 실험들조차 서로 엇갈린다는 것이다.
이번 화에서 다루는 것: 지금 당장 AI 에이전트를 어떻게 피칭할 것인가
1부의 원칙들은 거의 변하지 않는다. 반면 이 층위는 한 해 걸러 한 번꼴로 바뀐다. 구매자들이 어떻게 구매하는지, 현재 증거가 무엇을 말하는지, 그리고 거버넌스에 대해 무엇을 묻는지가 그렇다. 이 글은 올해 기업에 에이전트를 피칭하려는 모든 사람을 위한 것이다. 스타트업 창업자든, 컨설턴트든, 사내 플랫폼 팀이든 상관없다. 나는 Accenture에서 일하고 있고, 아래 연구 중 하나에 Accenture가 등장한다. 그 대목에서는 그렇다고 밝혀두겠다. 여기 담긴 모든 내용은 공개된 자료들을 내가 직접 종합한 것이다.
먼저 내기를 걸어보라
2025년의 한 무작위 실험에서, 경험 많은 오픈소스 개발자들이 자신의 저장소에서 실제 작업을 AI 도구를 쓰기도 하고 쓰지 않기도 하면서 수행했다. 시작 전 그들은 AI가 자신을 약 24% 더 빠르게 만들어줄 것이라 예측했다. 실제로 AI를 사용했을 때, 작업에 걸린 시간은:
- A. 약 20% 더 짧았다.
- B. 비슷한 시간이 걸렸다.
- C. 약 19% 더 걸렸다.
실천 1: 피칭 전에 준비도부터 확인한다
EVIDENCE 기업 영업은 이를 이미 오래전에 공식화했다. 실무자들이 1990년대 PTC로 거슬러 올라간다고 말하는 체크리스트인 MEDDIC은 지표, 경제적 구매 결정권자, 의사결정 기준, 의사결정 프로세스, 통증 지점, 그리고 챔피언을 요구한다. 그 기원에 관한 이야기는 실무자들 사이의 구전일 뿐 세부적으로는 검증되지 않았지만, 살아남은 이유는 단순하다. 소유자도 없고 합의된 측정 기준도 없는 거래는 데모가 아무리 훌륭해도 좀처럼 성사되지 않는다.
DESIGN 에이전트 트라이얼을 위해 나는 나만의 질문 네 가지를 더한다. 결과에 대한 지정된 소유자가 있는가? 팀이 접근 권한과 맥락을 제공할 수 있는가? 산출물을 판단할 시간이 있는 검토자가 있는가? 작업이 범위를 정하고 확인할 방법이 있을 만큼 반복 가능한가? 하나라도 빠졌다면, 밀어붙일 게 아니라 멈춰서 그걸 채울 이유다.
실천 2: 압박 속에서 워크플로 하나를 고른다
DESIGN 막힌 엔지니어링 작업은 대체로 네 가지 모습 중 하나를 띤다. 나는 이를 '4R'이라 부른다:
| 막힌 작업의 양상 | 전형적 증상 | 경계가 분명한 첫 과제 | |---|---|---| | 대기 | 리뷰와 승인이 쌓인다 | 팀 자체 체크리스트에 따른 1차 리뷰 | | 재작업 | 재작업, 불안정한 테스트, 파이프라인 재실행 | 한 서비스의 실패한 CI 실행 추적 | | 재학습 | 사람과 사람 사이에서 맥락이 끊김, 아무도 모르는 오래된 코드 | 레거시 모듈 하나를 읽기 전용으로 설명·문서화 | | 재설명(Re-explaining) | 인수인계, 오래된 문서, 반복되는 질문 | 한 사건의 이력을 바탕으로 런북 초안 작성 |
표에서 한 항목, 팀 하나를 고른다. 자동완성만큼 좁아서도 안 되고, 회사 전체 자동화처럼 넓어서도 안 된다. 그렇게 넓히면 그저 예산이 붙은 7번 슬라이드가 될 뿐이다.
실천 3: '예'와 '아니오'를 말할 수 있는 모든 사람에게 말 걸기
DESIGN 똑같이 막힌 워크플로우라도 다음 네 사람에게는 저마다 다른 의미로 다가온다:
- 예산 책임자 (CTO, 엔지니어링 담당 부사장): 역량, 품질, 출시 신뢰도가 걸려 있다.
- 플랫폼 책임자: 일관성, 개발자 경험, 줄어드는 반복 조사가 걸려 있다.
- 일정 책임자 (제품 부서): 약속 지연 감소, 더 예측 가능한 출시가 걸려 있다.
- '아니오'라고 말할 수 있는 사람 (보안, 리스크, 품질): 에이전트가 무엇을 건드릴 수 있는지, 누가 승인하는지, 무엇이 기록되는지가 걸려 있다.
대부분의 피칭은 앞의 세 사람을 다룬다. 내가 지켜본 바로는, 거래가 멈춰 서는 곳은 대개 네 번째 사람이었는데, 그 사람에게는 끝내 한 문장도 전달되지 않았다.
실천 4: 증거가 뒷받침하는 것만 주장하라
EVIDENCE 다시 그 내기 이야기로 돌아가 보자. 정답은 C다. METR의 2025년 무작위 대조 시험(경험 많은 개발자 16명, 자신의 저장소에서 수행한 작업 246건)에서, AI 도구 사용을 허용하자 작업 시간이 19% 더 걸렸는데도 개발자들은 끝난 뒤에도 AI 덕분에 약 20% 더 빨라졌다고 믿었다 (Becker et al., METR, 2025). METR는 이후 재시행에서는 약한 신호밖에 얻지 못했다고 밝혔다. 많은 개발자가 더는 AI 없이 작업하려 하지 않았기 때문인데, 그래서 지금 METR는 개발자들이 예전보다 더 속도가 붙었을 가능성이 크다고 본다 (METR, Uplift update, 2026년 2월).
EVIDENCE 반대편 증거도 있다. Accenture(내가 몸담고 있는 회사)를 포함한 세 회사에서 개발자 4,867명을 대상으로 진행한 현장 실험에서는, AI 코드 자동완성 도구를 사용했을 때 완료된 작업("생산성"이 아니라 pull request 기준)이 약 26% 늘었고, 경험이 적은 개발자일수록 더 큰 이득을 봤다(Cui et al., The Effects of Generative AI on High-Skilled Work, 2024–25). Google의 DORA 2025 설문조사는 약 5,000명의 전문가를 대상으로 했는데, AI 사용이 처리량 증가와 연결되면서도 오히려 배포 안정성은 낮추는 경향과 맞물려 있다는 결과를 내놓았다: AI는 이미 있는 것을 증폭시킬 뿐이다(DORA 2025 announcement).
DESIGN 이 결과들은 서로 모순되지 않는다. 다만 상황과 시기를 구분해서 읽어야 할 뿐이다. 2022~23년의 광범위한 대상을 위한 코드 자동완성, 2025년 초 도구를 사용한 성숙한 코드베이스의 숙련 개발자, 그리고 전체 전달 시스템까지, 각기 다른 층위의 이야기다. 그래서 "개발자 생산성"은 잘못된 약속이고, 합의된 측정치를 동반한 워크플로 특정적 주장이야말로 정직한 주장이다.
실천 5: 속도 신호와 품질 신호를 짝지어라
EVIDENCE 파일럿이 실제 운영까지 이어지는지는 그것이 어떻게 구축되었는가에 크게 좌우된다. 인터뷰, 설문, 공개된 구현 사례를 바탕으로 한 MIT NANDA의 2025년 연구는 "학습 가능하고 맞춤화된 도구를 갖춘 외부 파트너십은 약 67%의 비율로 배포에 이르렀고, 내부 구축 도구는 약 33%에 그쳤다"(번역: "external partnerships with learning-capable, customized tools reached deployment ~67% of the time, compared to ~33% for internally built tools")고 보고했으며, 이 수치가 자가 보고된 것이라는 점도 스스로 밝히고 있다(MIT NANDA, The GenAI Divide, 2025; 널리 퍼진 보고서 사본). 자주 인용되는 "95%"라는 수치는 실패한 파일럿이 아니라 투자 수익이 전무한 조직의 비율을 가리킨다.
EVIDENCE 벤더들은 가격 책정을 관찰 가능한 결과 기반으로 옮겨가고 있다: Intercom은 자사의 Fin 에이전트에 대해 해결 건당 0.99달러를 청구하고(Intercom pricing), Salesforce는 Agentforce 가격을 대화 또는 액션 단위로 매긴다(Agentforce pricing). 이 "결과"가 무엇인지는 각 벤더가 스스로 정의한다.
DESIGN 이 관행은 '증명하라'는 원칙을 실전에서 작동하게 만드는 장치다. 속도 신호와 품질 신호를 함께 합의하되, 기준선과 누가 그것을 읽을지도 정한다: 리뷰 처리 시간은 누락된 결함 수와 함께, 문서화 시간은 수정 없이 통과된 테스트 수와 함께 본다. 속도만으로는 조작당하기 쉽다. 리뷰는 얕아질수록 빨라지는 법이라, 사고가 터져 그 리뷰가 열리기 전까지는 다들 축하하기 바쁘다.
실천 6: 트라이얼의 설계가 거버넌스에 답하게 하라
EVIDENCE 이제 구매자들은 거버넌스 체크리스트를 들고 온다. EU AI 법(EU AI Act)은 2025년 8월부터 범용 AI 모델에 대한 의무를 적용하고 있고 (EU AI Act implementation timeline), NIST의 AI 위험 관리 프레임워크는 미국에서 통용되는 기준이다 (NIST AI RMF).
DESIGN 범위가 제한된 트라이얼은 그 설계만으로 거버넌스 질문 대부분에 답한다. 에이전트가 무엇을 건드릴 수 있는지, 각 산출물을 누가 승인하는지, 무엇이 기록되는지, 전문가가 언제 설정과 통제를 점검할지를 명시하라. "무엇을 건드릴 수 있는가?"라는 질문에 대한 답이 한 문단을 넘어간다면, 그 트라이얼은 너무 크다.
피칭 전 거쳐야 할 네 가지 점검
- 구체적인가: 하나의 워크플로, 하나의 팀.
- 정직하게 규모를 잡았는가: "평가해 볼 가치가 있을지도 모른다" 정도이지, 약속된 혁신이 아니다.
- 책임질 사람이 있는가: 품질과 승인에 대한 책임은 엔지니어가 계속 진다.
- 사전에 측정 기준을 정했는가: 속도 신호와 품질 신호를, 기준선과 함께, 시작 전에 합의한다.
실패할 수 있는 지점들
- 증거는 계속 움직이고 있다. METR는 몇 달 만에 자신의 결론을 수정했다. 여기 나온 수치는 당신이 읽는 시점에는 이미 낡은 것일 수 있으니, 인용하기 전에 날짜를 확인하라.
- 준비도 확인이 핑계로 전락할 수 있다. "아직 준비가 안 됐다"는 말은 때로는 사실이고 때로는 어려운 고객을 피하려는 영업자의 변명이다. 어떤 질문에서 막혔는지, 언제 다시 물어볼지를 기록해 두라.
- 네 번째 사람은 여전히 거부할 수 있다. 기업들이 AI 정책을 얼마나 빨리 정리할지는 아직 열린 질문이다. 제한된 트라이얼이 도움이 되긴 하지만, 그렇다고 기다릴 필요가 없어지는 것은 아니다.
- 네 가지 R은 나만의 관점일 뿐, 법칙이 아니다. 내가 본 막힌 작업을 분류한 것일 뿐이니, 클라이언트의 상황은 맞지 않을 수도 있다. 이 점은 일찍 알아두는 게 좋다.
이번 주에 할 일
1부에서 적어둔 네 줄을 꺼내서 네 가지 체크를 통과하는지 확인해보라. 그런 다음, 거부권을 가진 사람을 위해 한 문장을 써보라: 에이전트가 무엇을 건드릴 수 있고 누가 승인하는가. 이 문장을 쓸 수 없다면, 아직 트라이얼을 제안할 준비가 안 된 것이다.
다음 편
3부에서는 이 모든 내용을 실수의 대가가 가장 큰 네 산업—금융 서비스, 생명과학, 산업 제조, 기술·통신—에 맞게 조정한다. 각 산업마다 고충, 담당자, 규칙, 그리고 꼭 맞는 첫 워크플로를 다룬다.
출처
- Becker, J., et al. "Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity." METR, arXiv:2507.09089, July 2025. (번역: 「초기 2025년 AI가 숙련된 오픈소스 개발자 생산성에 미친 영향 측정」, METR, arXiv:2507.09089, 2025년 7월)
- METR. "Uplift update." 24 February 2026. (번역: 「향상치 업데이트」, 2026년 2월 24일)
- Cui, Z., Demirer, M., Jaffe, S., Musolff, L., Peng, S., Salz, T. "The Effects of Generative AI on High Skilled Work: Evidence from Three Field Experiments with Software Developers." SSRN 4945566 (2024; revised 2025). (번역: 「생성형 AI가 고숙련 노동에 미치는 영향: 소프트웨어 개발자 대상 세 건의 현장 실험 증거」, SSRN 4945566, 2024년; 2025년 개정)
- Google Cloud. "Announcing the 2025 DORA report." 23 September 2025. (번역: 「2025년 DORA 보고서 발표」, 2025년 9월 23일)
- MIT NANDA. "The GenAI Divide: State of AI in Business 2025." July 2025. (번역: 「생성형 AI 격차: 2025년 기업 AI 현황」, 2025년 7월)
- Intercom, 가격 페이지; Salesforce, Agentforce 가격 페이지. 둘 다 2026년 10월 기준으로 확인함; 가격은 자주 바뀐다.
- EU AI Act 이행 일정 (artificialintelligenceact.eu); NIST AI 위험관리 프레임워크 1.0, 2023년 1월.
- 출처: 저자가 2026년에 참석한 코딩 에이전트 활용 교육 세션에서 착안함; 실천 방법, 표, 체크리스트는 위에 언급한 공개 자료들을 바탕으로 저자가 직접 종합한 것이다.