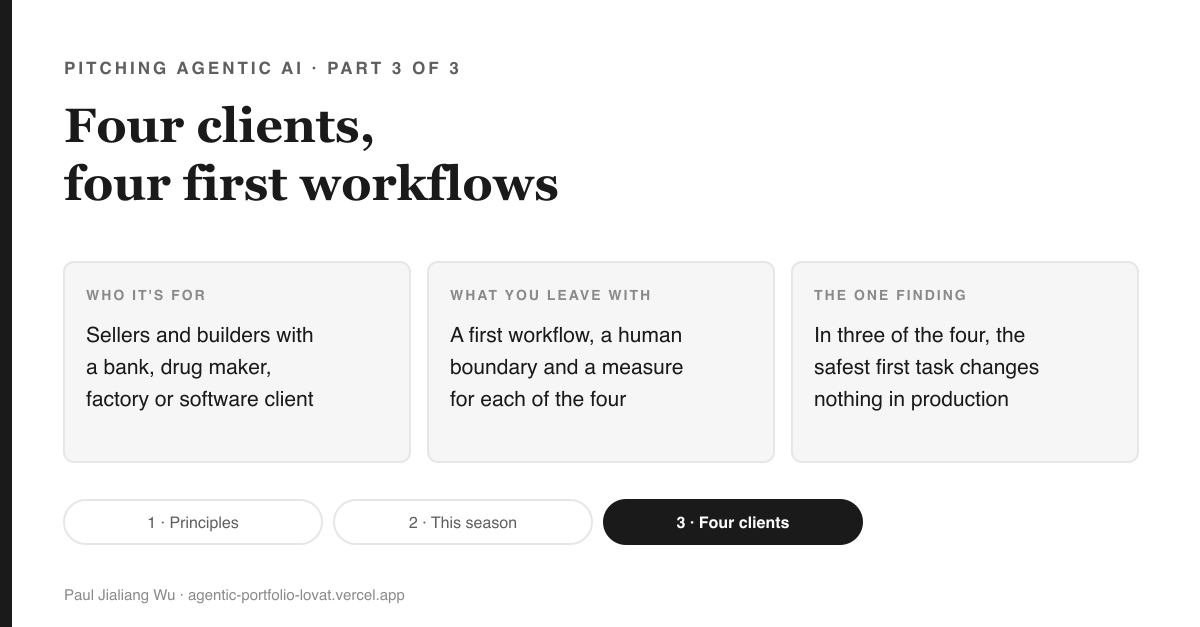
AI-네이티브 시리즈 · 에이전트형 AI 영업하기, 3부작 중 3부
네 고객, 네 가지 첫 워크플로우
1분 요약
이 글은 무엇인가. 시리즈의 3부: 네 고객 범주를 위한 제한된 첫 워크플로우와 각각을 구속하는 규칙을 다룬다. 2026년 4월 미국 은행 모델 리스크 관리에서 SR 11-7을 대체한 SR 26-2도 포함된다.
왜 중요한가. 고객들은 "틀려서는 안 되는 것"이 무엇인지에서 가장 크게 갈린다. 게이트키퍼가 빠르게 승인할 수 있는 시범 과제는, 승인받지 못할 더 나은 과제보다 낫다.
읽고 나서 할 수 있는 일. 다음 고객을 위해 이 글의 표에서 한 행을 채워 넣은 뒤, 게이트키퍼에게 보여주고 무엇이 있으면 승인하지 않을지 묻는다.
Pitching Agentic AI — 시리즈 줄기
- 모든 피칭보다 오래가는 원칙들 1화
- 이번 시즌, 에이전트 팔기 2화
- 네 고객, 네 가지 첫 워크플로우 이번 화
라벨 읽는 법: EVIDENCE는 출처가 있다는 뜻이고, DESIGN은 권장 관행이라는 뜻이며, OPEN은 아직 검증되지 않았다는 뜻, 그리고 LENS는 내 개인적 소신이라는 뜻이다.
똑같은 네 가지 동작도 은행, 제약회사, 공장, 소프트웨어 회사에서는 다르게 먹힌다. 각각에 대해 고충, 그 고충의 담당자, 규칙, 그리고 휴먼 바운더리와 짝을 이루는 측정지표를 갖춘 6주짜리 첫 워크플로우를 하나씩 제시한다. 놀라운 점 하나: 넷 중 셋은 첫 번째 과업을 아예 프로덕션 밖에 두려 한다.
이번 화에서 다루는 것: 네 산업을 위한 첫 워크플로우
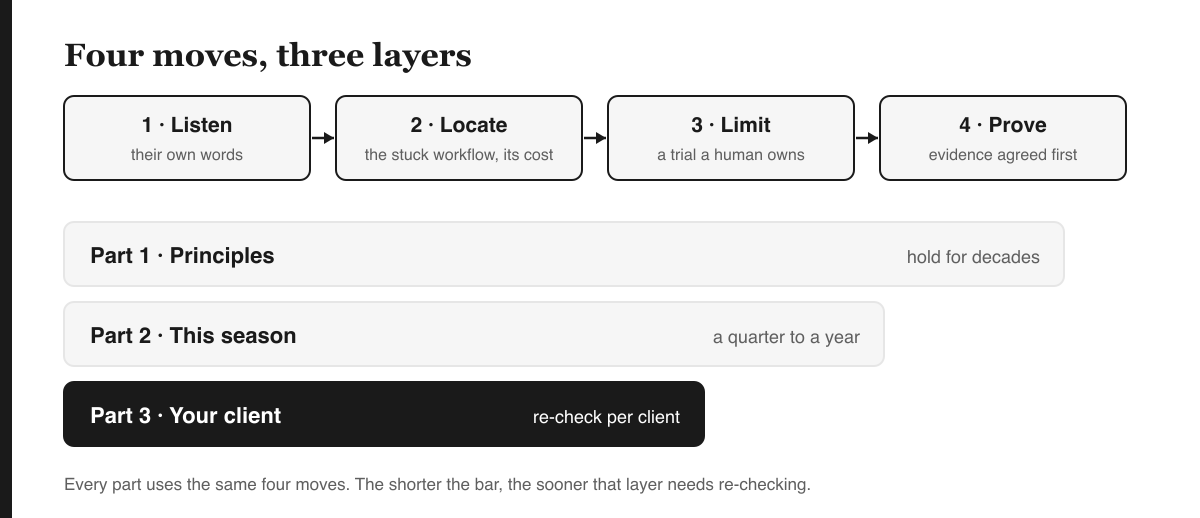
1화와 2화에서는 네 가지 동작(듣기, 짚기, 한정하기, 증명하기)과 네 가지 점검 기준(구체적인가, 정직하게 규모가 산정됐는가, 특정인이 책임지는가, 미리 측정 방법이 정해졌는가)을 다뤘다. 그래도 결국 실제 고객을 만나야 하고, 고객들은 무엇보다 해서는 안 되는 실수가 무엇이냐에서 가장 크게 갈린다. 이번 화에서는 실수의 대가가 가장 큰 네 산업을 고른다. 각 산업에 대해 첫 워크플로우를 제안하는데, 6주 안에 시도할 만큼 작고, 판단할 만큼 눈에 보이며, 규칙 안에 머무는 것이어야 한다.
이것들은 특정 기업을 위한 조언이 아니라 출발점이 되는 가설일 뿐이다. 규제는 관할권마다 다르고 자주 바뀌므로, 아래의 모든 규칙은 신뢰하기 전에 반드시 고객사 자체의 리스크·품질·법무 팀과 함께 확인한다.
먼저 내기를 걸어보자
이 네 종류의 클라이언트(은행, 생명과학 기업, 산업 제조사, 소프트웨어 기업) 중에서, AI 에이전트의 첫 과제를 프로덕션 밖에 완전히 묶어둘 곳은 몇 곳일까?
- A. 한 곳.
- B. 두 곳.
- C. 세 곳.
파트 1, 2와 달리 이번 내기에는 뒷받침하는 연구가 없다. 이건 판단의 문제이며, 내 판단을 그대로 보여주겠다.
1. 금융 서비스 및 보험
고충. EVIDENCE 의사결정에 영향을 미치는 모든 모델은 모델 리스크 팀을 위한 근거를 필요로 하는데, 그 지침이 방금 바뀌었다. 2026년 4월 연방준비제도는 OCC, FDIC와 공동으로 기관 간 지침인 SR 26-2를 발표했다. "supersedes and replaces" SR 11-7, and is "expected to be most relevant to banking organizations with over $30 billion in total assets" (번역: 이는 SR 11-7을 "대체하고 교체"하며, "총자산 300억 달러 이상 은행 조직에 가장 큰 관련성이 있을 것으로 예상"된다) (Federal Reserve, SR 26-2, 2026). EU에서는 디지털 운영 복원력법(EU DORA, 구글의 4절 DORA 지표와 혼동하지 말 것)이 2025년 1월부터 적용되어 ICT 리스크, 제3자 리스크, 복원력 테스트를 다루고 있다(EIOPA, DORA).
담당자. CIO나 엔지니어링 총괄이 구매를 결정한다. 실행 여부는 모델 리스크 책임자, CISO, 벤더 리스크 팀이 결정한다.
첫 워크플로우. DESIGN 프로덕션에 올라가지 않은 레거시 배치 모듈 하나를 문서화하고 테스트를 생성한다. 모든 변경 사항은 엔지니어가 검토하고, 시범 운영 중에는 어떤 것도 프로덕션에 반영하지 않는다. (모델 리스크 팀은 이미 슬라이드 7을 본 적이 있다. 그들은 그에 관한 정책까지 써놓았다.)
측정. 첫 주에는 오늘날 모듈 하나를 문서화하는 데 걸리는 시간을 기록한다. 6주에 걸쳐 이를 비교하고, 엔지니어가 수정 없이 그대로 수락한 생성 테스트의 비율과 짝지어 본다.
제안. 당신은 현대화 작업이 오래된 코드에 갇힌 지식 때문에 막혀 있다고 말했다(경청). 반복적으로 드는 비용은 시니어 엔지니어가 그 코드를 읽는 데만 쏟는 몇 주라는 시간이다(위치 파악). 모듈 하나, 읽기 전용, 엔지니어가 모든 테스트를 승인하는 방식이다(제한). 문서화 시간이 첫 주 대비 절반으로 줄고 대부분의 테스트가 수락된다면, 두 번째 모듈을 시도해볼 가치가 있을 것이다(증명).
OPEN SR 26-2의 부속 지침이 코딩 에이전트를 의사결정 모델과 다르게 취급하는지는 내가 아직 풀지 못한 열린 질문이다. 모델 리스크 팀에는 마지막 회의가 아니라 첫 회의에서 물어봐야 한다.
2. 생명과학 및 헬스케어
고충. EVIDENCE 규제 대상 기록에 손대는 소프트웨어는 검증을 받아야 하며, 전자 기록과 전자 서명은 21 CFR Part 11의 적용을 받는다 (eCFR, 21 CFR Part 11). FDA의 최종 Computer Software Assurance 지침(2026년 2월)은 의료기기 제조사의 생산 및 품질시스템 소프트웨어를 대상으로 작성되었지만, 생명과학 업계 전반에서는 이를 철저한 스크립트 테스트 대신 리스크 기반 보증으로 향하는 신호로 널리 읽고 있다 (FDA, Computer Software Assurance).
담당자. R&D IT 책임자나 품질 IT 책임자가 구매를 주도한다. 품질보증(QA)과 밸리데이션 팀이 게이트키퍼다.
첫 워크플로우. DESIGN 리스크가 낮고 GxP에 인접한 사내 도구 하나를 대상으로 밸리데이션 테스트 스크립트와 추적성 매트릭스 초안을 작성한다. QA가 모든 산출물을 검토하고 서명하고, 어떤 프롬프트에도 환자 데이터는 들어가지 않으며, 트라이얼에서 나온 어떤 것도 프로덕션에 쓰이지 않는다. 승인된 스크립트는 다음 도구를 위한 증거로 보관한다.
측정. 요구사항에서 승인된 테스트 스크립트까지 걸리는 일수를 첫 주 기준선과 비교하고, 여기에 QA의 1차 검토 반려율을 짝지어 본다.
피치. 당신은 모든 도구 출시마다 밸리데이션이 병목이라고 말했다(경청). 반복되는 비용은 매번 스크립트를 처음부터 작성하는 일이다(파악하기). 리스크 낮은 도구 하나, 초안만 작성, QA가 전부 서명(한정하기). 승인 시간이 줄고 1차 반려율이 오르지 않는다면, 두 번째 도구를 시도해볼 가치가 있을 수 있다(증명하기).
LENS 여기서는 기록과 서명에 대한 책임이 호의가 아니라 법적 요구사항이다. 이를 먼저 밝히는 것이 어떤 벤치마크보다 더 많은 신뢰를 얻는다.
3. 산업 및 제조
고충. EVIDENCE 설치된 기반 규모는 크다. 국제로봇연맹(International Federation of Robotics)의 집계에 따르면, 중국의 산업용 로봇 가동 대수만 해도 2024년에 200만 대를 넘어섰으며 (IFR, World Robotics 2025), 그리고 내 경험상 이런 장비를 둘러싼 제어 소프트웨어는 이를 작성한 사람보다 더 오래 살아남는 경우가 많다. OT 보안에는 IEC 62443이라는 표준군이 따로 있다 (ISA, IEC 62443).
담당자. 엔지니어링 담당 부사장 또는 디지털 제조 담당자가 구매를 결정한다. OT 보안 책임자가 무엇이 무엇에 연결될 수 있는지를 결정한다.
첫 워크플로우. DESIGN 레거시 제어 또는 SCADA 코드를 읽기 전용으로 설명하고 문서화하며, 시뮬레이터나 디지털 트윈에서만 실행되는 테스트를 생성한다. 경계는 절대적이어서, AI가 작성한 코드는 어떤 것도 안전 등급 로직(IEC 61508 같은 기능안전 표준의 영역)에는 들어가지 않는다.
측정. 해당 라인에 새로 투입된 엔지니어가 제어 루틴을 이해하는 데 걸리는 시간을, 직전 신입 엔지니어가 걸린 시간(첫 주에 기록)과 비교하고, 이를 변경 사항이 라인에 반영되기 전 시뮬레이션에서 발견된 결함 수와 짝짓는다.
피치. 그 라인의 컨트롤러 코드를 아직 이해하는 사람이 단 두 명뿐이라고 당신은 말했다(경청). 모든 변경이 그 두 사람을 기다린다(파악). 읽기 전용 설명과 시뮬레이터 전용 테스트, 안전 로직 근처에는 손대지 않는다(제한; 어떤 공장장도 인터록 주변에서 더 느슨한 주의를 요구한 적은 없다). 새 엔지니어가 놓친 결함 없이 두 배 빠르게 숙달된다면, 두 번째 라인에 적용해볼 가치가 있을 것이다(증명).
4. 기술, 소프트웨어, 통신
고충. EVIDENCE Google의 DORA 2025 보고서가 밝혔듯 AI는 처리량을 높이지만 전달 안정성을 떨어뜨릴 수 있고, 그 결과 리뷰가 병목이 된다 (DORA 2025 announcement).
담당자. CTO와 플랫폼 엔지니어링 리드다. 밀리는 로드맵 일정은 제품 조직 몫이다.
첫 워크플로우. DESIGN 한 서비스에 대한 테스트 백필, 또는 팀 자체 체크리스트에 맞춘 1차 풀 리퀘스트 리뷰를 엔지니어가 모든 머지를 승인하는 방식으로 진행한다. 첫 과제가 실제로 배포되는 코드를 작성하도록 허용할 만한 유일한 산업이 바로 여기인데, 팀이 이미 실수를 걸러내는 파이프라인을 갖추고 있기 때문이다.
측정. 전후의 DORA 자체 지표들: 배포 빈도, 변경 리드 타임, 변경 실패율, 복구 소요 시간(한 서비스에 대해 6주는 잡음이 많으니 숫자가 아니라 추세를 읽는다). 리뷰 소요 시간은 누락된 결함 수와 짝지어, 속도가 얕은 리뷰에서 나오지 않도록 한다.
피치. 당신은 리뷰가 릴리스 적체의 원인이라고 말했다(경청). 반복되는 비용은 매 스프린트마다 같은 체크리스트를 손으로, 그것도 일관성 없이 적용하는 데서 나온다(위치 파악). 서비스 하나, 첫 번째 리뷰만, 모든 머지는 엔지니어가 승인한다(제한). 처리 시간이 줄고 변경 실패율이 유지된다면, 두 번째 서비스로 확장해볼 가치가 있다(증명).
네 가지 모두에서 드러나는 패턴
| 산업 | 첫 워크플로우 | 휴먼 바운더리 | 속도 신호 | 품질 신호 | |---|---|---|---|---| | 금융 서비스 | 레거시 모듈 하나를 문서화하고 테스트 작성 | 엔지니어가 모든 테스트를 승인; 프로덕션에는 반영하지 않음 | 문서화에 걸리는 시간 | 수정 없이 수용된 테스트 비율 | | 생명과학 | 저위험 도구 하나의 검증 테스트 스크립트 초안 작성 | QA가 모든 산출물에 서명; 환자 데이터 없음; 프로덕션에는 반영하지 않음 | 승인된 스크립트까지 걸리는 일수 | QA의 1차 반려율 | | 산업·제조 | 제어 코드 설명; 시뮬레이터 전용 테스트 | 시뮬레이터에 한정; 안전 등급 로직이나 프로덕션에는 전혀 반영하지 않음 | 루틴을 이해하는 데 걸리는 시간 | 시뮬레이션에서 발견된 결함 수 | | 소프트웨어·통신 | 테스트 백필 또는 첫 번째 리뷰 | 모든 머지는 엔지니어가 승인 | 리뷰 처리 시간, 리드 타임, 배포 빈도 | 변경 실패율, 누락된 결함 |
이 내기에 대한 내 답은C네 가지 중 세 가지는 프로덕션에 전혀 들이지 않는다는 것이다.DESIGN 내가 보기에 그 메커니즘은 이렇다. 게이트키퍼가 맨 처음 던지는 질문은 좀처럼 '이게 얼마나 좋은가'가 아니라 '최악의 경우 무슨 일이 벌어지는가'이다. 시험을 프로덕션 바깥에 두면 그 답은 '아무 일도 없다'가 되고, '아무 일도 없다'야말로 증거가 쌓이기 전에 게이트키퍼가 승인할 수 있는 유일한 답이다. 이것은 측정이 아니라 설계상의 판단이며, 매번 그 판단을 내리는 것은 다름 아닌 게이트키퍼다. 규제가 있거나 안전이 핵심인 환경에서는, 프로덕션에서 아무것도 바꾸지 않는 시험이야말로 게이트키퍼가 빠르게 승인할 수 있는 시험이고, 그것이 나중에 더 많은 것을 얻어낼 증거를 쌓아준다.
이 전략이 실패할 수 있는 지점
- 범주가 거칠다. 디지털 네이티브 은행은 지역 보험사보다 오히려 소프트웨어 기업에 더 가깝게 행동한다. 산업 라벨이 아니라 고객 자체를 따져봐야 한다.
- 규제는 글보다 빠르게 움직인다. SR 26-2는 올해 2011년 지침을 대체했고, EU의 고위험 AI 일정도 바뀌어왔다. 고객에게 어떤 규정을 인용하기 전에 반드시 현재 상태를 확인해야 한다.
- 프로덕션 바깥에 머무는 것이 막다른 길이 될 수도 있다. '코드를 설명한다'에서 '안전하게 바꾼다'로 넘어가는 단계를 아무도 책임지지 않으면, 그 시험은 결국 문서화 작업으로 끝나버린다. 시작하기 전에 그 책임자를 정해두어야 한다.
- 우리는 기본 전환율을 모른다. 이런 종류의 시험이 각 산업에서 실제로 프로덕션으로 전환되는 비율에 대해 나는 신뢰할 만한 수치를 갖고 있지 않다. 실패한 사례까지 포함해, 자신의 수치를 정직하게 세어보는 수밖에 없다.
- 슬라이드 7이 슬그머니 되돌아온다. 어느 산업이든 저마다의 역량 목록을 덧붙이고 싶은 유혹이 있다("이것도 되고, 컴플라이언스까지 된다!"). 워크플로우 하나. 팀 하나. 6주.
이번 주에 할 일
다음 고객과 가장 가까운 산업을 고른다. 위 표의 한 행을, 고객 자신의 언어로 표현한 고충을 써넣어 채운다. 그런 다음 그 행을 구매 결정권자가 아니라 게이트키퍼에게 보여주고, 질문 하나만 던진다. "이걸 승인하는 데 무엇이 걸림돌이 될까요?"
다음으로
이로써 시리즈가 마무리된다: 모든 피치보다 오래가는 원칙, 이번 시즌의 실무, 그리고 네 산업을 위한 첫 워크플로우까지. 시즌 레이어는 증거가 바뀌는 대로 함께 바뀔 것이고, 1부에서 다룬 원칙은 내가 끝까지 유지될 것으로 보는 부분이다.
출처
- Board of Governors of the Federal Reserve System. SR 26-2, "Revised Guidance on Model Risk Management"(OCC, FDIC와의 기관 간 공동 지침). 2026년 4월 17일.
- EIOPA. 디지털 운영 복원력 법(Digital Operational Resilience Act, Regulation (EU) 2022/2554), 2025년 1월 17일부터 적용.
- US eCFR. 21 CFR Part 11, 전자 기록 및 전자 서명.
- US FDA. "Computer Software Assurance for Production and Quality Management System Software." 최종 지침, 2026년 2월(문서번호 FDA-2022-D-0795).
- International Federation of Robotics. World Robotics 2025, 보도자료.
- ISA. ISA/IEC 62443 표준 시리즈. IEC 61508, 전기·전자·프로그래머블 전자 안전 관련 시스템의 기능안전.
- Google Cloud. "Announcing the 2025 DORA report." 2025년 9월 23일.