AI 原生系列 · Agent 工程
一个 AI 评审了我的仓库,然后让我把它改差
它给我打了 8.6 分(满分 10 分),提出了十二条升级建议。其中一半是真的。有一条如果照做,会悄悄推翻这个代码库里做得最好的一个决定——而我唯一能分辨真假的办法,就是停止读评审报告,转而去读代码本身。
一分钟读完
针对我这个开源循环引擎的一次 AI 评审,写得很用心、条理清晰,但它引用的依据几乎全都是我自己的 README。它提出的十二条建议里,六条是真实的缺口;五条是我已经半途搭好、但文档没写全的东西;还有一条,功能其实已经做好了,而它的建议却会把这个功能换成一份封闭清单——换掉的正是一个开放的插件注册表。我做了其中最大的那个真需求:一个描述「一次运行」的契约文件,难点根本不在 schema 本身,而在于让这份文件有能力拒绝我。做到这一点靠的是三条规则,而它们可以推广到任何你写过的治理文件上。
这次评审
有人把一个前沿模型跑在 loop-engineering-anything 上——这是我的引擎,负责把一个生成出来的工具在独立评审的打分下从 F 级一路推到 A 级——然后把输出结果发给了我。写得不错,甚至比我收到过的大多数人类代码审查都要好:结构清晰、具体到位,在我确实下过功夫的地方也给了中肯的赞许。它提出了十二条升级建议,后面还跟着一份二十三条的待办清单。
标题也挺扎眼:你的架构太像 CLI 了。 它最后的建议是引入一种正式的“产物类型”——把引擎能收敛出的东西限定成一份固定清单——这样仓库标榜的“anything”才能名副其实:
"Keep CLI as the first proven lane, but abstract the engine around 'artifact convergence,' not 'CLI convergence.'"(中译:先保留 CLI 作为第一条已验证的路径,但要把引擎抽象成围绕“产物收敛”而非“CLI 收敛”来设计。)
问题是:这篇评审对我代码的每一条论断,所依据的出处都只有一个——我的 README。
这不是抓把柄,而是这篇文章里最有用的一句话。一个只能看到门面的评审者,评审的自然就是门面:如果门面上写着“这东西只会生成 CLI”,评审者据此判断“这东西只会生成 CLI”,逻辑上完全正确。这个发现是真实的,只不过它不是关于我架构的发现,而是关于我文档的发现——只是披上了架构的外衣。
于是我干了件枯燥事:在动手改代码之前,先花一个小时把自己的源码重新读了一遍。
代码给出的回应
它的建议是往一个中央 schema 文件里加类似这样的东西:
artifact_type: Literal["cli", "mcp_server", "agent_skill", "workflow", "spec"]一份封闭清单。引擎能改进的每一种新类型,都得变成对那一个文件的一次编辑,由那个文件的所有者来审核。
但引擎八周前就已经加了一道“泛化接缝”,而且方向恰恰相反。一个 domain 是一个很小的插件,只需要回答三个问题——这个目标归不归我管、第一版怎么搭、由谁来当裁判——然后它在启动时向一个注册表报到即可。要支持一种新的目标类型,只需要一次注册,中枢部分完全不用动。我当时写的模块 docstring 是这么说的:"a new domain arrives as a registration, never as an edit to router.py or the controller…"(中译:新的 domain 是以注册的方式加入的,而不是靠编辑……或者控制器。)
评审者的建议,实际上会把一个开放系统变成封闭系统。这不是恶意,也不是蠢——它只是看不见那道接缝,因为那道接缝根本没写进 README。
十二条建议里,六条是真实的缺口,五条是我半成品、文档没写全的东西,还有一条就是刚才这个。我把裁定逐条写下来,和代码一起提交[5],因为一份你只在心里反驳过的评审,六个月后你还得再吵一遍。
真正的缺口,以及缺口里的陷阱
点破之后,最大的那个真实漏洞简直有点难为情。你告诉我引擎去做什么——改进什么、多好算够好、试几次、花多少钱、什么时候停手——这一切统统只存在于命令行参数里。敲进终端,窗口一关,就没了。
所以,这个「请求」本身,根本没有对应的产物——ask。我可以给你看一次运行成果的完美证明,却给不出它当初到底被要求做什么。修复方法很明显:把这个「要求」写进文件,把文件提交进版本库。
陷阱恰恰就在这里——因为最显而易见的修复方式,也正是软件说谎最常用的手法。
少了一个字母,一千台服务器缩到一台
Kubernetes 是支撑着全世界相当一部分服务器集群运行的系统。你在一个 YAML 文件里写下你想要的状态,交给它执行。2023 年 4 月,两位 Google 工程师在 Kubernetes 官方博客上发布一项校验功能时,回顾了过去当你把文件写错一点点会发生什么——[1]:
"Before Kubernetes v1.8 (!), typos, mis-indentations or minor errors in YAMLs could have catastrophic consequences (e.g. a typo like forgetting the trailing s in replica: 1000 could cause an outage, because the value would be ignored and missing, forcing a reset of replicas back to 1)."(中译:在 Kubernetes v1.8 之前(没错,就是这么晚!),YAML 里的拼写错误、缩进错误或其他小失误都可能造成灾难性后果——比如忘记写 replica: 1000 末尾的那个 's',就可能导致服务中断,因为这个值会被系统忽略、视为缺失,进而把副本数强制重置回 1。)replica: 1000
把这句话再慢慢读一遍。你要的是一千台。你写的是 replicareplica,而不是 replicasreplicas。系统没有跟你争辩。它接受了你的文件,丢弃了它认不出的那个词,发现没有任何指令告诉它该跑多少台服务器,于是很“贴心”地退回到默认值:一台。
你的文件被接受了。你的服务器集群却没有。
引文里那个惊叹号是工程师自己加的。他们特意标出来,是因为「在 v1.8 之前」这段日子,实在太长了——一个系统竟然长期把拼写错误当成对默认值的默默投票。
这不是 Kubernetes 独有的缺陷,而几乎是所有配置解析器与生俱来的默认行为,而且它源自一个出发点相当良善的工程传统——“对输入要宽容”。2023 年,互联网架构委员会(IAB)发布了一份文件,反过来收回了这条建议,理由是这种宽容“在所有场景下都已不再被视为最佳实践”。Martin Thomson 和 David Schinazi 写道——[2]:
"Time and experience show that negative consequences to interoperability accumulate over time if implementations silently accept faulty input."(中译:时间与经验表明,如果实现默默接受有问题的输入,其对互操作性造成的负面后果会随时间不断累积。)
他们的推理才是真正值得借鉴的部分:宽容不是免费的,也不是局部的——一旦某个实现悄悄接受了一个畸形的东西,之后所有基于它构建的东西,依据的就不再是规范本身,而是那次悄悄的接受。他们称之为连锁反应——"Overapplication of the robustness principle therefore encourages a chain reaction that can create interoperability problems over time"(中译:因此,鲁棒性原则的过度应用会引发一种连锁反应,随着时间推移制造出互操作性问题。)——并指出,这种伤害在系统早期最为致命,因为今天的一个小怪癖,会变成明天不得不兼容的“规范”。
一份年轻的治理文件,其实就是一份年轻的协议。
许可条
下面是我用的这套模型,你可以拿它套用到你自己写的任何一份配置文件上。
学校组织校外活动,需要家长签一张许可条。要让它真正成为一种约束,而不只是一张纸,需要满足三件事:
- 它只能要求学校实际能提供的东西。 你可以申请校车。但在条子上写「外加一架直升机」,并不会真的召来一架直升机。
- 如果你写了办公室看不懂的东西,他们会把条子退回给你。 他们绝不会一边让你以为直升机真的要来了,一边把你送上校车。最糟的结局不是许可条被退回——而是许可条被接受了,孩子却孤零零地站在停机坪上。
- 你不能自己签这张许可条。 你的家长可以额外加一句「不含花生」。但你们俩谁都不能划掉「必须有签名」这一条。
这三句话,就是我做的这份契约的全部设计。落到代码里,是这样的。
规则一——它只编译,不扩展
凡是能配置任何东西的键,都只是给循环已经遵守的某个设置赋值。这个文件不能引入新旋钮,只能填一个已经存在的。顶层八个键,budget 区块里十个,gate 和 evidence 区块各有若干,仅此而已。命令行驱动的路径和文件驱动的路径,最终交给引擎的是同一个对象:一条代码路径,两个入口。
规则二——生词是一个错误,不是耸耸肩
这就是被强制执行的 Kubernetes 教训:
$ loop-anything contract check loop.yaml
Error: loop.yaml.budget: unknown key(s) ['max_iteratons']; accepted:
['compression_interval', 'max_iterations', 'max_tool_retries', 'max_wall_seconds',
'min_score_gain', 'plateau_patience', 'plateau_pivots', 'target_grade',
'target_score', 'token_budget']. A contract may only declare what the engine enforces.解析失败。运行不会启动。而错误信息本身就是一份待办清单——它会列出每一个被接受的键,所以打错字只要几秒钟就能发现,不必再花一场调试会。(那段输出在终端里只是一行;这里为了适应页面做了折行。)
这条规则真正考验判断力的地方在后半段。评审提出的 schema 里包含这样一个区块:
safety:
  forbidden:
    - delete_production_data
    - expose_credentials
读起来非常漂亮,任何合规审查都能顺利通过。但在我的引擎里,压根没有任何东西会去读它——真正的强制执行发生在别处,在一个拒绝 shell 元字符、把写入行为关进工作区牢笼里的沙箱中。接受那个区块,只会造出第二套摆设式的安全系统,它唯一的功能就是被人截图放进 PPT。
一条没人执行的规则,就像一栋没装烟雾报警器的大楼里挂的“禁止吸烟”牌子。它不能阻止火灾,只能让这场火灾变得“不合规”。
所以解析器会把它拒掉,指名道姓,并给出原因。同样的处理也适用于一个domain:键(运行路径目前还无法强制指定 domain,接受它也不会产生任何效果),以及各维度打分权重(评委拥有自己的评分标准;被打分的那个东西自己写的文件,绝不能反过来左右打分)。每一项一旦有东西真正去执行它,就立刻变得合法。错误信息就是路线图本身。
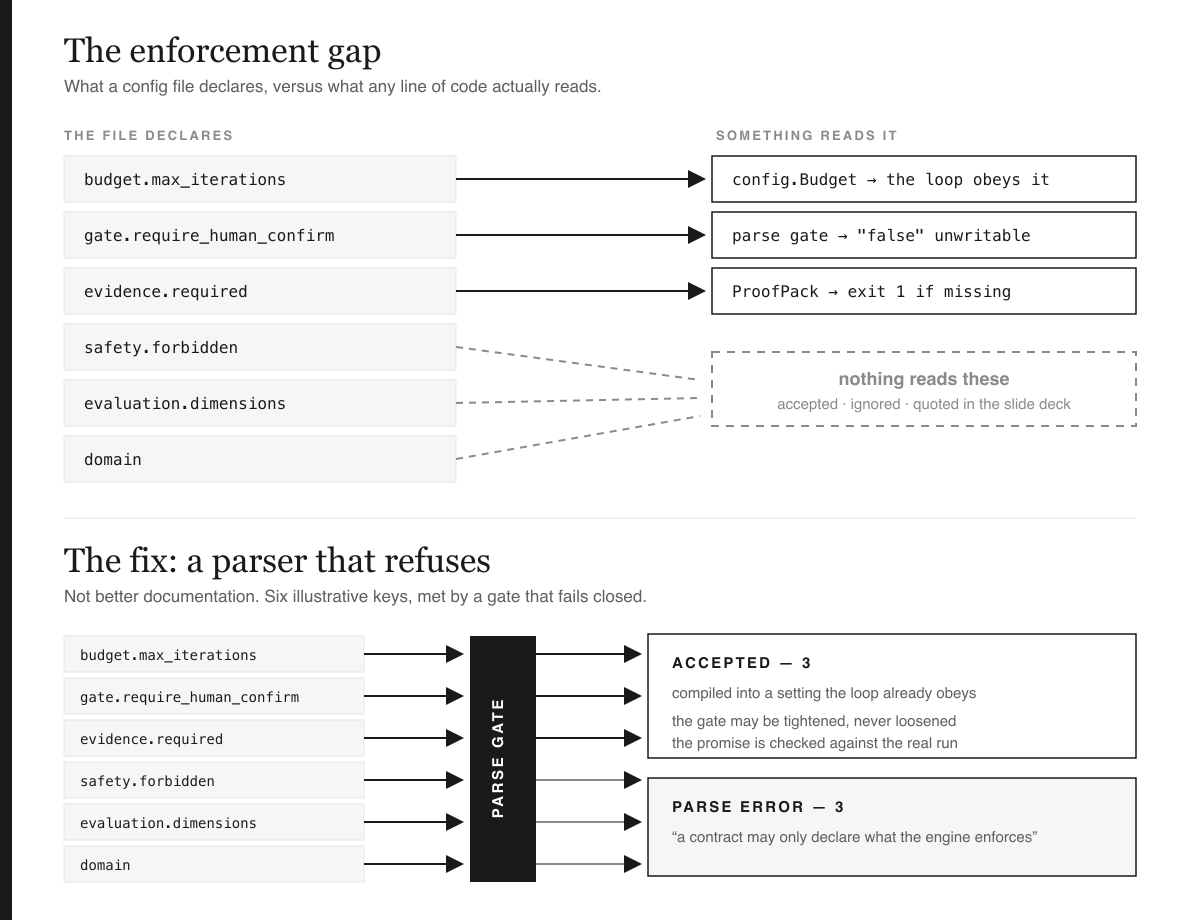
规则三——闸门只能收紧,不能放松
我的引擎有一条比这一切都更早存在的规则:当一次运行报告成功时,那只是一个声称,不是一个已经交付的事实,除非有人类确认。有一个 flag 可以在有人值守的运行中给出人类的确认;但故意没有任何 flag 可以关闭这道闸门——一次无人值守、定时触发、企图给自己工作预先盖章的运行,会被直接拒绝。
评审者提出的合同设计里包含一个带布尔值的人类闸门区块:require_confirm_before_ship: true。这意味着它也可以被写成 false。而这份合同的作者,恰好就是那个希望这次运行能够上线的人。
所以在我的实现里,这个字段可以省略,也可以设为 true。把它设为 false 会触发一个带说明的解析错误。一份合同可以增加审核人,但绝不能移除签名。这张许可条没法自己取消家长签字这一要求。
值得精确一下——毕竟这篇文章讲的就是精确:这个字段在运行时编译出来的是什么都没有。闸门本来就默认开启,也没有任何代码路径会去读这个键。它唯一的作用,是让 false 无法被写成别的值——这是整份合同里唯一一处,解析器本身不是通往某个设置的门,而就是执行机制本身。按我自己的第二条规则,这本该是一个「无人读取」的键,但我还是留着它,因为它所拒绝的那件事,值得被大声拒绝。(这道闸门确实有一个绕过方式,但不是调用者能用的:一个由构建平台自己掌管的环境变量,在定时运行中永远不会被接受。)
证据:让它不只是一句承诺的那部分
文件的最后一节列出了这次运行必须证明的东西——前后评分、逐维度差异,以及修复被采纳时记录下的回归测试。这样的条目一共有七个,你写下的每一个名字都必须是这七个之一,因为那才是一次真实的运行真正能够产出的东西。
接着,一条命令会拿这份文件去对照实际记录下来的运行结果:
$ loop-anything contract evidence loop.yaml --run 12
  present  grade_trajectory
  MISSING  regression_tests
Error: run #12 is missing declared evidence: regression_tests
退出码 1。我的证据包宁可省略也不会去伪造一个自己没有来源的字段,所以缺失的条目,恰恰暴露出「承诺的」和「证明的」之间真实存在的差距——在那个例子里,是一次已经收敛的运行,却从未记录下本该抓住那个回归 bug 的测试。
这就是「治理产物」和「治理装饰品」之间的区别。只有前者,能打印出一条写着你名字的失败信息。
评审者错在哪——以及这为什么要紧
我没有直接照单执行那份 backlog,还有第二个原因,而且这个原因跟这次具体的评审无关。
这台引擎的核心纪律是:构建的东西,绝不能同时是评分的东西。Arjun Panickssery、Samuel Bowman 和 Shi Feng 在 2024 年给这条纪律找到了度量方式[3]:
"One such bias is self-preference, where an LLM evaluator scores its own outputs higher than others' while human annotators consider them of equal quality."(中译:其中一种偏差是「自我偏好」——大语言模型评审者会给自己生成的输出打出比别人更高的分数,而人类标注者认为两者质量相当。)
他们更进一步,而这才是最锋利的部分:把模型微调到更擅长识别自己写的文字,产生的结果是"a linear correlation between self-recognition capability and the strength of self-preference bias."(中译:自我识别能力与自我偏好偏差的强度之间,存在一种线性相关关系。) 一个模型越擅长认出自己的「嗓音」,就越偏爱它。自我评估失灵,不是随机的失灵;它失灵的方向,是有偏向性的.
AI 评审你的仓库,跟 AI 给自己的输出打分,并不是一回事——这位评审者在我的代码里没有任何利益牵扯。但底层的动作是一模一样的,而这个动作,正是这整台引擎存在的意义所在——去拒绝它:接受一方给出的裁决,却不去核实它的证据。 这篇评审的证据来源就是我的 README。等我拿它去对照源代码后,它给出的八项维度评分里有五项在我自己重新打分时发生了变动——三项降低,两项提高。它评得最低的一项,通用性,恰恰是我提升最多的一项;而我调低的几项——安全性、可观测性和企业就绪度——是它评得比代码实际水平更宽厚的几项。
模式与反模式
模式。 让解析器默认拒绝(fail closed),并让失败信息把所有合法选项都列出来。让策略文件只能收紧默认值,绝不能放松它。在接受某个字段之前,先明确将来由谁读取它。用退出码核对声明的证据与实际产出的证据是否一致。把评审的裁决记录随代码一并提交,让这场争论也能被版本控制追溯。收紧 默认值,绝不能放松它。在接受某个字段之前,先明确将来由谁读取它。用退出码核对声明的证据与实际产出的证据是否一致。把评审的裁决记录随代码一并提交,让这场争论也能被版本控制追溯。
反模式。 没人读取的配置键。写在文件里却没有安全代码去打开的安全区块。一个能让作者自己免审的布尔值。一份必须靠修改才能扩展的封闭类型列表。仅仅因为编号整齐、格式规范就去执行一份待办清单。还有最古老的那个:把「解析通过」当成「已被理解」。
机制,一句话说完
这个机制有个名字,叫执行缺口(enforcement gap)——配置文件所声明的内容,与代码实际读取的内容之间的距离。每一处悄无声息的配置错误、每一件装饰性的合规摆设,都藏身在这道缺口里;而这道缺口天生不可见,因为一份被忽略的文件,看起来和一份被遵守的文件一模一样。
有史以来最大的一个案例,甚至根本不是配置文件。Do Not Track(请勿追踪)是一个请求头:一旦你打开它,浏览器就会发送出去,表示你不希望被追踪。多年来,浏览器都忠实地发送着它。但没有任何服务器被要求去读取它。它的工作组已于 2019 年 1 月 17 日关闭,相关规范也已被列入退役[4]——整整十年,一个被完美传送、却无人被要求遵守的偏好。
于是,第一条原则是:一份不会失败的声明不是控制,而是一件戏服——因此,给系统加上治理机制唯一诚实的方式,就是同时加上拒绝的能力。
本文不主张的事
- 没有基准测试。 我没有测量过这份契约是否真的减少了现实世界中的配置错误。这是一个设计论证,外加一次实现,而不是一项研究。
- 这份评审并不差。 它一半的内容是对的,而它最好的一个想法——测量我的循环在多少次场合里报告成功、而一个更强的评委会不认同——恰恰是我还没做出来、也最需要做的东西。
- 一个引擎,一个作者。 这三条规则来自我自己的代码库。Kubernetes 与 IAB 的证据支持的是这个原则本身,而不是我这一份具体的实现。
- 测试数量不等于质量。 测试套件从 543 条增长到 600 条通过测试。这衡量的是新代码的覆盖率,不代表设计本身是对的。
结论
这次升级一天之内就上线了。教训也花了一整天才想明白——而且和 YAML 一点关系都没有。
当一个非常流畅的系统甩给你一份组织得非常漂亮的问题清单时,清单的流畅程度丝毫说明不了它的可信度。先问它读过什么,再去读它读不到的东西。
等你真正动笔去写那份治理文件——合同、政策、标准、检查清单——的时候,先写拒绝条款。如果你说不出什么样的输入会让它打印出一条署着你名字的错误信息,那你造的就不是控制机制,你只是印了一张告示牌。
参考文献
- Jeffrey Ying 与 Antoine Pelisse(Google),Kubernetes 1.27: Server Side Field Validation and OpenAPI V3 move to GA,Kubernetes 官方博客,2023 年 4 月 24 日。kubernetes.io/blog/2023/04/24/openapi-v3-field-validation-ga。逐字引用;括号内的感叹号为原文所有。
- M. Thomson 与 D. Schinazi,Maintaining Robust Protocols,RFC 9413,Internet Architecture Board(IAB)系列文件,2023 年 6 月。rfc-editor.org/rfc/rfc9413。两处引文均已对照 RFC 原文逐字核实(第 2 节与第 4.1 节)。
- Arjun Panickssery、Samuel R. Bowman 与 Shi Feng,LLM Evaluators Recognize and Favor Their Own Generations,arXiv:2404.13076,2024 年 4 月 15 日。arxiv.org/abs/2404.13076。引文出自摘要部分。
- W3C 追踪保护工作组。该工作组页面写道:"The working group is currently closed. It closed on 17 January 2019,"(中译:该工作组现已关闭,关闭日期为 2019 年 1 月 17 日)并将「追踪偏好表达」(DNT)相关文档列入已退役规范之列。w3.org/2011/tracking-protection.
- 对这篇评审逐条做出的裁决,与它所讨论的代码一并提交存档:docs/solutions/external-eval-2026-08-12.md。合约文件本身是
src/loopeng/contracts/run_contract.py,其设计说明是docs/solutions/run-contract.md,带注释的示例是docs/examples/loop.yaml,均在github.com/wjlgatech/loop-engineering-anything.
写于 2026-08-12。促成本文的那篇评审,是应一位读者的要求由某前沿语言模型生成的;我保留了它的论点,但没有透露它的身份——因为重点在于信源,而不在于是哪个模型。