AIネイティブ・シリーズ · エージェント型AIを売り込む、全3回中の第2回
今シーズン、エージェントをどう売るか——境界あり、説明責任あり、エビデンス主導
1分でわかる要点
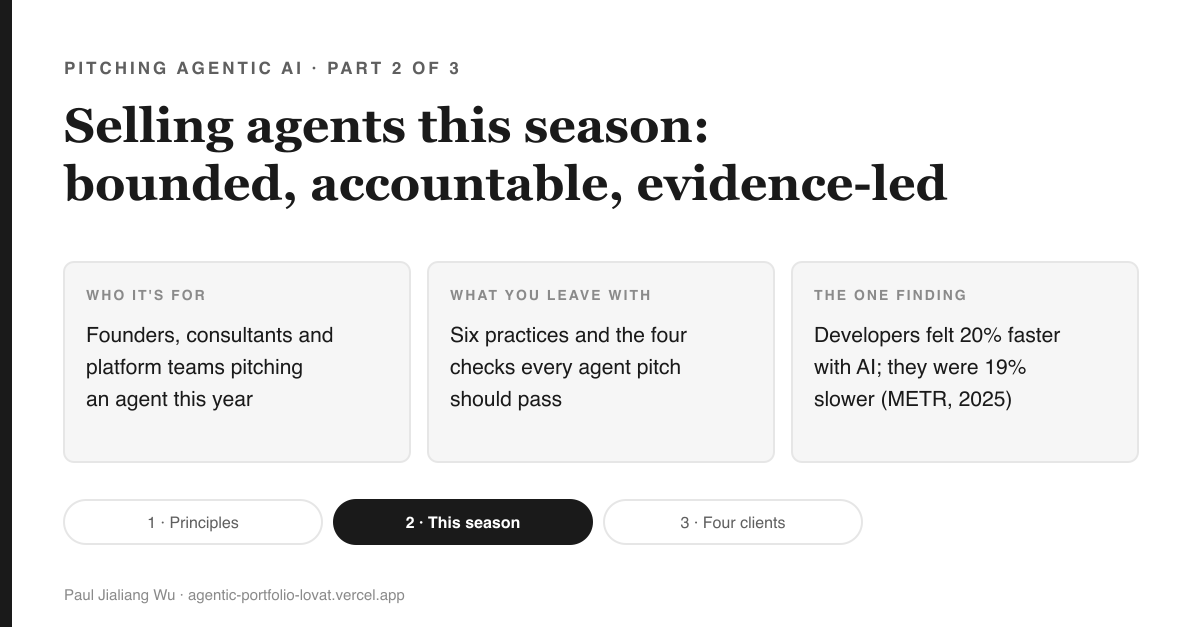
これは何か。 シリーズ第2回。今シーズンにAIエージェントを売り込むための実践と、すべての売り込みが満たすべき4つのチェック——具体的であること、サイズを正直に見積もること、人が責任を持つこと、事前に測定基準を決めておくこと——を扱う。
なぜ重要か。 2025年のランダム化試験では、経験豊富な開発者がAIツールを使うと19%遅くなったにもかかわらず、本人たちは自分が20%速くなったと信じていた(METR)。広範な生産性向上という約束こそ、エビデンスが最も裏づけない主張だ。
読んだ後にできること。 第1回で書いた4行を、4つのチェックにかけてみてほしい。それから、ノーと言える人に向けて一文を書く——エージェントが触れる範囲は何で、承認するのは誰か。
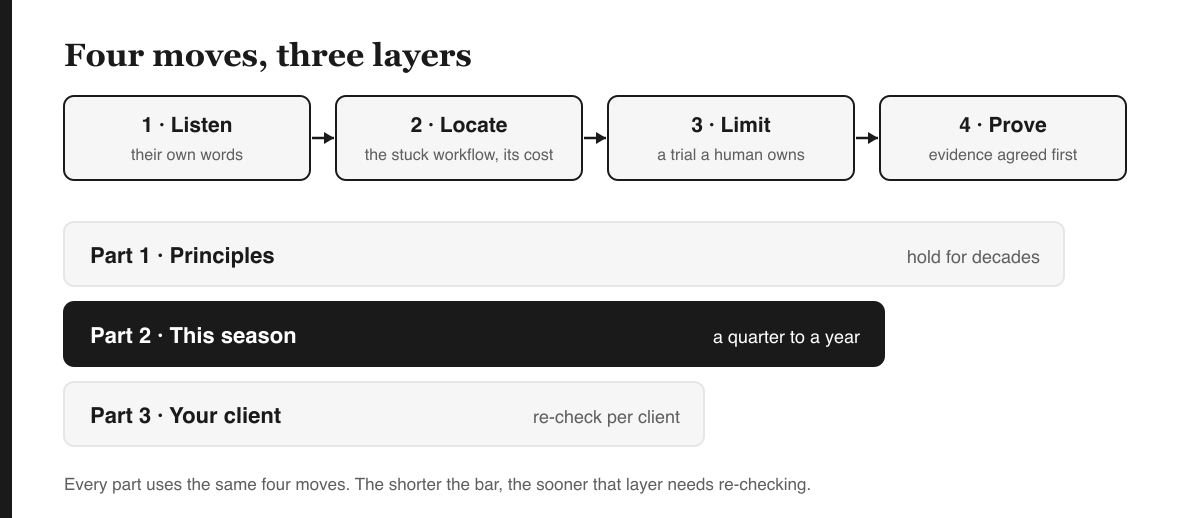
Pitching Agentic AI — シリーズの背骨
- あらゆる売り込みより長く残る原則 第1話
- 今季、エージェントを売り込む この回
- 四つのクライアント、四つの最初のワークフロー 第3話
ラベルの読み方: EVIDENCE は出典あり、 DESIGN は推奨される実践、 OPEN はまだ検証されていないもの、そして LENS は私自身の見解を示す。
企業のAI試験導入はしばしば止まってしまうが、その大きな理由はスコープの切り方にある。2025〜26年向けの6つの実践は、一つの考えを軸にしている——行き詰まったワークフローを一つだけ選び、あらかじめ合意した対になる指標に売り込みを語らせるのだ。驚くべきことに、AIコーディングツールの最良の試験結果同士が食い違っている。
今回の内容:今すぐAIエージェントを売り込む方法
第1回の原則はほとんど動かない。だがこの層は、1年ほどのペースで動く——買い手がどう買うか、エビデンスが現時点で何を語っているか、そしてガバナンスについて何を尋ねてくるか、といったことだ。これは、スタートアップの創業者であれ、コンサルタントであれ、社内プラットフォームチームであれ、今年企業にエージェントを売り込もうとしている誰にとっても役立つ内容である。私はAccentureに勤めており、同社は以下の研究の一つに登場する。その点は、話が及ぶところで明記する。ここに書かれていることはすべて、公開情報源から私自身がまとめたものだ。
まず賭けてみる
2025年に行われたランダム化比較試験では、経験豊富なオープンソース開発者たちが、自分たちのリポジトリで実際のタスクに取り組んだ——AIツールを使う場合と使わない場合の両方で。開始前、彼らはAIによって自分たちが約24%速くなると予測していた。実際にAIを使うと、タスクにかかった時間は——
- A. 約20%短くなった。
- B. ほぼ同じ時間。
- C. 約19%多く時間がかかった。
実践1:ピッチの前に見極める
EVIDENCE エンタープライズ営業はとうの昔にこれを定式化している。MEDDICは、実践者たちが1990年代のPTCに起源をたどるチェックリストで、指標、経済的な決裁者、決定基準、決定プロセス、痛み、そして推進者(チャンピオン)の存在を問う。その起源の物語は実践者の間の言い伝えであり、詳細は検証されていないが、それでも生き残っているのには単純な理由がある。オーナーもおらず、合意済みの指標もない取引は、デモがどれほど優れていても、まずまとまらないからだ。
DESIGN エージェントの試行にあたって、私は自分なりに4つの質問を加えている。結果に対する明確な責任者はいるか。チームはアクセス権とコンテキストを提供できるか。アウトプットを判断する時間のあるレビュアーはいるか。その作業は、チェックする方法があり、スコープを切れるくらい再現可能か。どれか一つでも欠けていれば、それは押し進める理由ではなく、立ち止まって見つけるべき理由だ。
実践2:プレッシャーの中で一つのワークフローを選ぶ
DESIGN 行き詰まったエンジニアリング業務は、たいてい次の4つのどれかに似ている。私はこれを「四つのR」と呼んでいる。
| 行き詰まった業務の見え方 | 典型的な症状 | 範囲を絞った最初のタスク | |---|---|---| | 待ち(Waiting) | レビューや承認が滞留する | チーム自身のチェックリストに照らした一次レビュー | | やり直し(Redoing) | 手戻り、不安定なテスト、パイプラインの再実行 | ある一つのサービスの失敗したCIランのトリアージ | | 学び直し(Relearning) | 人から人へ引き継がれる中で文脈が失われる、誰も把握していない古いコード | 遺産モジュールを1つ、読み取り専用で説明・文書化する | | 再説明 | 引き継ぎ、古びたドキュメント、繰り返される質問 | 1件のインシデント履歴からランブックを起草する |
1行だけ選ぶ、1つのチームのために。オートコンプリートほど狭くもなく、全社自動化ほど広くもない——それはただ予算のついたスライド7にすぎない。
実践3:ノーと言える人も含め、相手ごとに語り方を変える
DESIGN 同じ停滞した業務でも、4者それぞれにとって意味が違う:
- 予算責任者(CTO、エンジニアリング担当VP):キャパシティ、品質、リリースへの自信。
- プラットフォーム責任者:一貫性、開発者体験、重複調査の削減。
- 日程責任者(プロダクト):約束の先送りの減少、より予測可能なリリース。
- ノーと言える人(セキュリティ、リスク、品質):エージェントが触れられる範囲、誰が承認するか、何が記録されるか。
大半のピッチは最初の3者には対応している。私が停滞するのを見てきた案件では、たいてい4人目——決して一文すら与えられなかった人物——が原因だった。
実践4:エビデンスが裏付ける範囲だけを主張する
EVIDENCE 賭けの話に戻ろう。答えはCだ。METRの2025年ランダム化試験(経験豊富な開発者16名、自身のリポジトリでの246タスク)では、AIツールの使用によりタスクにかかる時間が19%長くなったにもかかわらず、開発者たちは事後もAIのおかげで約20%速くなったと信じ続けていた(Becker et al., METR, 2025)。METRはその後、再実験では弱いシグナルしか得られなかったと述べている。多くの開発者がもはやAIなしでは作業しなくなっていたためであり、METRは現在、開発者は以前より速くなっている可能性が高いと考えているという(METR、Uplift update、2026年2月).
EVIDENCE 一方で、Accenture(筆者の勤務先)を含む3社での実地実験では、4,867人の開発者を対象に、AIコード補完ツールの使用により完了タスク(「生産性」ではなくプルリクエスト数)が約26%増加した。増加幅は経験の浅い開発者のほうが大きかった(Cui et al., The Effects of Generative AI on High-Skilled Work, 2024–25)。GoogleのDORA 2025調査(専門家約5,000人対象)では、AI利用はスループットの向上と結びつく一方で、デリバリーの安定性は低下することがわかった。AIはすでにあるものを増幅するのだ(DORA 2025 announcement).
DESIGN これらは、現場の状況と時期で読み分ければ矛盾しない。すなわち、2022〜23年の幅広い層向けコード補完、2025年初頭のツールを使う成熟したコードベースの経験豊富な開発者、そしてデリバリーシステム全体という違いだ。だからこそ「開発者の生産性」は約束として間違っており、合意済みの測定指標を伴うワークフロー固有の主張こそが誠実なのだ。
実践5:速度シグナルと品質シグナルを対にする
EVIDENCE パイロットが本番稼働に至るかどうかは、構築の仕方に大きく左右される。MIT NANDAの2025年の調査は、インタビュー、調査、公開されている実装事例に基づき、"external partnerships with learning-capable, customized tools reached deployment ~67% of the time, compared to ~33% for internally built tools,"(訳:学習能力を備えたカスタムツールによる外部パートナーシップは約67%の確率で導入に至ったのに対し、社内構築ツールでは約33%にとどまった)と報告しており、この数値が自己申告であることも自ら注記している(MIT NANDA, The GenAI Divide, 2025。広く出回っているこのレポートの写しより)。よく引用される「95%」という数字は、失敗したパイロットの割合ではなく、リターンがゼロだった組織の割合を数えたものだ。
EVIDENCE ベンダーは価格設定を成果連動型へと移行させつつある。Intercomはそのエージェント「Fin」について、解決1件につき0.99ドルを課金し(Intercom pricing)、Salesforceは「Agentforce」を会話単位またはアクション単位で課金する(Agentforce pricing)。「成果」の定義はベンダーごとに異なる。
DESIGN これがProveの実践の肝だ。速さのシグナルと質のシグナルをセットで合意し、その基準と誰が読むかも決めておく——レビューの折り返し時間と見逃された欠陥、ドキュメント作成時間と変更なしで受理されたテストの割合、といった具合に。速さだけを見るのは偽装が容易だ。レビューは浅くなるほど速くなり、インシデントの振り返りが起きるまでは誰もがそれを喜んでしまう。
実践6:トライアルの設計そのものにガバナンスを語らせる
EVIDENCE 買い手は今やガバナンスのチェックリストを携えてやってくる。EU AI Actは2025年8月以降、汎用AIモデルに対する義務を適用している(EU AI Act implementation timeline)。NISTのAI Risk Management Frameworkは米国での共通の参照先だ(NIST AI RMF).
DESIGN 範囲を絞ったトライアルは、その設計自体によってガバナンス上の問いの大半に答えを出す。エージェントが何に触れられるか、各出力を誰が承認するか、何がログに残るか、専門家が構成と制御をいつ確認するか——これらを明示すれば足りる。「何に触れられるか」という問いへの答えが一段落かかるようなら、そのトライアルは大きすぎる。
ピッチの前に確認すべき四つのチェック
- 具体的であること: 一つのワークフロー、一つのチームに絞る。
- サイズを正直に見積もること: 「評価する価値があるかもしれない」であって、変革の約束ではない。
- 人が責任を持つこと: 品質と承認の責任はエンジニアが持ち続ける。
- 事前に測定基準を決めておくこと: 速さと質のシグナルを、基準値とともに、開始前に合意しておく。
これがうまくいかない場合
- 証拠は動き続けている。 METRは自らの見立てを数ヶ月のうちに修正した。ここに挙げた数字はあなたが読む頃には古くなっているかもしれないので、引用する前に日付を確認してほしい。
- 見極めが口実になりかねない。 「準備ができていない」というのは時に本当であり、時に売り手が難しい案件を避けているだけのこともある。どの問いでつまずいたか、次にいつ尋ね直すかを書き留めておこう。
- それでも第四の人物はノーと言う。 エンタープライズがAIポリシーをどれほど早く整えるかは未解決の問題であり、限定的なトライアルは助けにはなるが、その待ち時間をなくすわけではない。
- 四つのRは私なりのレンズであって、法則ではない。 これらは私がこれまでに見てきた停滞業務を分類したものに過ぎず、あなたのクライアントの業務には当てはまらないかもしれない——それは早めに知っておく価値がある。
今週あなたがすべきこと
第1回で書いた四行を取り出し、四つのチェックにかけてみよう。そのうえで、ノーと言える立場の人に向けて一文を書く。エージェントが触れられる範囲はどこまでか、承認するのは誰か。それが書けないなら、トライアルを提案する準備はまだできていない。
次回予告
第3回では、ここまでの内容を、間違いが最も高くつく四つの業界——金融サービス、ライフサイエンス、産業製造、テクノロジー・通信——向けに作り直す。それぞれについて、痛点、オーナー、ルール、そして適合する最初のワークフローを示す。
出典
- Becker, J., et al. "Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity." METR, arXiv:2507.09089, July 2025.(訳:Becker, J.ほか『2025年初頭のAIが経験豊富なオープンソース開発者の生産性に与えた影響の測定』METR、arXiv:2507.09089、2025年7月)
- METR. "Uplift update." 24 February 2026.(訳:METR『アップリフト・アップデート』2026年2月24日)
- Cui, Z., Demirer, M., Jaffe, S., Musolff, L., Peng, S., Salz, T. "The Effects of Generative AI on High Skilled Work: Evidence from Three Field Experiments with Software Developers." SSRN 4945566 (2024; revised 2025).(訳:Cui, Z.、Demirer, M.、Jaffe, S.、Musolff, L.、Peng, S.、Salz, T.『生成AIが高スキル業務に与える効果:ソフトウェア開発者を対象とした三つのフィールド実験からの証拠』SSRN 4945566、2024年(2025年改訂))
- Google Cloud. "Announcing the 2025 DORA report." 23 September 2025.(訳:Google Cloud『2025年版DORAレポートの発表』2025年9月23日)
- MIT NANDA. "The GenAI Divide: State of AI in Business 2025." July 2025.(訳:MIT NANDA『生成AIの分断:ビジネスにおけるAIの現状2025』2025年7月)
- Intercom, pricing page; Salesforce, Agentforce pricing page. Both checked October 2026; prices change often.(訳:Intercom料金ページ、Salesforce Agentforce料金ページ。いずれも2026年10月時点で確認。価格は頻繁に変わる)
- EU AI Act implementation timeline (artificialintelligenceact.eu); NIST AI Risk Management Framework 1.0, January 2023.(訳:EU AI Act実施タイムライン(artificialintelligenceact.eu)、NIST AIリスクマネジメントフレームワーク1.0、2023年1月)
- 来歴:著者が2026年に参加したコーディングエージェント導入セッションを機に執筆した。practice、表、チェック項目は、上記の公開情報源を著者自身がまとめ直したものである。