AI 原生系列 · ANDON · 智能体化 PR 审查与 CI/CD · 第 3 集,共 5 集
PR 审查规则即数据:不会漂移的规则
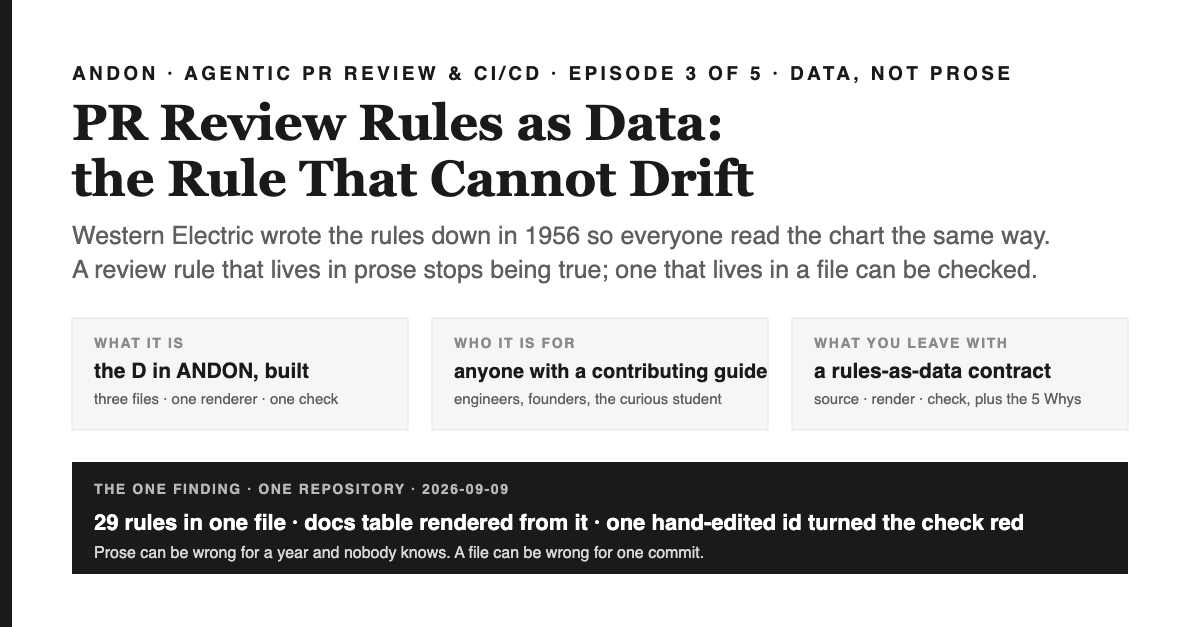
智能体化 PR 审查与 CI/CD 第 3 集。1956 年,Western Electric 发布了阅读控制图的规则,为的是让产线工人和工程师能以完全相同的方式读懂同一张图表。而今天大多数代码仓库仍把审查规则写在散文里:每个审查者理解不同,AI 审查者更是凭记忆随意转述。本集是 ANDON 里的 D。它把某个代码仓库的 PR 审查规则搬进三个数据文件,据此渲染出面向人类的文档页面,并新增一项检查——在每个 PR 上跑 CI,一旦页面与数据不一致就立刻失败。2026 年 9 月 9 日,也就是该检查上线三天后,我故意让它亮了红灯。
一分钟速览——读完你能带走什么
这是什么。 ANDON 系列ANDON第 3 集,五集系列聚焦智能体化 PR 审查与 CI/CD。这一集讲的是规则数据,而非散文,落地到一个真实仓库中,做法是PR 审查规则即数据:合并规则、体量阈值和响应策略各自存放在一个 JSON 文件里;审查者、各道闸门和面向人类的文档页面全都从这些文件读取;一项 CI 检查会从数据重新渲染文档表格,页面一旦出现漂移,检查便会失败。
为什么这件事重要。 对工程师而言:写在散文里的规则,靠的是谁还记得它,而在智能体化时代的仓库里,记得的人往往越来越少,模型还会把它转述成似是而非的另一套说法。对创始人而言:2026 年的政策普查发现,多数头部仓库如今允许 AI 贡献,约一半要求披露;据我的解读,那些政策全是散文,而一份只有人类才能解读的政策,扛不住洪流。对学生而言:这正是 Western Electric 在 1956 年、Shewhart 在 1931 年做过的同一个动作,只不过这次用在了贡献指南上。
读完之后你能做什么。 把每一条审查规则、每一个阈值、每一项豁免都放进一个数据文件,标上 id、级别、执行它的闸门和一段书面理由。人类看的页面要从文件渲染出来,绝不手打。再加一项检查,重新渲染并比对,然后亲手把它弄红一次,你才算真正见过它变红。
ANDON — 系列脉络
- A · 评估——PR 洪水是量出来的,不是凭感觉 第 1 集
- N·永不沉默——给仓库装上 Jidoka 第 2 集
- D · Data, not prose——不会漂移的规则 本集
- O · Only in the envelope——爆炸半径是一份路径清单 第 4 集
- N · 负向测试 —— 闸门必须先报红,才能上线 第 5 集
本集讲什么,以及为什么「PR 审查规则即数据」排在第三
第 1 集量出了 PR 洪流的规模,把机器闸门放到了最前面。第 2 集给每道闸门加了第三种状态,让「跑不动」被公示出来,而不是悄无声息。这两集都默认了一件事,而这件事到本集才真正需要去挣得:闸门执行的规则,和人类以为自己在执行的规则,其实是同一套。而在多数仓库里,这个假设悄悄地就不成立了。规则散落在贡献指南、PR 模板、wiki 页面和几个审查者的个人习惯里;CI 配置只强制执行其中一部分,用的数字在指南里根本找不到出处;至于 AI 审查者——如果有的话——拿到的提示词,是凭记忆转述出来的指南。三个读者,三套规则。
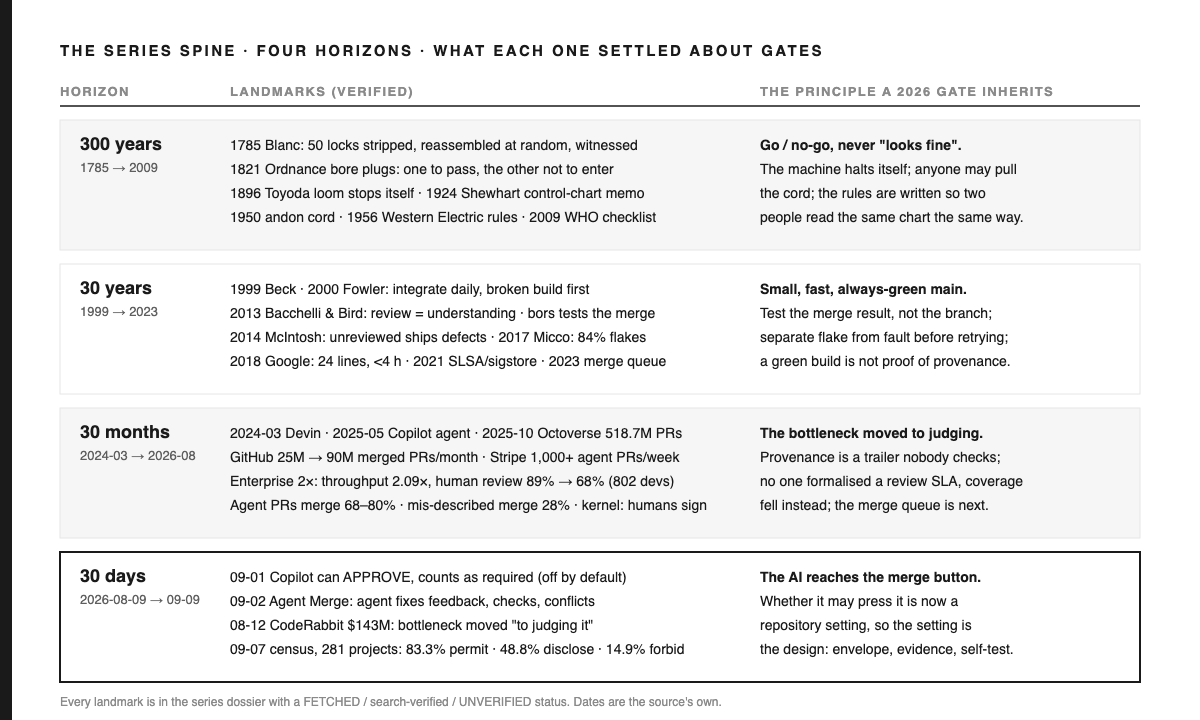
智能体化时代让这件事从「凌乱」变成了「昂贵」。2026 年对 GitHub 头部两千个仓库中 281 份 AI 贡献政策的普查发现,83.3% 允许使用 AI,48.8% 要求披露,14.9% 明令禁止 [1]。我自己在普查之外的观察是:我读过的那些政策都是散文,每条 PR 都得靠人去解读。一项针对 23,247 份由智能体撰写的 PR 的研究发现,1.7% 的 PR 描述与实际代码之间存在高度不一致,而本系列第一集也早已记录:描述有误的 PR 依然以 28% 的比例被合并 [2]。当描述可能是错的,审查者又往往是个机器人时,决定能否合并的规则,就绝不能是一段散文。
所以本集的规则是:规则先是数据,散文由数据渲染而成。举的例子还是第 1、2 集那个仓库:29 条审查规则、四道体量阈值和一套响应策略,如今都活在三个文件里;漂移检查上线三天后,我手动改了一个规则 id,就为了证明这项检查真能变红。它变红了——本地跑的,退出码也留了底。
这条规则最古老的版本:写下来,让两个人读到的是同一件事
这三百年的记录,记的都是把判断从一个人的脑子里搬到一件两个人都能认可的实物上。据 Roser 复原,Honoré Blanc 于 1785 年 7 月 8 日在 Vincennes 的演示是:"he disassembled 50 locks, picked pieces for 25 locks at random, and … assembled them again"(中译:他拆开 50 把锁,随机挑出 25 把锁的零件,再……把它们重新装了起来) [3]:可互换性是靠一场任何人都能重复的实验证明的,不是靠一句断言。Bomford 在 1821 年的军械指示中要求:"two plugs for the bore diameter, with one to pass through the barrel and the other not to enter"(中译:两个对应枪管口径的塞规,一个应能穿过枪管,另一个则不应进入) [4]:这是一条由两件实物构成的规则,通过与否不掺杂任何主观意见。Joseph Whitworth 的标准出现在「公差」概念之前;科学博物馆关于他那把线规的说明写道:"The concept of tolerance or specification by limits of acceptability had not at that time been established."(中译:当时尚未建立起以可接受限度来定义公差或规范的概念。) [5」标准说的是正确值应该是多少。限度说的是数值出错时该怎么办。闸门需要的是限度。
Shewhart 给出了此后一整个世纪都在沿用的定义。1931 年他写道:"A phenomenon will be said to be controlled when through the use of past experience, we can predict, at least within limits, how the phenomenon may be expected to vary"(中译:当我们能够借助过往经验,至少在一定限度内预测某一现象将如何变化时,便可以说这一现象是受控的) [6」。所谓受控,就是在写明的限度之内可预测。再往后,Western Electric 在 1956 年的手册里写下了解读其图表的判定规则。这么做的理由,在二手记录里留下了这样一句话:"Their purpose was to ensure that line workers and engineers interpret control charts in a uniform way."(中译:其目的是确保一线工人与工程师以统一的方式解读控制图。) [7」这句话,就是本集的主题。图表早就存在;1956 年添上的是那本规则手册,让站在机器旁的人和坐在办公室里的人,不再对图表说的是什么各执一词。
同样的做法一再重演。Juran 的手册于 1951 年首次出版[8];ISO 9001 于 1987 年发布,其前身是一份军用规范[9];到了 2009 年,那份把规则写成卡片条目的手术安全核查表,在八家医院、7688 名患者身上得到了验证:死亡率从 1.5% 降到 0.8%,并发症从 11% 降到 7%[10]。这些都跟软件无关。但它们说的是同一件事:活在实物载体里的规则,胜过活在专业经验里的同一条规则——因为实物载体每次都会被以同样的方式读出来。
第 1 集里那幅厨房的画面依然成立。一个人做菜,把菜谱记在脑子里。一家餐厅把它写在卡片上。一条连锁把它写成规范,精确到克数与度数,因为一千个厨房必须读出同一件事,谁都不许自由发挥。卡片不是菜谱的简化版,它是唯一可以被核对的版本。
| 厨房 | 仓库 |
|---|---|
| 规范卡:克数、度数、唯一被允许的替换项,且已签字确认 | 三份数据文件:带 id、level(级别)、gate(关卡)和 check(检查)的规则;阈值;带豁免情形及其理由的响应策略 |
| 打印出来的菜单,由卡片生成,绝不手工键入 | 文档页上的规则表,由 JSON 在两个标记之间渲染生成 |
| 每晚核对菜单是否仍与卡片一致的清点 | CI 里的漂移检查:重新渲染、比对,只要有差异就 exit 1 |
| 有人拿马克笔改了菜单 | 2026-09-09 手工改动一个规则 id,让漂移检查变红的那次操作(本地运行;与 CI 所用命令相同) |
30 年后的版本:Google 把审查者标准写了下来,只有一句话
同一思路在软件领域的谱系更短,且有一个经典范例。Google 公开的工程实践用一句话写明了审查者的标准:"reviewers should favor approving a CL once it is in a state where it definitely improves the overall code health of the system"(中译:审查者应当倾向于在一个 CL 已经明确改善了系统整体代码健康度的状态下批准它) [11]。这句话是散文式的表述,它在 Google 内部行得通,是因为它嵌在一种要求几乎所有改动都要经过审查的评审文化里,也嵌在一种围绕小改动构建的工具文化里 [12]。这是一间厨艺极好的餐厅的菜谱卡。把这句话原样搬进一个只有两位维护者、外加一个 AI 审查者的仓库,它又会变回一张没有规则的控制图:两位维护者对「明确改善」的理解会各不相同,而模型每跑一次又会读出第三种理解。
小一点的仓库需要的不是一句更好的话,而是把这句话拆解成可以被检查的东西:哪些条件是机器可判定的、会直接拦截;哪些是 AI 可以带着引用提出来的判断;哪些只有人能回答。这种拆解本身就是一种数据结构,一旦它成了数据结构,文档页、审查者的提示词和各道关卡就都可以从它生成,而不必再靠转述。
构建过程:三份文件、一个渲染器、一项检查
1. 规则文件
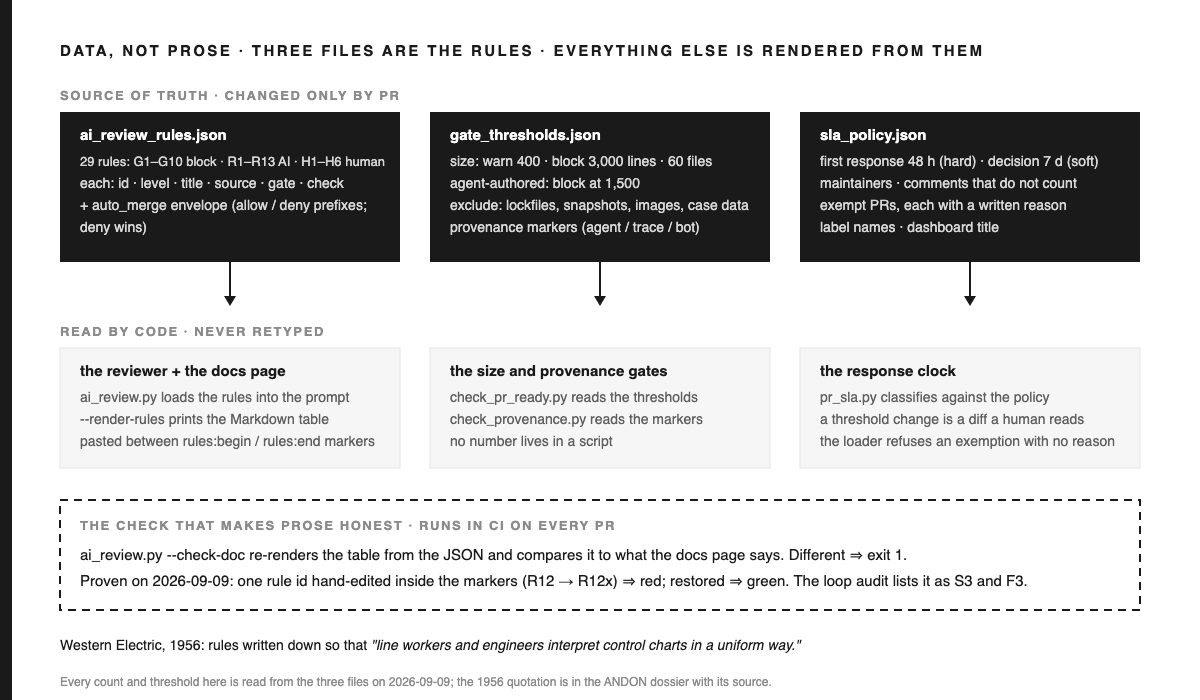
该仓库的合并规则存放在一份 JSON 文件里,截至撰写本文之日共有 29 条规则。每条规则携带六个字段:一个 id、一个 level(级别)、一个标题、该规则来源的原始文档、执行它的 gate(关卡),以及该关卡具体做的 check(检查)。级别分三种。十条规则是 block(拦截):租户隔离与写权限、diff 中不得含密钥、模型改动没有配套迁移、双语文档只改了一侧、第 5 集里的自测契约。这些由脚本强制执行,一旦亮红就无法合并。十三条规则是 ai(AI):AI 审查者可以提出的问题,每条都附带引用,包括团队在 2026-09-06 那次 PR 里一并加入的三条工程原则——面向对象设计、循环工程、图工程。六条规则是 human(人类):任何脚本和模型都无法回答的问题——业务场景、质量归属人、审批节点、结束标准、各项指标,以及现在是否该合并,这些只能由负责业务的联合创始人来判断。
同一份文件还承载着源自前作那篇文章的自动合并「信封」范围:在哪些路径前缀与后缀之内,一个全绿、全面被测量、且无任何发现的 PR 可以无需人类介入而自动合并,以及优先于任何「允许」的拒绝清单。这个「信封」之所以是数据,原因与规则相同:当有人问「AI 能不能合并对 workflow 目录的改动」时,答案应该是文件里的一行,而不是凭一次谈话的记忆。
2. 阈值与响应政策
规模闸门的数值存放在第二个文件里。有效行数超过 400 行发出警告,超过 3,000 行或改动 60 个文件即拦截,AI 代理撰写的 PR 超过 1,500 行即拦截;统计有效行数时排除锁文件、压缩后的资源、快照、图片、字体和生成的测试数据。文件自身的文档字段引用了依据:2006 年那项发现——审查效果在超过几百行后会崩塌,以及 Google 的小改动规范。一个能引用理由的阈值,是可以在 PR 里被讨论的;写死在脚本里的常量不能。
第 2 集里的响应时钟读取第三个文件:首次响应 48 小时,做出决定 7 天,维护者名单,不计入响应的评论标记,以及豁免的 PR。每一项豁免都带着一条书面理由:闸门建立之前遗留下来的那个 PR,以及故意保持开放的负向测试 PR。没有理由的豁免会被加载器拒绝。这句话在本文的审查者读到初稿时其实是假的:这项要求当时只以散文形式存在于文件自身的文档字段里,加载器居然接受了一个空字符串。本集的论点在自己的例子里翻了车,而这恰恰正是「审查者而非作者」这条规则存在的意义——检查在当天就被补上并合并,还带了一项自测,证明它确实会拒绝。
3. 渲染器与检查
向业务团队解释审查规则的那个人类可读页面,是生成出来的。一条命令把规则文件渲染成 Markdown 表格;这张表被粘贴在文档页面上两个 HTML 注释标记之间;标记之外的一切都是人写的散文,标记之内的一切都是脚本写的数据。第二条命令会重新渲染这张表,并与标记之间的内容做比较。任何差异都会打印一行重新生成的提示,并以状态码 1 退出。这条命令在每个 PR 上都会在 CI 里运行,是第 2 集里循环审计的第三项结构性标准。
在 2026-09-09 这天,我用唯一能证明一道闸门有效的方式证明了它:打开文档页面,在标记之间找到 loop-engineering 规则那一行,把它的 id 从 R12 改成 R12x,然后运行检查。它打印出了漂移信息,并以 1 退出。我把文件还原,再运行一次,退出码是 0。这一对退出码,就是标题里那句断言的证据;没有它,「规则不会漂移」这句话本身也只是一句散文。
当规则变成数据之后,发生了什么变化
在这个仓库里发生了三件事,若是散文式指南,它们都不会发生。第一,规则有了计数。29 是一个可以被盯着看的数字:循环审计里那条「复合」标准会从 git 历史里读出它,报告说它从 9 月 1 日的基线到写这篇文章那天,从 0 涨到了 29,测试和经验教训也一并算在内。一份指南没有计数,所以它没有趋势。第二,规则有了「来源」这一列。29 条规则里的每一条都写明了自己出自哪份文档;比如 loop-engineering 那条规则,引用的就是经验教训文件和响应提案。当负责业务的联合创始人问起审查者为什么标记了一个缺失的自测时,答案是一行记录,不是凭记忆的回想。第三,规则变成了 AI 会逐字读取的东西。审查者的提示词就是从文档页面所渲染的同一份文件构建出来的,因此模型在每次运行时拿到的都是同一张 29 行的表格,其中 13 条是它要回答的问题,而人类可以清清楚楚看到它到底被交代了什么。前一篇文章里「每条发现都必须带引用」这条规则,现在有了一个搭档:模型被问到的每一个问题,都带着一个 id。
值得一说的是,哪些东西没有变。表格周围的散文——那部分用厨房的比喻向新团队成员解释三层结构的文字——依然是散文,而且理应如此。数据取代的是那些冒充规则的散文,取代不了解释本身。
五个为什么:为什么审查规则必须先是数据,才能成为规则
| # | 为什么? | 因为 | 证据 |
|---|---|---|---|
| 1 | 为什么不把规则留在贡献指南里? | 因为一份指南会被每个审查者读出不同的意思,也会被模型在每次运行时读出不同的意思,于是这个仓库里的规则版本,就跟读者的数量一样多。 | 西方电气公司当年写下这些规则时所说明的目的 [7];Google 那条单句标准,只有在 Google 自身的培训体系和工具体系内才成立 [11] |
| 2 | 为什么智能体时代会让情况更糟? | 因为人类读者正越来越缺席,而 PR 描述本身也可能是错的:大多数 AI 政策都允许使用 AI,而据我的解读,它们都是散文式的;并且描述有误的 PR 依然会被合并。 | [1, 2];第 1 集里的覆盖率数字 |
| 3 | 为什么要从数据渲染文档,而不是两份都手写? | 因为同一条规则若手写两份,就是两条会渐渐分歧的规则,而这种分歧本身不会发出任何信号;渲染出来的那份,永远只有一个来源。 | 漂移检查之所以存在,恰恰是因为这一页是被渲染出来的;手写的页面无法与任何东西进行比较 |
| 4 | 为什么这项检查必须跑在 CI 里,而不是放在发布脚本里? | 因为第 2 集的规则同样适用:跑在合并决策看不到的地方的检查,等于没做过检查。发布时才发现的漂移,那时候早就已经合并进去了。 | 这项检查是 CI 里的一个步骤,也是循环审计的一项标准;手动改错的验证,在与 CI 相同的运行方式下,产生了 exit 1 |
| 5 | 为什么每一条豁免和每一个阈值都必须写明理由? | 因为 Shewhart 所说的「受控」,意味着在书面限度内可预测;一个没有理由的限度,只能被推翻,没法被修订,而「推翻」正是散文重新长回数据里的方式。 | [6];阈值文件引用了 2006 年的研究与 Google 的资料来源;策略中的两项豁免各自都写明了理由 |
根子,一句话说完:一条没法做 diff 的规则,就没法证明自己仍然生效;而在一个审查者可能是模型的仓库里,一条无法被证明生效的规则,就不是规则。
30 分钟搭起来:把规则当数据的契约
「30 分钟」是给照抄这份契约的读者留的预算,不是我实测出来的时间。
| 要素 | 规范 |
|---|---|
| 规则文件 | 一份 JSON 文件。每条规则包含:id, level ∈ {block, ai, human},title, source(它源自哪份文档或哪次决定), gate(执行它的脚本或步骤,或者填「human」), check(实际测的是什么)。没有 gate 的规则不算规则;gate 写「none」的规则只是个愿望,愿望归散文管。 |
| 阈值文件 | gate 用来比较的每一个数字,都附一个 _doc 字段,说明其依据。附生成文件的排除清单。gate 脚本里不允许出现数字字面量。 |
| 策略文件 | 响应时限、维护者名单、不计入响应的评论标记、以及从 id 映射到书面理由的豁免表。加载器会拒绝空理由;有一项自测能证明这一点。 |
| 渲染器 | 一条命令,从规则文件打印出给人看的表格。文档页面里有两个标记;表格就活在两者之间;除此之外别无他物。 |
| 漂移检查 | 一条命令,重新渲染并比对两个标记之间的文本。不一致 ⇒ 打印“请重新生成”的提示,退出码为 1。在每次 PR 的 CI 中运行。 |
| 消费者 | AI 审查者根据规则文件构建它的提示词。各道 gate 加载阈值。响应机器人加载策略。它们谁都不持有副本。 |
| 证明 | 在检查被正式启用之前,先手动改一处标记之间的 id,跑一次检查,记下退出码 1;再恢复原状,记下退出码 0。把这两个退出码都写进变更日志。 |
| 刻意不做的事 | 没有规则引擎,没有 schema 语言,没有 YAML 锚点,除了一张表格之外没有任何模板化。每多一样,规则就多一处可能安放的地方。 |
# The whole contract fits in the shape of the file and one comparison (ids real; text abridged).
{
  "rules": [
    {"id": "G1",  "level": "block", "title": "tenant isolation + write permission",
     "source": "AGENTS S1/S2", "gate": "check_tenant_perm.py", "check": "every query filtered by company; every write behind a role"},
    {"id": "R12", "level": "ai",    "title": "loop engineering",
     "source": "docs/05 §8.24 · proposal §3.4", "gate": "ai_review.py", "check": "does the change close a loop or open one?"},
    {"id": "H1",  "level": "human", "title": "business scenario",
     "source": "docs/01", "gate": "human", "check": "domain co-founder only"}
  ],
  "auto_merge": {"allow_prefixes": ["docs/", "plan/"], "deny_prefixes": [".github/", "scripts/"]}
}

# ai_review.py --check-doc
rendered = render_rules(load("scripts/ai_review_rules.json"))
current  = between(DOC.read_text(), "<!-- rules:begin -->", "<!-- rules:end -->")
sys.exit(0 if rendered.strip() == current.strip() else 1)   # different ⇒ red
同一个故事,五位读者,五条出路
| 读者 | 唯一的决定 | 唯一的行动 |
|---|---|---|
| 学生 | 一条你没法核查的规则,只是建议。 | 从你遵循的任意一份指南里挑一条规则,把它写成 id、level、gate、check 这四项。 |
| 工程师 | 数据优先;散文是渲染出来的。 | 把你的审查规则搬进一个文件,从中生成文档表格,再往 CI 里加一道“比对后报错退出”的检查。 |
| 创始人 | 你的 AI 政策还是一段散文,而散文扛不住洪流。 | 问一句:你现在的贡献规则里,哪些是脚本今天就能核查的?把它们本周就写进文件。 |
| 高管 | 1956 年,是规则离开工程师脑袋的那一年。 | 去看看你的评审规则住在哪个文件里。如果答案是一份文档,那你手上的是图表,不是规则。 |
| 投资人 | 一个团队的规则如果有计数,就有了一条你能读出来的趋势线。 | 问一问:这个团队有多少条评审规则,这个数字最后一次变动是什么时候。 |
模式、反模式,与第一性原理
站住脚的模式。 每种规则一个文件。每条规则六个字段,gate 和来源必填。阈值都注明依据。豁免条目不写理由就无法成立。渲染出的页面夹在标记之间。一个负责比对并退出的检查。检查被信任之前,先有一次手动改错的证明。
被取代的反模式。 一份列着规则、却没有脚本去执行的贡献指南。只作为 gate 脚本里常量存在的规模限制。一段把指南转述了一遍的评审者提示词。一张本该手打、却无从比对的文档表格。
机制,命名之。 每条规则都只有唯一一份拷贝,它的其他一切呈现形式都是这份拷贝的函数;漂移检查就是把这个函数应用两次再做比对,二者若有差异,只说明一件事:有人绕过了这个函数。
第一性原理,一句话说完。 规则,就是那个你能拿去做 diff 的东西;除此之外的一切,都只是对它的注解。
现实任务
第 2 集承诺,到第 3 集时循环审计将在一条绿色的主分支上重新跑过一遍,并提交报告。已完成:审计随第一份报告一并合并,它自身的两个静默默认值当天就被修复,主分支的运行结果转绿,刷新后的报告落在了一个纯文档 PR 里——信封正确地对它分类,最终由人类完成合并。21 项标准通过,无一项失败,2 项仍未测量:AI 依然没有测量过一个 PR,Tier-1 也依然没有合并过一个。三位联合创始人的 PR 仍旧挂着「首次响应」标签,看板上也依然如实写着。
| 本季记分牌 | 第 1 集(2026-09-09,UTC 14:00) | 现在(2026-09-09,UTC 17:00) |
|---|---|---|
| 尚无首次响应的最旧未关闭 PR | 57 小时(三个 PR) | 仍是那三个;已打标签,挂在看板上 |
| 带有自检、能证明自己会变红的 gate 数量 | 0/6 | 9/9,正是审计 S5 标准所枚举的那九个,由 CI 中的一个 runner 强制执行 |
| 自 9 月 1 日以来携带追溯标记(trace trailer)的智能体辅助提交 | 尚未测量 | 21 项中已有 11 项;溯源闸门现已要求新提交必须携带 |
| 尚未测量的审计标准 | 尚未形成审计 | 23 项中有 2 项,均等待代码之外的事项 |
到第 4 集时,规则文件里的自动合并信封将已针对一个真实的仅改文档的 PR 完成测试,分支保护状态也会被如实报告:在免费方案下,该信封能分类却尚不能合并,文章会说明具体是哪种情况。
下一步阅读
本集是ANDON · 智能体化 PR 审查与 CI/CD系列第 3 集。每个数字都在出现处标明了适用范围;厨房只是一个类比模型,不是一次测量。三份数据文件、渲染器、检查脚本以及那次手改验证,都存在于一个私有仓库中;它们的结构已在本文的「契约」部分复现,因此读者无需访问该仓库也能理解。本集引用的四视界档案记录在作品集(portfolio)的 plans 目录中。
参考文献
- Hora, Robbes, Zacchiroli, "We Permit the Use of AI, but […]"(中译:我们允许使用 AI,但……),arXiv:2609.07542,2026-09-07。arxiv.org
- Gong 等人,《智能体撰写 PR 中的消息—代码不一致》,arXiv:2601.04886,2026-01-08。 arxiv.org
- Roser, 《230 Years of Interchangeable Parts》,AllAboutLean,2015-07-08。 allaboutlean.com
- Raber、Malone、Gordon、Cooper, 《Conservative Innovators and Military Small Arms: Springfield Armory 1794–1968》,NPS 1989/2006,第138页。 npshistory.com
- Science Museum Group, 《Whitworth standard wire gauge》,编号 co59414。 collection.sciencemuseumgroup.org.uk
- Shewhart, 《Economic Control of Quality of Manufactured Product》,Van Nostrand,1931(archive.org 扫描版)。 archive.org
- Western Electric 规则,Wikipedia(引自 Western Electric 《Statistical Quality Control Handbook》, 1956). en.wikipedia.org(二手资料;原手册未能取得)
- Juran Institute, 《History of Quality Management System》. juran.com
- Quality Digest,《ISO 9001 二十五年》, 2012-04-12. qualitydigest.com
- 《哈佛校报》报道 Haynes 等人,NEJM 360:491-9,2009-01。news.harvard.edu
- Google 工程实践,《代码审查的标准》. google.github.io
- 《Google 软件工程》,第 9 章,代码审查,2020。abseil.io