AI-네이티브 시리즈 · ANDON · 에이전트형 PR 리뷰와 CI/CD · 1화/5화
PR 폭증은 측정되는 것이지 체감되는 것이 아니다
에이전트형 PR 리뷰와 CI/CD 1화. GitHub에서 병합된 풀 리퀘스트는 코딩 에이전트가 등장한 몇 년 사이 세 배 넘게 늘었다. 스스로를 측정한 한 회사에서는 휴먼 리뷰가 좁은 파이프가 되었고, 이번 달에는 AI가 필수 승인자로 인정받게 되었다. 이번 화에서는 이 폭증에 숫자와 N, 날짜를 붙이고, 지난 30일간 무엇이 바뀌었는지 밝히며, 다섯 번의 왜(why)를 통해 사람이든 모델이든 어떤 리뷰어보다 머신 게이트가 먼저 와야 하는 이유를 설명한다.
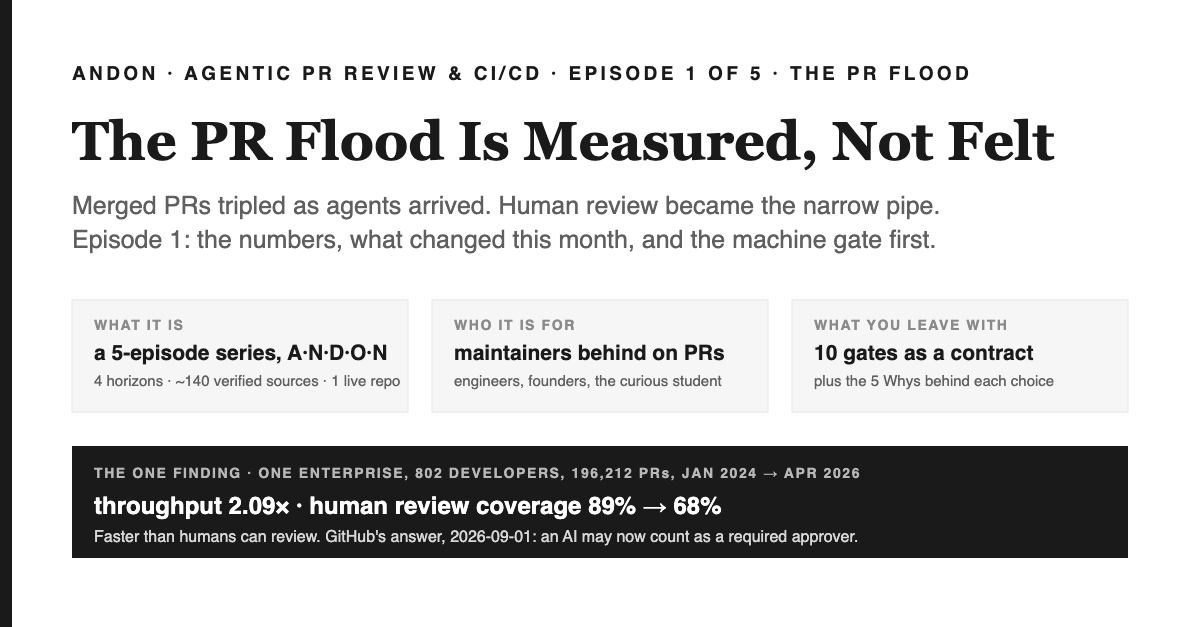
1분 요약 — 읽고 나면 무엇을 얻는가
이 글의 정체. ANDON 5부작 시리즈의 1화이며, 에이전트형 PR 리뷰와 CI/CD를 다룬다. 네 개의 시간 지평(30일, 30개월, 30년, 300년)에 걸친 리서치를 마친 뒤, 실제 레포지토리에 게이트를 구축하는 과정에서 쓴 글이다. 이번 화는 PR 홍수 그 자체다. 규모가 얼마나 큰지, 어디에서 측정했는지, 지난 한 달간 무엇이 바뀌었는지, 그리고 첫 번째 게이트가 왜 의견을 갖지 않는 기계여야 하는지.
왜 중요한가. 엔지니어에게는: 병목이 코드를 작성하는 일에서 그것을 판단하는 일로 옮겨갔고, 그것을 판단하는 도구들이 이제 머지 버튼을 누르도록 허용되었다는 것. 창업자에게는: 리뷰 역량이 에이전트를 얼마나 빨리 풀어놓을 수 있는지를 좌우하는 제약이며, 이는 자신의 레포지토리에서 5분이면 읽어낼 수 있는 숫자라는 것. 학생에게는: 이것이 바로 데이터 속에서 "제약이 옮겨갔다"는 것이 어떤 모습인지 보여주는 사례이며, 그에 대한 가장 오래된 답은 1821년의 철제 마개 한 쌍이라는 것.
읽고 나서 할 수 있는 일. 세 가지 명령으로 자신의 홍수를 측정하고, 열 가지 기계 게이트 중 무엇이 빠져 있는지 판단한 뒤, 아래의 30분 계약서로 그것들을 설치한다. 그런 다음 2화부터 5화까지 읽으며 AI 리뷰어를 신뢰할 수 있게 만드는 네 가지 규칙을 확인한다: 결코 침묵하지 않기, 산문이 아닌 데이터, 봉투 안에서만, 네거티브 테스트.
ANDON — 시리즈 줄기
- A · Assess — PR 홍수는 측정되는 것이지 느껴지는 것이 아니다 이번 화
- N · 침묵하지 않음 — 저장소를 위한 지도카 2화
- D · Data, not prose — 어긋날 수 없는 규칙 3화
- O · 경계선 내부에서만 — 영향 범위는 경로 목록으로 정한다 4화
- N · 네거티브 테스트 — 게이트는 반드시 실패(레드)를 경험한 뒤에만 설치된다 5화
이 시리즈가 다루는 것, 그리고 PR 홍수가 왜 1화인가
코딩 에이전트가 풀 리퀘스트를 연다. 그것도 아주 많이. 예전에는 일주일에 인간이 올리는 PR이 몇 개뿐이던 레포지토리가 이제는 Copilot의 코딩 에이전트, Codex, Claude Code, Cursor, Devin으로부터 수십 개를 받는다. 하나같이 공손하고, 하나같이 그럴듯하며, 하나같이 누군가 승낙해주기를 기다리고 있다. 이 시리즈는 그 PR들과 메인 브랜치 사이에 무엇이 서 있는지를 다룬다: 기계 게이트, AI 리뷰어, 머지 큐, 그리고 끝까지 인간의 몫으로 남아야 할 단 하나의 결정. 이는 밀린 일에 쫓기는 메인테이너, 무엇을 자동화할지 결정해야 하는 엔지니어, 무엇을 신뢰할지 결정해야 하는 창업자, 그리고 실제 데이터 속에서 제약이 옮겨가는 모습을 보고 싶은 학생들을 위해 쓰였다.
이름은 도요타의 끈에서 왔다. 도요타 생산라인에서는 어떤 작업자든 무언가 잘못되었을 때 안돈 끈을 당겨 생산을 멈출 수 있으며, 그 끈이 신뢰받는 것은 오직 그것이 자주 당겨지기 때문이다. 다섯 글자는 다섯 가지 규칙이고, 각각이 하나의 에피소드이며, 각각은 이미 내가 공동으로 구축하는 비공개 제조업 품질관리 레포지토리에서 실제로 시행되고 있다. 이 시리즈의 게이트들은 바로 그 연구 과정에서 설치되었다: AA—숫자로 먼저 홍수를 진단한 뒤 게이트를 고른다; NN—실행되지 못한 게이트는 결코 침묵하지 않고 PR에 그 사실을 알린다; DD—규칙은 산문이 아니라 데이터로 존재하며, 하나의 파일에 살아 있고 드리프트 검사를 받는다; OO—AI는 오직 경로 봉투 안에서만 머지를 일으킬 수 있다; Negative test, 초록불을 신뢰하기 전에 일부러 코드를 당겨 본다.
이번 편이 1화인 이유는 이후의 모든 선택이 규모에 달려 있기 때문이다. 일주일에 PR 다섯 건을 처리하도록 설계된 게이트와 쉰 건을 처리하도록 설계된 게이트는 서로 다른 물건이다. 그리고 조사 과정에서 직관을 믿어서는 안 될 구체적인 이유가 하나 발견됐다: 자료집에 실린, 경력 있는 개발자를 대상으로 한 AI 코딩 도구 무작위 대조 시험 단 한 건에서, 참가자들은 도구 덕분에 자신이 약 20퍼센트 빨라졌다고 믿었지만 실제로는 19퍼센트 느려진 것으로 측정됐다. 느낌은 측정이 아니다. 그래서 이번 편은 우선 N과 날짜가 딸린 숫자부터 다루고, 그다음 병합 버튼을 바꿔놓은 지난 30일, 그다음 이 시리즈 전체를 관통하는 그림 한 장, 그다음 실전 사례, 마지막으로 머신 게이트를 맨 앞에 두는 이유를 밝히는 다섯 번의 '왜'로 이어진다.
숫자로 본 홍수
숫자는 세 종류가 존재하며, 서로 일치하지 않는다는 것 자체가 발견이다. 플랫폼 집계, 기업 내부 현장 연구, 통제된 실험은 각각 서로 다른 것을 측정하므로, 표는 각 숫자에 그 범위를 함께 적어 둔다.
| 측정 대상 | 수치 | 범위와 날짜 |
|---|---|---|
| GitHub의 월간 병합 pull request 수 | 약 2,500만 건 → 9,000만 건 이상 (3.6배) | 플랫폼 전체, 2023년 1월부터 2026년 중반까지, GitHub 공식 블로그, 2026-06-18 [1] |
| 1년간 병합된 pull request 수 | 518.7M (+29%) | Octoverse 2025, 2025-10-28; Copilot 코딩 에이전트만으로도 첫 다섯 달 동안 100만 건 이상의 PR을 열었다 [2] |
| 한 기업에서 주당 완전 에이전트 작성 PR 병합 건수 | 1,000건 이상 | Stripe, 2026-02-09; 사람이 검토, "사람이 작성한 코드 없음" [3] |
| "2배" 목표치 하에서의 1인당 처리량 | 2.09× | 한 기업, 개발자 802명, PR 196,212건, 2024년 1월부터 2026년 4월까지 [4] |
| 동일 연구에서 사람의 리뷰를 최소 한 번 이상 받은 PR 비율 | 89% → 68% | 동일 기업; 같은 기간 동안 AI 리뷰 커버리지는 약 19%에서 84%로 상승 [4] |
| CLI 코딩 에이전트 도입 후 개발자 1인당 병합 PR 수 | +24% | 수만 명의 Microsoft 엔지니어, 관찰 연구, 2026-07-01 [5] |
| AI 도구를 사용한 작업 완료 시간, 무작위 배정 | −19% (더 느려짐); 개발자들은 약 +20%로 믿었음 | 경력 있는 오픈소스 개발자 16명, 작업 246건, 2025년 초; 2026년 2월에 보고된 재실험에서는 신규 참가자 대상으로 −4%(구간 폭이 넓음)가 나왔고, 저자들은 선택 편향 문제로 설계를 변경했다 [6, 7] |
| 코딩 에이전트 흔적이 보이는 프로젝트 | 22–29% | GitHub 프로젝트 128,018개, 2026-01-26 [8] |
| 에이전트별로 나눈 PR 승인률 | 68–80% | PR 7,156건: Codex 79.9%, Cursor 74.4%, Claude Code 72.6%, Devin·Copilot 68.0%, 2026-02-09 [9] |
| 설명과 코드가 어긋나는 에이전트 PR | PR의 1.7%가 심하게 불일치; 이런 PR은 병합률 28.3%(정상은 80.0%)에 그치고 처리 시간은 3.5배 | 에이전트 PR 23,247건, 2026-01-08 [10] |
| 두 에이전트가 겹치는 PR에서 동시에 활동한 레포지토리 | 40.2%; 에이전트 간 충돌률 41.7% (동일 에이전트 내부는 19.8%) | 에이전트 PR 33,596건, 레포지토리 2,807개, 2026-07-06 [11] |
| 메인 브랜치 파손률, AI 지원 여부별 | 1.9% vs 4.4% | 머지 큐를 쓰는 477개 조직, 병합 20만 건 이상, 2026-07-27; 큐의 94%는 한 번에 PR 한 건씩 처리 [12] |
이 표는 결론이 아니라 형태로 읽어야 한다. 플랫폼 전체로 보면 물량이 세 배로 늘었고, 스스로를 꼼꼼히 측정한 그 한 회사 내부에서는 두 배로 늘었다. 같은 회사에서 그 물량 중 실제로 사람이 리뷰한 비율은 5분의 1만큼 줄었고, 반면 모델이 리뷰한 비율은 5분의 1에서 대부분으로 늘었다. 에이전트가 낸 PR은 에이전트와 작업 종류로 나누어 보면 사람과 비슷한 비율로 수용되지만, 실패하는 PR들은 더 크고, 더 많은 파일을 건드리고, CI에서 실패하거나, 디프가 실제로 하지 않은 일을 설명에 적어 놓은 경우다. 그리고 이 중 어느 것이든 개인을 실제로 더 빠르게 만드는지에 대한 통제된 증거는, 좋게 말해도 아직 정리되지 않았다: 무작위 대조 시험은 오히려 느려졌다는 결과를 냈고, 그 저자들은 이후 개발자들이 AI 미사용 조건을 거부하는 바람에 실험 설계 자체가 버티지 못한다고 밝혔다.
회사 단위의 숫자야말로 메인테이너가 실감하는 숫자다. CodeRabbit은 2026-08-26에 공개 레포지토리를 위한 무료 리뷰 1,000만 달러어치를 발표하면서 이를 한 문장으로 압축했다:
"AI has completely collapsed the cost of producing a contribution, shifting the great bottleneck of software development from generating code, to judging it."(번역: AI는 기여물을 만들어내는 비용을 완전히 무너뜨렸고, 그로 인해 소프트웨어 개발의 거대한 병목은 코드를 생성하는 일에서 그것을 판단하는 일로 옮겨갔다.)
— CodeRabbit, 2026-08-26 [13]
curl의 메인테이너는 받는 쪽에서 같은 현상을 측정했다: 2025년 보안 제보 중 약 20퍼센트가 AI 슬롭(AI slop)이었고 약 5퍼센트만 진짜였으며, 2026년 1월 이 프로젝트는 유효 제보율이 5퍼센트 밑으로 떨어지자 버그 바운티를 종료했다 [14, 15].
지난 30일 사이 바뀐 것들
연구 조사 기간은 2026-09-09에 마감되었는데, 그 바로 전 한 달 사이 머지 버튼 자체가 바뀌었다.
- 2026-09-01: AI가 필수 승인자로 인정될 수 있게 됐다. GitHub의 Copilot 코드 리뷰는 이제 레포지토리의 필수 승인 규칙을 충족시키는 승인 리뷰를 제출할 수 있다. 기본값은 꺼져 있으며 엔터프라이즈, 조직, 레포지토리 단위로 설정할 수 있고, 새로운 푸시가 있으면 사람의 승인과 마찬가지로 무효화된다. GitHub 자신의 표현은 이 구분을 분명히 남겨 두었다: "An approval assessment alone does not count toward merge requirements."(번역: 승인 평가 하나만으로는 병합 요건을 충족하지 못한다.) [16] 그보다 닷새 앞서 Copilot은 봇이 작성한 PR도 리뷰하기 시작했고 300개 파일 상한도 없앴다 [17].
- 2026-09-02: PR을 연 에이전트가 이제 그것을 직접 착륙시킨다. Agent Merge는 공개 프리뷰 상태로, PR이 머지 가능해질 때까지 "address review feedback, fix failed checks and merge conflicts, and rerun workflows"(번역: 리뷰 피드백을 반영하고, 실패한 체크와 머지 충돌을 고치고, 워크플로를 재실행한다)를 수행한다 [18, 19]. Cursor는 2026-08-19에 그 대응물을 출시했다: 클라우드 에이전트는 "automatically subscribe to PRs they create and drive them to completion, fixing CI and addressing bot comments"(번역: 자신이 만든 PR을 자동으로 구독해 완료 상태까지 밀어붙이며, CI를 고치고 봇 코멘트에 대응한다) [20].
- 리뷰의 가격이 이제 라벨에 붙는다. Copilot 리뷰 한 건은 "Lite" 강도에서 AI 크레딧 $0.05~$1, "Balanced"에서 $0.25~$5로 추산되며, 기본값은 2026-09-28에 Balanced로 바뀐다 [21, 22]. Anthropic의 매니지드 Code Review는 건당 평균 $15~$25가 들고, 약 20분이 걸리며, 의도적으로 차단형이 아니라 중립적 체크로 결과를 보고한다 [23].
- 오픈소스 AI 정책에 대한 최초의 전수조사. GitHub 상위 2,000개 레포지토리의 정책 281건 중 83.3%가 기여물에서 AI를 허용하거나 권장하고, 14.9%는 금지하며, 48.8%는 공개를 요구하고, 67.3%는 높은 수준의 인간 관여를 요구한다 (arXiv, 2026-09-07) [24]. Debian은 2026-08-30에 허용 쪽으로 투표했다; GCC는 "legally significant"(번역: 법적으로 유의미한) LLM 유래 기여를 거부하는데, 그 기준을 정책상 대략 15줄로 잡는다; 리눅스 커널은
Assisted-by:트레일러는 받아들이지만 서명은 오직 인간만 할 수 있다고 고집한다 [25, 26, 27]. - 자본은 생성이 아니라 거버넌스로 향했다. CodeRabbit은 2026-08-12에 "Agentic Change Management"를 위해 15억 달러 밸류에이션으로 1억 4,300만 달러를 유치했고, Qodo의 2.8 및 2.9 릴리스(2026-08-16, 2026-09-07)는 리뷰·룰·이슈 해결을 Claude Code, Codex, Kiro 내부로 옮기면서 PR마다 "blast radius" 위험 등급을 매기게 했으며, Mergify는 2026년 8월 changelog에서 스택형 PR에 대한 머지 큐 지원을 추가했다 [28, 29, 30].
이 모두를 합쳐 보면, 코드를 작성하는 도구들이 이제 그것을 리뷰하고, 승인하고, 체크를 고치고, 머지까지 할 수 있으며, 그것을 허용할지 말지는 레포지토리 설정값의 문제가 되었다는 뜻이다. 그 설정 자체가 곧 설계이며, 이것이 다음 네 편이 다루는 주제다.
다섯 편을 관통하는 그림 하나: 주방의 세 단계 검사
제대로 된 주방에서 접시 하나가 나가려면 세 번의 검사를 통과해야 하는데, 이 셋은 엄격함의 정도가 아니라 종류 자체가 다르다. 저울과 온도계, 티켓 확인이 첫 번째 검사다; 이들에게는 의견이라는 게 없고, 누가 요리했든 무게 미달인 접시는 나가지 못한다. 수 셰프가 맛을 보고 메모를 남긴다, "세 번째 국자에서 소금이 셌다, 내보낼지는 네 판단이다"—이것이 두 번째 검사이며, 메모는 특정 국자를 정확히 지목한다. 셰프가 그 메모를 읽고 그 한 숟갈을 맛본 뒤 내보낼지 말지를 말하는 것이 세 번째 검사다. 수 셰프가 이미 맛을 본 차가운 전채는 셰프 없이도 나갈 수 있는데, 드레싱이 잘못된 건 다시 만들면 되는 문제이지 환불할 일이 아니기 때문이다; 반면 뜨거운 요리는 언제나 기다린다.
| 주방 | 레포지토리 | 에피소드 |
|---|---|---|
| 저울: 의견이 없고, 무게 미달은 결코 나가지 못한다 | 머신 게이트 G1부터 G10까지: 모든 쓰기 경로에 대한 테넌트 필터와 권한 검사, 시크릿 형태 금지, 모델 변경 시 마이그레이션 필수, 모든 id 컬럼의 외래키화, 이중언어 문서 동시 갱신, 테스트, 골든 케이스, 출처 추적, 크기, 그리고 모든 게이트가 실제로 빨간불을 낼 수 있어야 한다는 조건 | 1편과 5편 |
| 주방 자체의 정지 장치: 스프링이 끊어지면 멈추는 방적기, 그리고 추측 대신 "저울이 고장났다"고 말하는 요리사 | 실행되지 못한 게이트나 리뷰어는 PR에 "unmeasured"(측정 불가)라고 표시된다; 아무도 기억해내지 않아도 되는 응답 시간 감시 봇 | 2 |
| 누구나 똑같이 읽는 레시피 카드 | 규칙은 데이터로 한 파일에 담겨 문서와 리뷰어 프롬프트에 그대로 반영되고, CI에서 드리프트를 검사받는다 | 3 |
| 차가운 애피타이저는 셰프 없이도 나가지만, 뜨거운 요리는 절대 그렇지 않다 | AI는 자신이 선택하지 않은 경로 범위(path envelope) 안에서만, 다섯 조건 중 하나로서만 머지를 일으킬 수 있다. 애플리케이션 코드, 마이그레이션, CI는 절대 그 범위 안에 들지 않는다 | 4 |
| 서비스 전에 이미 알고 있는 무게를 달아 저울이 제대로 읽히는지 증명하는 일 | 모든 게이트는 심어둔 결함에서 일부러 실패하게 만드는 자체 테스트를 갖추고 있다. 리뷰어는 알려진 결함이 있는 PR에서 실제로 빨간불을 켠 뒤에야 비로소 설치된 것으로 친다 | 5 |
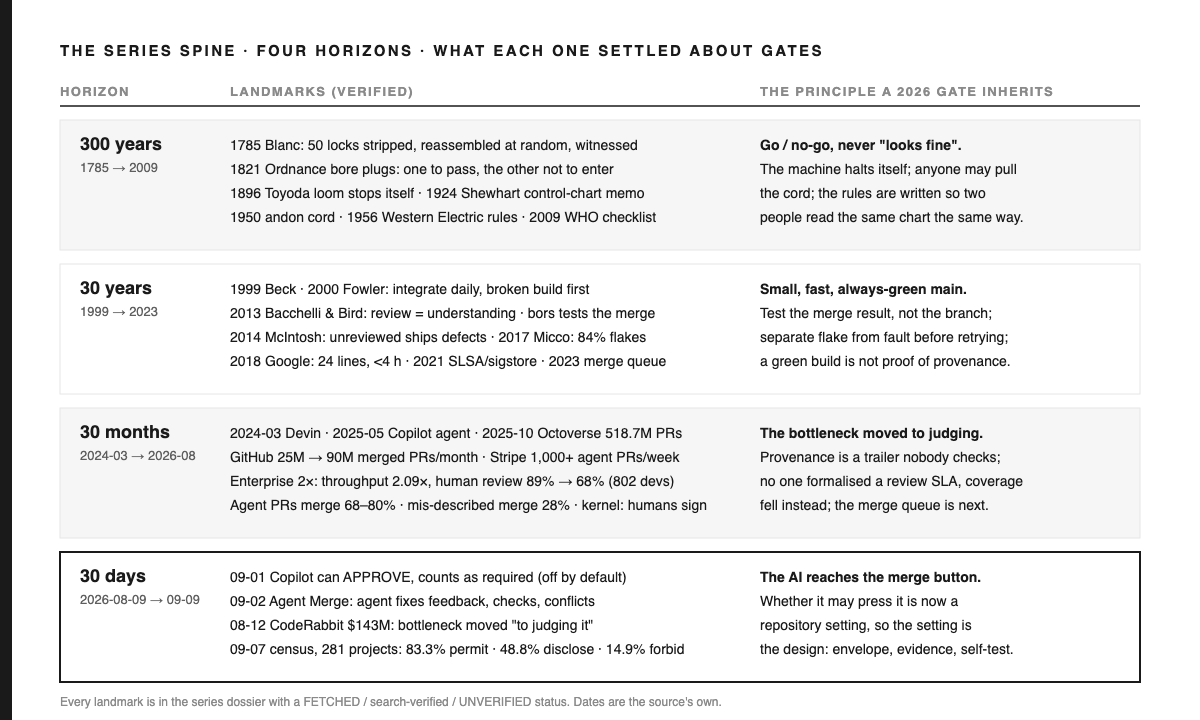
예전 행들을 여기서 언급하는 이유는 이 그림이 본문이 말하지 않는 것을 주장하지 않도록 하기 위해서다. Blanc은 1785년 증인들 앞에서 머스킷 자물쇠 쉰 개를 분해한 뒤 무작위로 고른 부품들로 다시 조립했다 [38] 구글의 2018년 연구는 약 900만 건의 리뷰 대상 변경을 조사해, 수정된 줄 수의 중앙값이 24줄이고 전체 리뷰 지연 시간의 중앙값이 네 시간 미만이라는 것을 밝혀냈다 [39] McIntosh와 동료들은 2014년, 낮은 리뷰 커버리지와 참여도가 컴포넌트당 최대 두 건에서 다섯 건의 출시 후 결함을 추가로 예측한다는 것을 밝혀냈다 [40] Micco는 2017년, 구글에서 발생한 성공-실패 전환의 84퍼센트가 불안정한(flaky) 테스트에서 비롯되었다고 보고했다 [41] SLSA와 sigstore는 2021년 SolarWinds 사태에 대한 대응으로 등장했다 [42] 그리고 2009년 WHO 수술 안전 체크리스트 시험은 여덟 개 병원에서 사망률을 1.5퍼센트에서 0.8퍼센트로 낮췄다 [43] 그림에 남은 나머지 이정표들: Beck은 1999년 지속적 통합(continuous integration)을 익스트림 프로그래밍의 관행으로 명명했고, Fowler는 2000년 그 정전이라 할 만한 설명을 썼는데, 그 규칙은 빌드를 고치는 것보다 더 우선순위 높은 일은 아무도 갖지 않는다는 것이었다 [44, 45]; Rust 프로젝트의 bors 봇은 2013년부터 브랜치가 아니라 머지 결과 자체를 테스트해 왔고, GitHub는 2023년 7월 머지 큐를 정식 기능으로 만들었다 [46, 47]; Devin은 2024년 3월 출시되었고, GitHub의 Copilot 코딩 에이전트는 2025년 5월 퍼블릭 프리뷰에 들어갔다 [48, 49]; 그리고 관리도(control chart)를 제안한 Shewhart의 메모는 1924년 5월 16일자로 기록되어 있다 [50] 각각은 자신이 속한 화에서 다시 등장한다.
실전 사례: 2026년 9월 9일의 한 레포지토리
이 레포지토리는 공장을 위한 품질관리 시스템으로, 모든 기록이 고객 감사에서 증거로 채택될 수 있으며, 머지된 결함은 버그가 아니라 거짓 기록이 되는 곳이다. 이를 유지보수하는 사람은 둘뿐이다: 도메인 공동창업자와 나. 내가 만드는 기여물 대부분은 내가 지휘하는 AI 세션이 산출한 것이다. 이번 화의 리서치가 끝난 날 아침, 나는 누구나 실행할 수 있는 바로 그 세 가지 명령으로 레포지토리의 수치를 읽어보았는데, 그 수치들은 규모만 10분의 1일 뿐 문헌이 보여준 것과 같은 형태를 띠고 있었다.
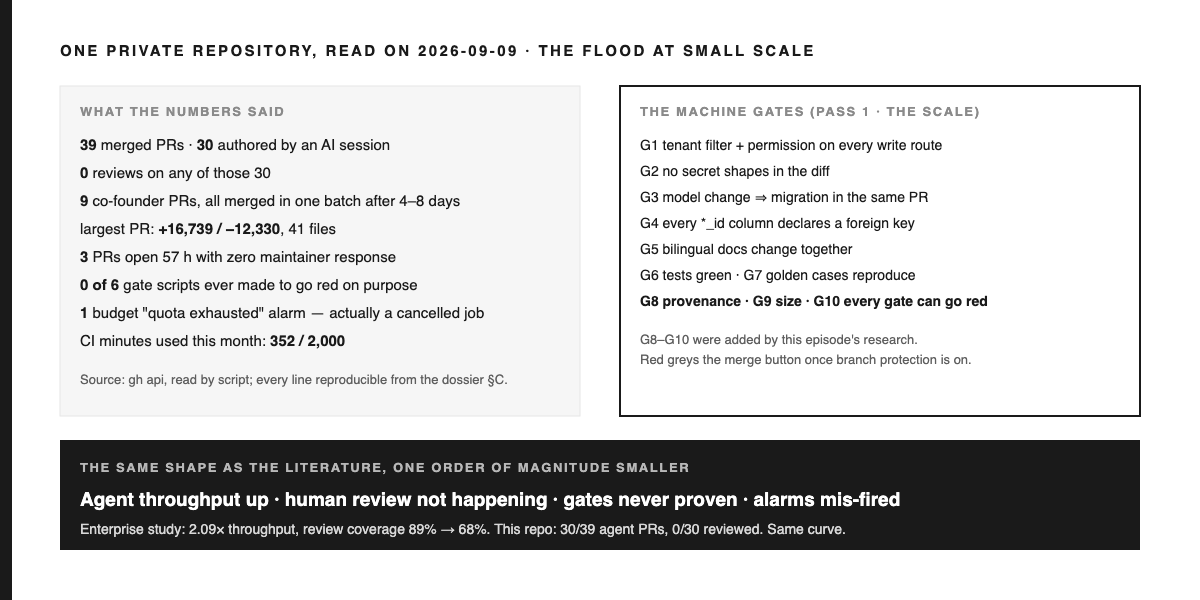
이 시리즈를 뒷받침하는 자료집에는 약 140개의 출처가 있으며, 각각 수집됨(fetched), 검색으로 검증됨(search-verified), 또는 미검증(unverified)으로 표시되어 있다. 그날 레포지토리 자체의 수치는 다음과 같다: 머지된 PR 서른아홉 건, 그중 가장 큰 것은 41개 파일에 걸쳐 +16,739줄과 −12,330줄이 바뀐 UI 리빌드 작업, 그달 CI 분(minutes) 2,000분 중 352분 사용. 서른아홉 건 중 서른 건은 AI 세션이 작성한 것이었고, 그 서른 건 중 어느 것도 리뷰를 받지 않았는데, 그것들을 리뷰할 수 있었을 사람이 바로 그 에이전트를 지휘하던 사람이었기 때문이다. 공동창업자의 아홉 건 PR은 나흘에서 여드레를 기다린 끝에 어느 오후 한꺼번에 머지되었다. 그가 새로 올린 세 건의 PR은 쉰일곱 시간째 열려 있었지만 아무에게서도 응답이 없었다. 여섯 개 게이트 스크립트 가운데 일부러 실패하도록 만들어진 것은 하나도 없었으니, 일곱 번째 게이트인 테스트 스위트 자체가 스크립트가 아닌 유일한 게이트인 셈이었다. 그리고 CI 분 예산을 감시하는 스크립트는, 알고 보니 아홉 초 전에 벌어진 동시성 취소(concurrency cancellation)에 불과했던 작업에 대해 "할당량 소진" 경보를 울렸다.
마지막 줄이야말로 기억해둘 만하다. 오작동하는 탐지기는 아예 없는 것보다 더 나쁜데, 다음 경보가 무시당하게 되기 때문이다. 그리고 이 레포지토리는 이미 8월 말(자체 로그 기준 2026-08-21부터 08-30까지, 11일간)의 대부분을, 아무도 경보를 지켜보지 않는 사이 Actions 분이 소진되어 조용히 죽어버린 CI 때문에 잃은 적이 있었다. 5화는 그 이야기를 다룬다. 2화는 그 쉰일곱 시간을 다룬다. 이번 화가 맡은 일은 그림 오른쪽의 일곱 게이트였고, 리서치는 거기에 세 가지를 더했다: 출처 게이트(provenance gate) — 문헌에 따르면 비공개 머지의 14.4퍼센트에서만 AI 표식이 나타나는데, 이 레포지토리는 아무도 확인하지 않는 관행에 의존하고 있었기 때문이다; 에이전트 지원 PR에 더 낮은 상한을 두는 크기 게이트 — 실패하는 PR은 대체로 규모가 큰 것들이기 때문이다; 그리고 자체 테스트 계약 — 여섯 개 게이트 스크립트 중 단 하나도 빨간불을 켜본 적이 없었기 때문이다.
다섯 번의 '왜': 기계 게이트가 먼저 오는 이유
이 시리즈를 구분 짓는 장치는, 그 답이 취향에서 벗어나 하나의 메커니즘이 될 때까지 같은 질문을 다섯 번 던지는 것이다. 여기 1화의 선택, 즉 어떤 리뷰어보다도 먼저 의견 없는 기계가 첫 번째 통과 절차가 되어야 한다는 선택에 대해 그 질문을 던져본다.
| # | 왜? | 왜냐하면 | 근거 |
|---|---|---|---|
| 1 | 왜 AI 리뷰어를 게이트로 삼으면 안 되는가? | 모델이 diff에 내리는 판정은 확률적이고, 논쟁의 여지가 있는 머지 조건은 결국 기여자들이 논쟁하게 되는 대상이 되기 때문이다. 저울에는 의견이 없다. | 자동화된 리뷰어는 실제 PR에서 "성능이 떨어지며" 설계 문제보다 기능적 오류에 강하다. 실제 산업 현장에 배치된 한 리뷰어는 자신이 단 코멘트의 26.7퍼센트가 낡은(outdated) 것이라고 보고한다 [31, 32] |
| 2 | 왜 머신 게이트가 하필 테넌트 격리, 시크릿, 마이그레이션, 외래 키를 다뤄야 하는가? | 이것들이 품질 시스템에서 거짓 기록을 만들어내는 실패이며, 거짓 기록은 감사가 절대 용납할 수 없는 유일한 결함이기 때문이다. 그리고 이것들은 전부 스크립트로 완전히 판정 가능하다. | 레포지토리 자체의 규칙, 그리고 1821년의 패턴: 보어 플러그는 통과하거나 통과하지 못하거나 둘 중 하나다 [33] |
| 3 | 왜 게이트 결과는 재판정 없이 AI 브리핑에 원문 그대로 첨부되어야 하는가? | 이미 확정된 체크에 대한 두 번째 의견은 잡음일 뿐이고, 그 잡음이야말로 사람들이 브리핑 읽기를 그만두게 만드는 원인이기 때문이다. 인간 리뷰어는 저울을 다시 재는 데가 아니라 이해하는 데 주의를 써야 한다. | Bacchelli와 Bird, ICSE 2013: 리뷰는 "예상보다 결함에 관한 것이 적고"(less about defects than expected) 오히려 이해에 관한 것이다 [34] |
| 4 | 왜 규칙은 데이터로 기록되어야 하는가? | 그렇지 않으면 같은 차트를 보는 두 리뷰어가 서로 다른 판정을 내리게 되는데, 이것이 바로 Western Electric이 1956년 런 규칙(run rules)을 발표함으로써 해결한 문제이기 때문이다. | Western Electric 규칙: "현장 작업자와 엔지니어가 관리도를 일관된 방식으로 해석하도록 하기 위해"(to ensure that line workers and engineers interpret control charts in a uniform way) [35]; 2화 |
| 5 | 왜 게이트는 인정받기 전에 일부러 실패해봐야 하는가? | 한 번도 빨간불이 켜진 적 없는 게이트는 초록불이 켜진 장식품과 구별이 안 되기 때문이며, 이 레포지토리에는 한 달 사이 그런 것이 세 개나 있었다: 설치되지 않았을 때 조용히 건너뛰는 린터, 존재한다고 문서화되어 있었지만 실제로는 한 번도 존재한 적 없는 PR 템플릿 봇, 그리고 8월 말의 소리 없는 CI 침묵일들이다. 방직기가 신뢰받는 이유는 그것이 멈추기 때문이다. | Toyota 자신이 전하는 1896년 씨실 끊김 정지 장치와 1950년 andon 코드 이야기 [36, 37]; 5화 |
근본 원인은 한 문장으로 이렇다.머지 조건은 그 누구도 반박할 수 없는 것이어야 하고, 그것은 곧 기계를 뜻하며, 그 기계는 규칙이 데이터로 기록되어 있어야 하고 '안 된다'고 말할 수 있어야 한다는 것이다. AI 리뷰어가 더하는 모든 것은 이 위에 얹히는 것이지, 이를 대신하는 것이 아니다.
30분 만에 만들기: 계약으로서의 머신 게이트 레이어
30분은 이 계약을 새 레포지토리에 그대로 복사해 적용하는 독자를 기준으로 잡은 예산이지, 내가 실측한 시간은 아니다. 실전 사례의 원래 게이트 일곱 개(스크립트 여섯 개 더하기 테스트 스위트)는 여러 세션이 걸렸고, 새로 추가한 세 개는 리서치를 포함해서 하루가 걸렸다.
| 요소 | 명세 |
|---|---|
| 먼저 측정한다 | 세 개의 명령어, 5분: 작성자·머지 담당자·크기·리뷰 수를 붙여 머지된 PR 목록을 뽑고, 나이와 라벨을 붙여 열린 PR 목록을 뽑고, 결론을 붙여 최근 CI 실행 60건을 뽑는다. 게이트를 손대기 전에 날짜와 함께 그 숫자들을 적어둔다. |
| 입력값 | 머지 베이스 대비 diff, 변경된 파일 목록, (트레일러용) 커밋 메시지, (붙여넣은 증거용) PR 본문. |
| 일곱 가지 게이트, 최소 사양 | G1 모든 쓰기 라우트는 테넌트 필터와 권한 검사를 갖춘다(grep이 아니라 AST 패스로). G2 추가된 줄에 시크릿 형태가 없어야 하며, 위치는 보고하되 값은 절대 그대로 노출하지 않는다. G3 동일 PR에 마이그레이션 없이 모델 변경이 있으면 차단한다. G4 모든 *_id 컬럼은 외래 키를 선언하거나 근거 있는 예외 사유를 명시한다. G5 두 언어로 된 문서는 함께 변경한다. G6 테스트 스위트. G7 결정론적 함수가 표준 출력을 재현해야 하는 골든 케이스 라이브러리. |
| 홍수가 추가하는 세 가지 | G8 출처 증빙: AI 공동저자 마커가 붙은 커밋은 그 세션이나 도구로의 추적 경로도 함께 가져야 하고, 봇은 절대 승인 서명을 할 수 없으며, 에이전트가 관여한 PR은 검증 출력을 반드시 붙여넣어야 한다. G9 크기: 데이터 기반 상한을 넘는 유효 줄 수는 차단하며, 에이전트가 관여한 PR에는 더 낮은 상한을 적용하고 락파일은 제외한다. G10 셀프테스트: 모든 게이트는 심어놓은 결함에 대해 실패할 수 있음을 증명하는 플래그를 노출해야 하고, 러너는 셀프테스트가 없는 게이트가 하나라도 있으면 CI를 실패시킨다. |
| 불변 조건 | 게이트가 빨간불이면 브랜치 보호 하에서 머지 버튼이 회색으로 바뀐다. 어떤 게이트도 조용히 건너뛰지 않는다: 도구 누락, 키 누락, 예외는 항상 빨간불이지 초록불이 될 수 없다. |
| 정지 규칙 | 게이트는 푸시당 한 번만 실행한다. 게이트 내부에 재시도는 없다. 결과가 들쭉날쭉하다면 그것은 반복할 이유가 아니라 고쳐야 할 게이트 결함이다. |
| 데이터로서의 임계값 | JSON 파일 하나: 유효 줄 수 400에서 경고, 3,000에서 차단, 에이전트가 관여한 경우 1,500에서 차단, 60개 파일에서 차단. 이 값을 바꾸는 것도 PR이다. |
| 의도적으로 빠뜨린 것 | 이 레이어에는 AI가 전혀 없다. 아직 플레이키 테스트 격리도 없다. 계획이 브랜치 보호를 뒷받침할 때까지 머지 큐도 없다. 각각은 이 계약의 빈틈이 아니라, 다른 에피소드나 계획 단계에서 결정할 사안이다. |
# Measure first (five minutes, any repo)
gh pr list --state merged --limit 100 --json number,author,mergedBy,additions,deletions,changedFiles,reviews
gh pr list --state open   --json number,createdAt,author,labels,reviews
gh run list --limit 60    --json conclusion,createdAt,updatedAt

# Then the gate layer, one command locally == CI
make gate    # lint · tenant-perm · graph · pr-ready(P1..P6) · selftest · migration · tests · eval
같은 이야기, 다섯 개의 출구
| 독자 | 하나의 결정 | 하나의 행동 |
|---|---|---|
| 학생 | 제약은 글쓰기에서 판단으로 옮겨갔다. 판단하는 법을 배워야 한다. | 공개 저장소에서 하루에 에이전트 PR 하나씩 읽고, 리뷰를 보기 전에 그것이 머지되어야 하는지와 그 이유를 적어본다. |
| 엔지니어 | 게이트를 고르기 전에 홍수부터 측정한다. | 오늘 자기 레포지토리에서 위 세 가지 명령어를 실행하고 그 숫자를 README에 적는다. |
| 창업자 | 몇 개의 에이전트를 굴릴 수 있는지를 좌우하는 것은 모델 품질이 아니라 리뷰 역량이다. | 지난달 머지된 PR 중 사람이 리뷰한 비율이 얼마인지, 그리고 그 수치가 기업이 원하는 방향으로 가고 있는지 물어본다. |
| 임원 | "AI가 승인할 수 있다"는 이제 하나의 설정값이다. 의도를 가지고 결정하라. | 누군가 기본값으로 켜버리기 전에, 그 설정을 누가 소유하는지와 그 범위(envelope)가 무엇인지 물어본다. |
| 투자자 | 돈은 코드 생성이 아니라 변경 관리(governance)로 옮겨갔다. | 팀에게 게이트가 일부러 빨간불이 되는 모습을 보여달라고 요청한다. 그렇게 할 수 있는 팀에게는 프로세스가 있는 것이다. |
패턴, 안티패턴, 그리고 제1원칙
유효했던 패턴들. 어떤 설계보다 먼저 N값과 날짜가 붙은 숫자. 스크립트가 판단할 수 있는 것만 판단하되, 그것은 전부 판단하는 머신 계층. 게이트 결과를 리뷰어의 브리프에 그대로 첨부하기. 데이터 파일에 담긴 임계값. 모든 게이트에 대한 자가 테스트.
이번 연구가 지목한 안티패턴들. 홍수가 느껴지는 대로 믿는 것(무작위 실험이 보여준 20퍼센트의 착각). 확률적으로 판단하는 리뷰어를 머지 조건으로 삼는 것. 아무도 확인하지 않는 출처 표시 관행에 의존하는 것. 대형 에이전트 PR을 대형 인간 PR과 똑같이 취급하는 것. 엉뚱한 지문에 반응해 울리다가 결국 꺼져버리는 알람.
제1원칙, 한 문장으로. 누구든, 무엇이든 어떤 변경을 판단하기 전에, 의견을 갖지 않는 머신이 먼저 그것을 저울질해야 하며, 그 머신은 반드시 '아니오'라고 말할 수 있어야 한다.
현실 점검 미션
에피소드 2가 나올 즈음이면, 실사례 속 레포지토리는 57시간째 열려 있던 세 건의 PR에 대해 새로 만든 응답시간 봇을 처음으로 가동했을 것이고, 그 봇이 붙인 라벨은 자료집(dossier)에 기록되어 있을 것이다. 만약 라벨을 붙이지 못했다면, 에피소드 2는 그 사실 그대로를 말할 것이다.
다음 읽을 글
1화, ANDON · 에이전트형 PR 리뷰와 CI/CD. 모든 숫자는 등장하는 자리에서 범위가 정해져 있다; 주방은 모델일 뿐 측정치가 아니다. 여기서 설명한 게이트, 명세, 테스트는 비공개 레포지토리에 실재하며, 그 형태를 계약서 안에 재현해두었기에 접근 권한이 없어도 무방하다. 이 회차가 인용할 수 있는 4-호라이즌 자료집은 포트폴리오의 plans 디렉터리에 기록되어 있다.
참고문헌
- GitHub, How pull request limits are cutting down the noise, 2026-06-18. github.blog
- GitHub, Octoverse 2025, 2025-10-28. github.blog
- Stripe, Minions: Stripe's one-shot, end-to-end coding agents, 2026-02-09. stripe.dev
- He, Agarwal, Denisov-Blanch, Azaletskiy, Koyejo, Vasilescu, AI Writes Faster Than Humans Can Review: A Longitudinal Study of an Enterprise 2x Mandate, arXiv:2607.01904, 2026-07-02. arxiv.org — 리뷰 커버리지 수치는 해당 연구 자체의 것이며, 함께 인용되는 Microsoft 연구는 [5].
- Murphy-Hill, Butler, Savelieva, Adoption and Impact of Command-Line AI Coding Agents, arXiv:2607.01418, 2026-07-01. arxiv.org
- METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, 2025-07-10. metr.org
- METR, We are Changing our Developer Productivity Experiment Design, 2026-02-24. metr.org
- Robbes, Matricon, Degueule, Hora, Zacchiroli, Agentic Much? Adoption of Coding Agents on GitHub, arXiv:2601.18341, 2026-01-26. arxiv.org
- Pinna, Gong, Williams, Sarro, Comparing AI Coding Agents: A Task-Stratified Analysis of PR Acceptance, arXiv:2602.08915, 2026-02-09. arxiv.org
- Gong, Pinna, Bian, Zhang, Analyzing Message-Code Inconsistency in Agent-Authored PRs, arXiv:2601.04886, 2026-01-08. arxiv.org
- Xu, Subramanian, Karthik, AI Agent PRs on GitHub: Frequency, Structure, and Merge Conflict Rates, arXiv:2607.04697, 2026-07-06. arxiv.org
- Mergify, State of Merge Queues 2026, 2026-07-27. mergify.com
- CodeRabbit, CodeRabbit commits more than $10 million to open source, 2026-08-26. coderabbit.ai
- Daniel Stenberg, Death by a thousand slops, 2025-07-14. daniel.haxx.se
- Daniel Stenberg, The end of the curl bug-bounty, 2026-01-26. daniel.haxx.se
- GitHub Changelog, Copilot code review can now approve pull requests, 2026-09-01. github.blog
- GitHub Changelog, Copilot code review: Resolution reasons and expanded capabilities, 2026-08-27. github.blog
- GitHub Changelog, GitHub Copilot weekly releases: August 31, 2026-09-04. github.blog
- Microsoft, Visual Studio Code 1.136, 2026-09-02. code.visualstudio.com
- Cursor, Cloud Agents and Cursor Harness Improvements, 2026-08-19. cursor.com
- GitHub Docs, Copilot code review (개념). docs.github.com
- GitHub Changelog, Upcoming changes to GitHub Copilot policies and billing, 2026-08-28. github.blog
- Anthropic, Code Review, Claude Code 문서. code.claude.com
- Hora, Robbes, Zacchiroli, "We Permit the Use of AI, but […]": The Landscape of AI Policies in Popular Open Source Projects, arXiv:2609.07542, 2026-09-07. arxiv.org
- The Register, Debian votes to let contributors code with AI, 2026-08-30. theregister.com
- LWN.net, GCC steering committee announces AI policy, 2026-07-29. lwn.net
- Linux kernel documentation, Using AI coding assistants in Linux kernel development. docs.kernel.org
- SiliconANGLE, CodeRabbit bags $143M to help companies get a grip on the explosion of AI-generated code, 2026-08-12. siliconangle.com
- Qodo, What's new, 릴리스 2.8(2026-08-16) 및 2.9(2026-09-07). docs.qodo.ai
- Mergify, Changelog, 2026-08-12부터 2026-09-08까지의 항목. docs.mergify.com
- Zeng et al., SWR-Bench: Assessing LLM Performance in Real-World Code Review Comment Generation, arXiv:2509.01494. arxiv.org
- Sun et al., BitsAI-CR: Automated Code Review via LLM in Practice, arXiv:2501.15134, 2025-01-25. arxiv.org
- Raber, Malone, Gordon, Cooper, Conservative Innovators and Military Small Arms: An Industrial History of the Springfield Armory, 1794–1968, U.S. National Park Service, 1989/2006, p. 138. npshistory.com
- Bacchelli, Bird, Expectations, Outcomes, and Challenges of Modern Code Review, ICSE 2013, 저자 사본. sback.it
- 웨스턴 일렉트릭 규칙, 인용: Statistical Quality Control Handbook, 1956. en.wikipedia.org (2차 자료; 1956년 핸드북 원본은 확인하지 못함)
- Toyota Motor Corporation, Toyota Production System. global.toyota
- Toyota UK, TMUK's 25 Objects – Andon Cord, 2017-12-11. mag.toyota.co.uk
- Roser, 230 Years of Interchangeable Parts – A Brief History, AllAboutLean, 2015-07-08. allaboutlean.com
- Sadowski, Söderberg, Church, Sipko, Bacchelli, Modern Code Review: A Case Study at Google, ICSE-SEIP 2018, 저자 사본. sback.it
- McIntosh, Kamei, Adams, Hassan, The Impact of Code Review Coverage and Code Review Participation on Software Quality, MSR 2014. rebels.cs.uwaterloo.ca
- Micco, The State of Continuous Integration Testing @Google, ICST 2017 기조연설. aster.or.jp
- Google Security Blog, Introducing SLSA, an End-to-End Framework for Supply Chain Integrity, 2021-06-16. security.googleblog.com
- Harvard Gazette, Surgical safety checklist drops deaths and complications by more than one-third, 2009-01, Haynes 외, NEJM 360:491-9 보도. news.harvard.edu
- Beck, Extreme Programming Explained: Embrace Change, Addison-Wesley, 1999 (도서 목록 기록). books.google.com
- Fowler, Continuous Integration, 2000, revised 2006 and 2024. martinfowler.com
- Wilson, Rust infrastructure can be your infrastructure, 2015-03-17. huonw.github.io
- GitHub Changelog, Pull request merge queue is now generally available, 2023-07-12. github.blog
- Cognition, Introducing Devin, 2024-03-12. cognition.com
- GitHub Changelog, GitHub Copilot coding agent in public preview, 2025-05-19. github.blog
- Best, Neuhauser, Walter A Shewhart, 1924, and the Hawthorne factory, Quality & Safety in Health Care, 2006. pmc.ncbi.nlm.nih.gov